In dem Beitrag Menschliches Lernen und Maschinelles Lernen unterscheiden sich wurden die Unterschiede zwischen dem Lernen von Maschinen und dem Lernen von Menschen deutlich. In der Diskussion um Künstliche Intelligenz gibt es allerdings weitere Begriffe, die verwechselt werden. Ich vermute, dass das oft absichtlich passiert, um Maschinen immer mehr an den Menschen zu adaptieren, bis zu einem Grad in dem „eine generelle Intelligenz (AGI: Artificial General Intelligence“ alles übernimmt. Mit solchen Storys von Big Tech wird viel Geld eingesammelt.
Schauen wir uns nun zwei weitere Begriffe an, die immer wieder verwechselt werden: Vorhersagen und Erklären.
Wenn wir an große Datenmengen wie Large Language Models (LLMs) denken, so entstehen Ergebnisse in den KI-Modellen aus der Vorhersage des nächsten Buchstabens, Wortes oder Aussagen. So eine Vorhersage (Prognose) kann schnell mit dem menschlichen Erklären verwechselt werden. In dem folgenden, lesenswerten Paper wird das ausführlich – auch in Bezug zu anderen Themen – erläutert;
Knauff et al. (2026): Vorhersage ist nicht Erklärung. Eine Perspektive der Fachgruppe Allgemeine Psychologie (gemeinsam mit der Gesellschaft für Kognitionswissenschaft), Psychologische Rundschau, vol. 77, no. 4, pp. 225–231, Oct. 2026, doi: 10.1026/0033-3042/a0007811
„Erklärung ist mehr als Prognose. Eine Theorie beschränkt sich nicht darauf, zukünftige Ereignisse korrekt vorherzusagen; sie macht die Struktur des zugrunde liegenden Mechanismus explizit und nachvollziehbar. Genau hier verläuft die entscheidende Differenz zwischen datengetriebener KI und psychologischer Theoriebildung“ /ebd.).
„Unsere These lautet: Auch beeindruckende Performanz ersetzt keine mechanistische Theorie psychologischer Prozesse. Vorhersage ist nicht Erklärung“ (ebd.).
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
In verschiedenen digitalen Räumen stellen sich Personen unterschiedlich dar, wobei diese Darstellung nicht unbedingt der digitalen Person (Persönlichkeit) entsprechen muss. Laura Robinson (2007) hat beispielsweise argumentiert, dass „das Subjekt anhand der digitalen Elemente ein „self-ing“ betreibe und sich sodann als „Cyberself“ (2007, S. 98) hervorbringe. Das Cyberself sei ein ephemeres Selbst, so Robinson, welches nur für kurze Zeit beständig, rasch änderbar und ohne langfristige Bedeutung sei, da es sich stets in Abhängigkeit zu Handlungen bilde (vgl. ebd.)“ (Rathmann 2022).
Robinson, L. (2007). The cyberself: the self-ing project goes online, symbolic interaction in the digital age. New Media & Society, 9(1), 93–110. https://doi.org/10.1177/1461444807072216
Auch KI-Modelle unterscheiden sich untereinander. Je nachdem mit welchen Daten, Restriktionen und Regeln sie versehen wurden, spiegeln diese KI-Modelle eine Art „Persönlichkeit“ gegenüber den Nutzern, die sich allerdings von der menschlichen Persönlichkeit unterscheidet.
„Auch KI weist individuelle Unterschiede und eine Art „Persönlichkeit“ auf. Jedoch unterscheiden sich LLMs grundlegend vom Menschen: Sie agieren ohne neurobiologische Prozesse und primär über sprachliche Kanäle, während sich menschliche Persönlichkeit multimodal manifestiert“ (Schrödel et al., 2026).
Wenn sich also Künstliche Intelligenz, und hier speziell das hinterlegte Large Language Model (LLM), mit seiner „Persönlichkeit“ der menschlichen Persönlichkeit annähert, ist es möglich, einen Prozess der ständigen Personalisierung von Aussagen, Dienstleistungen und Produkten anzustoßen.
„LLMs bieten damit interessante Ansatzpunkte für personalisierte Anwendungen: Sie können aktuelles Verhalten erkennen, zukünftige Entwicklungen vorhersagen und durch sprachbasierte Interventionen gezielt verändern. Eine fortlaufende Personalisierung auf Basis längerer Interaktionsverläufe dürfte die Wirksamkeit dieser Schritte erhöhen. Belastbare empirische Evidenz zu Wirksamkeit und Nebenwirkungen fehlt bislang (Stade et al., 2024)“ Schödel et al., (2026). Künstliche Intelligenz und Individuelle Unterschiede: Eine Perspektive der Fachgruppe Differentielle Psychologie, Persönlichkeitspsychologie und Psychologische Diagnostik, Psychologische Rundschau, vol. 77, no. 3, pp. 149–155, Jul. 2026, doi: 10.1026/0033-3042/a000766.
Wenn sich also ein LLM – oder mehrere – immer wieder an die das Cyber-self anpasst, kann das gut gelingen, es kann allerdings auch sein, dass dieses multiple Cyberself gar nicht der analogen Person entspricht. Es käme dann zu einem Mismatch, der nicht dazu beiträgt, Werte für den Nutzer zu schaffen. Im schlimmsten Fall, könnte der Prozess sogar Werte vernichten.
Wenn ein Unternehmen also Personalisierung mit Hilfe der verfügbaren LLMs aufbauen möchte, sollte es sich darüber im Klaren sein, dass das Cyberself von dem analogen Menschen immer noch abweicht. Ich habe manchmal den Eindruck, dass Unternehmen immer noch dem Mythos unterliegen, dass sie durch die vielen generierten Daten eine Art Abbild vom Menschen vorliegen haben.
In der von mir initiierten Konferenzreihe zu Customization and Personalization geht die Community of Europe auf solche Zusammenhängen mit aktuellen Forschungsergebnissen und Fallstudien ein. Zuletzt haben wir uns auf der MCP 2026 vom 16.-19.09. in Balatonfüred (Ungarn) getroffen. Auch 2028 werden wir uns wieder treffen. Zu der Konferenzreihe können Sie sich gerne auf MCP-CE.org informieren.
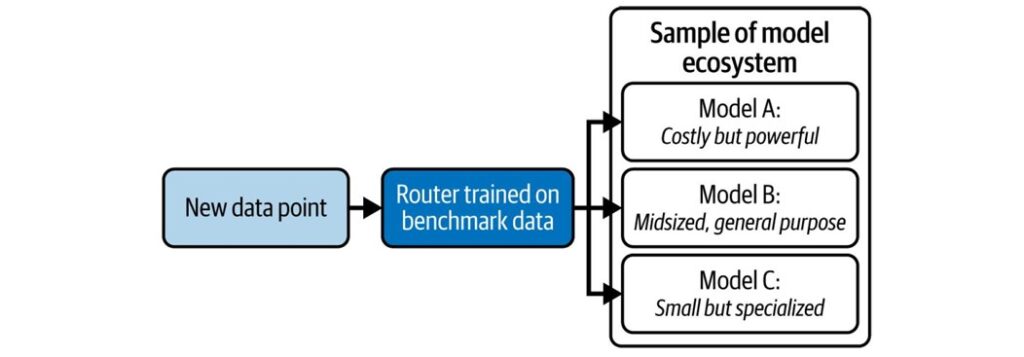
An AI router that understands the capabilities of models in its library directs a given inference request to the best model able to perform the task at hand (Thomas et al. 2025)
Es ist in Organisationen nicht mehr zeitgemäß, alle anfallenden Aufgaben (Tasks) von einem sehr großen und Leistungsfähigen KI-Modell bearbeiten zu lassen. Dieses „One Size Fits All“ führt nur zu einem erhöhten Ressourcenverbrauch und damit zu hohen Kosten.
Besser ist es, für jede Anfrage das geeignete Modell auszuwählen. In dem Beitrag Künstliche Intelligenz: Mit einem AI Router verschiedene Modelle kombinieren hatte ich diese Vorgehensweise grob dargestellt. Die Abbildung zeigt das prinzipielle Vorgehen: Ein AI Router entscheidet auf Basis von Vorgaben, welches KI-Modell für den Task geeignet erscheint.
Da wir auf Open Source Software und Open Source AI setzen, ist es interessant, dass Langflow nun die Möglichkeit bietet, einen Smart Router zu nutzen. Basis ist dabei die schon vorhandene Wenn > Dann (If-Else) Funktion.
Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.
Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.
Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.
Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.
Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.
At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).
Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.
Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch
Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026
Aktuell wird weltweit sehr viel Geld für große Rechenzentren eingesammelt und investiert. Die Story ist, dass große KI-Modelle sehr große Rechenkapazitäten benötigen, um riesige Datenmengen zu bearbeiten und um schnelle Antwortzeiten für immer mehr Nutzer zu liefern. Ganz im Sinne von je größer umso besser. Ob diese Story ein gutes Ende haben wird bleibt abzuwarten. Siehe dazu Künstliche Intelligenz: Enormer Ressourcenverbrauch großer KI-Modelle.
Parallel dazu gibt es eine Entwicklung, die auf dezentrale Systeme setzt und die Rechenleistung von vielen lokalen Hardwarestrukturen nutzen möchte. Solche lokalen KI-Anwendungen (Local AI) werden nachweislich immer beliebter. Das hat mehrere Gründe: (1) Einerseits sind es natürlich auch die immensen Kosten, die gerade Kleine und Mittelständische Unternehmen (KMU) kaum mehr kalkulieren können (Stichwort: Abrechnung in Token), (2) Datensicherheit und Digitale Souveränität, (3) Zukunftsfähigkeit eines eigenen KI-Systems, das auf Open Source AI setzt.
Weiterhin gibt es einen Trend, spezialisierte (kleine) KI-Modelle in einem Router je nach Anwendungsfall zu kombinieren. Nicht zuletzt reichen lokale KI-Modelle für Standardanfragen oftmals völlig aus.
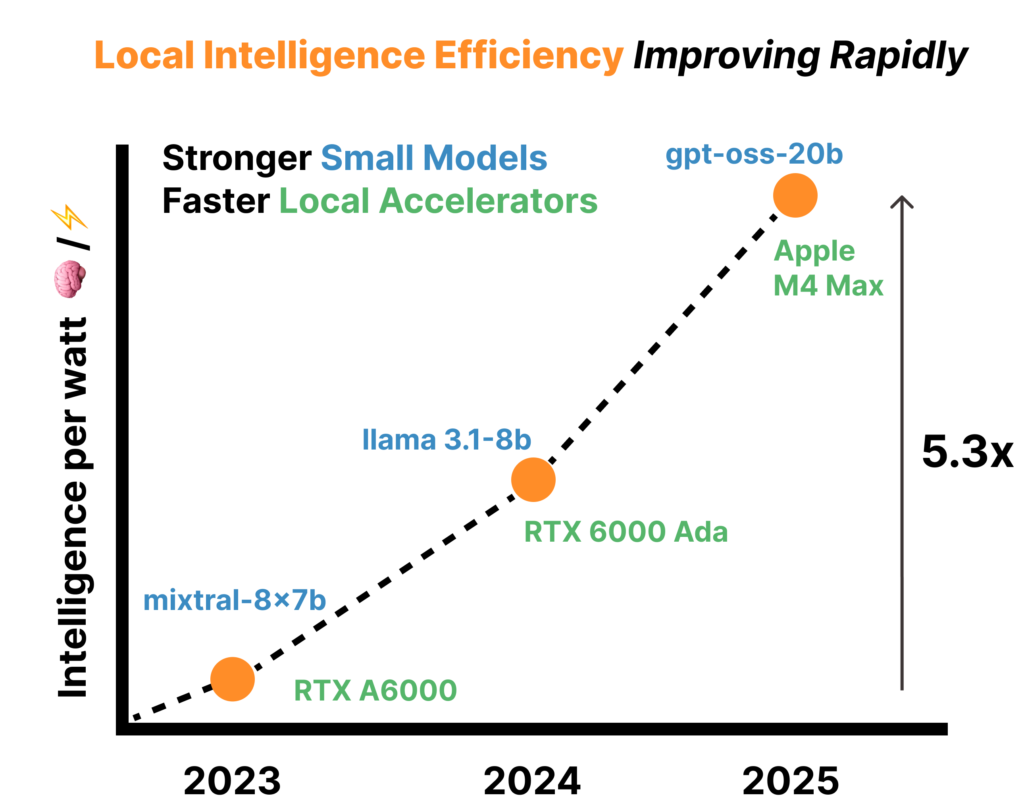
„Local LMs are capable and improving rapidly:Local LMs can accurately respond to 88.7% of single-turn chat and reasoning queries, with accuracy improving 3.1× from 2023-2025“ (Saad-Falcon et al., 2025).
Ein weiterer interessanter Aspekt ist, dass die Forscher um Saad-Falcon eine neue Messgröße vorschlagen: Intelligence per Watt (IPW). Es geht um den Zusammenhang zwischen „gelieferter Intelligenz“ und den dafür benötigten Ressourcenverbrauch.
„intelligence-per-watt—a metric that quantifies how effectively inference systems convert energy into useful computation.
IPW = (mean accuracy across tasks) / (mean power draw during inference)“
Die angegebene Studie zeigt deutlich den Vorteil auf, lokale KI anzuwenden, wenn es um die Kenngröße Intelligence per Watt geht. Wir sind der Auffassung, dass es in Zukunft mit Open Source AI und LocalAI möglich sein wird, mehr Digitale Souveränität in Europa zu erreichen, und innovativer zu werden.
Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei Paper ein:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
In der eigenen Langflow App angelgter einfacher Workflow
In dem Blogbeitrag Open Source AI: Ministral 3B auf dem eigenen Laptop nutzen hatte ich gezeigt, wie man mit Hilfe der Ollama App, Open Source KI-Modelle (oder Open Weight KI-Modelle) auf dem eigenen Laptop installieren und nutzen kann. Da es in der Zwischenzeit viele kleine und leistungsstarke KI-Modelle (SLM: Small Language Models gibt), ist dieser Ansatz gerade für Kleinstunternehmen wirtschaftlich interessant.
Wenn es im nächsten Schritt darum geht, solche Modelle in eigene KI-Agenten einzubinden, bietet sich die auf dem eigenen Laptop installierte Langflow App an – eine Alternative ist LM Studio. Die Ollama App und die Langflow App sind natürlich Open Source.
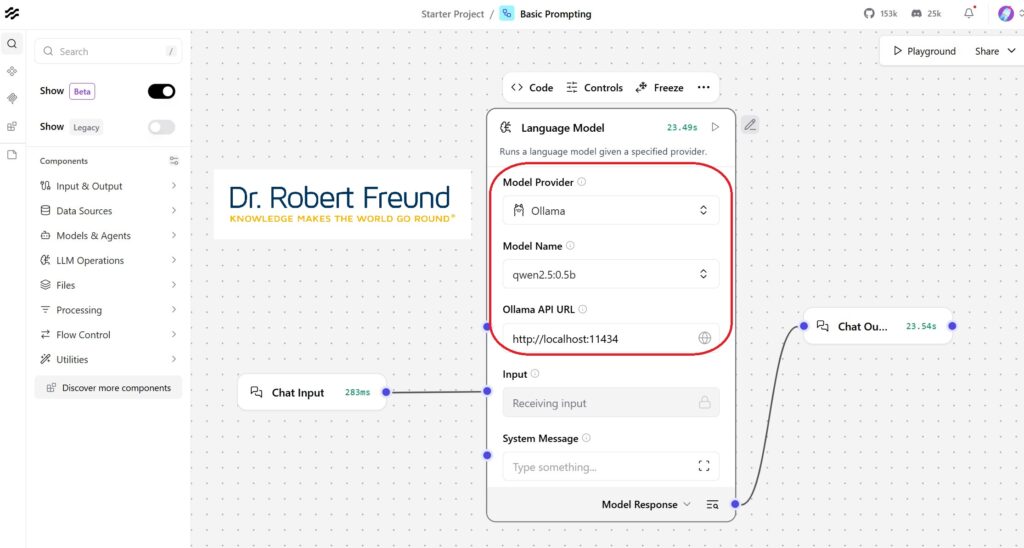
In der Abbildung oben ist ein einfacher Workflow mit den Knoten Chat Input, Language Model und Chat Output dargestellt (rot umrahmt). Diese Knoten konnte ich per Drag & Drop in die Arbeitsfläche ziehen. Dabei wird farbig angezeigt, welche Verknüpfungen möglich sind.
Bei dem Language Model habe ich in der auf meinem Laptop installierten Ollama App ein Modell ausgesucht – in meinem Fall ist es Qwen 2.5. Es stehen hier alle in der Ollama App installierten KI-Modelle zur Verfügung. Wir testen mit geeigneten Open Weight, bzw. Open Source Modellen. Siehe dazu auch Open Source AI: Ministral 3B auf dem eigenen Laptop nutzen.
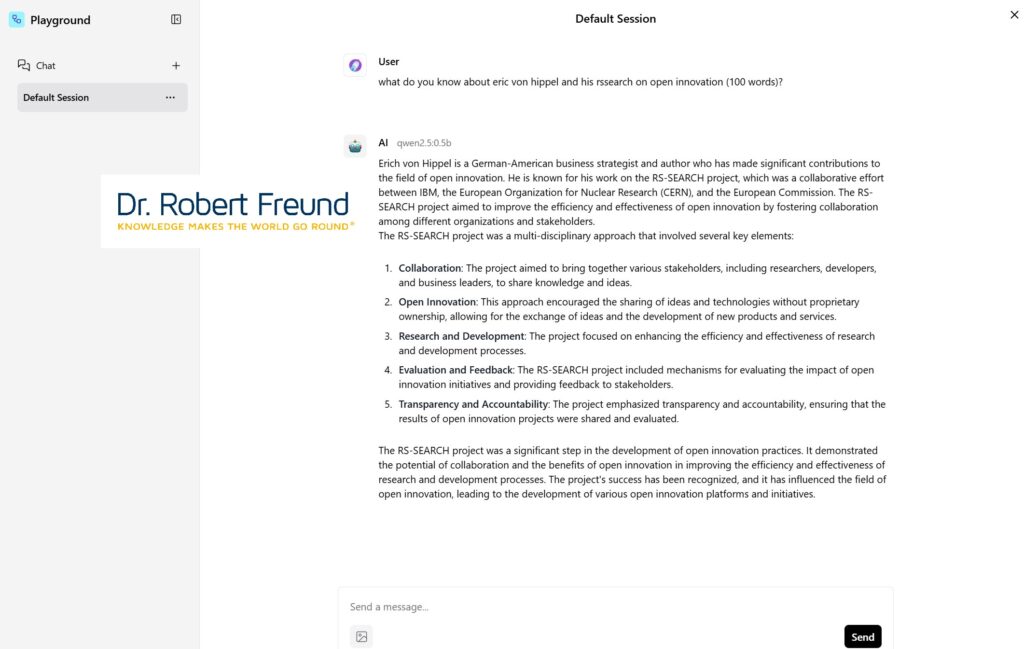
Diesen kleinen Workflow kann ich anschließend im Playground (Button rechts oben) testen. Als Chat Input habe ich dort eine Frage zu Eric von Hippel gestellt, die dann mit dem hinterlegten KI-Modell schnell beantwortet wurde – obwohl ich dazu einen relativ alten Laptop genutzt habe. Die folgende Abbildung zeigt das gute Ergebnis im Playground.
Ergebnis im Playground
Es ist also mit Ollama App und der Langflow App auf dem eigenen Laptop möglich, kleine KI-Modelle (Open Source, Open Weight) zu nutzen, und sogar kleine Workflows abzubilden. Dabei bleiben alle generierten Daten auf meinem Laptop. Das ist besonders wichtig, wenn ich nicht nur einen einfachen Workflow, abbilden, sondern KI-Agenten entwickeln möchte, die bei der Bearbeitung auch eigene Daten aus unserer Nextcloud mit berücksichtigen sollen – ganz im Sinne einer Digitalen Souveränität.
Auf der internationalen Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in einem Paper ein.
Nach den großen KI-Sprachmodellen (LLM: Large Language Models), den kleineren Modellen (SLM: Small Language Models), den Mixed of Experts (MoE) Models sind seit einiger Zeit KI-Agenten im Fokus der Anbieter, Anwender und Forscher.
Nach dem ersten Hype um KI-Agenten mit Aussagen wie „KI Agenten ersetzen Mitarbeiter“ oder „KI-Agenten erhöhen die Produktivität“ usw. ist in der Zwischenzeit eine gewissen Ernüchterung eingetreten.
Ein weiterer Aspekt ist, dass die KI-Agenten eine Eigendynamik entwickeln, die von den Tech-Konzernen nicht mehr kontrolliert werden kann. Dazu haben Sie sicherlich auch in den einschlägigen Medien die Berichte über KI-Agenten gelesen, die „von sich aus“ andere Unternehmen und Organisationen gehackt haben. Beispielhaft sei hier nur die Meldung von der Tagesschau vom 22.07.2026 genannt: KI von OpenAI steuert eigenständig Hackerangriff – und nein, das ist kein Einzelfall.
Dass Unternehmen so sorglos mit dieser Entwicklung umgehen ist bemerkenswert, denn: Wer trägt den angerichteten Schaden? Möglicherweise entsteht der Schaden auch noch viel später und kann gar nicht mehr auf die Ursache zurückgeführt werden. Die in der Softwarebranche übliche Vorgehensweise, unfertige Software auf den Markt zu bringen und durch die Anwendung der Nutzer zu optimieren, ist im Zusammenhang mit KI-Agenten nicht sehr intelligent.
In der Forschungslandschaft haben schon viele Forscher auf die Tücken von KI-Agenten hingewiesen, doch werden solche Erkenntnisse oftmals von den Tech-Konzernen als störend für das Geschäftsmodell empfunden. Es ist allerdings die Aufgabe von Forschern, ohne Rücksicht auf die ohnehin einseitigen wirtschaftlichen Interessen von Unternehmen, auf wichtige Erkenntnisse hinzuweisen.
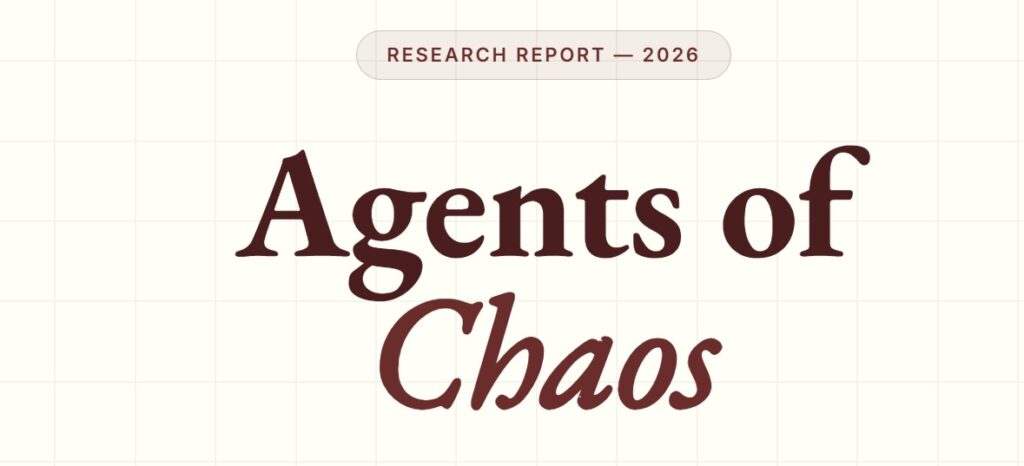
Beispielhaft möchte ich dazu die folgende Veröffentlichung nennen. Die Ergebnisse zeigen, wie chaotisch und teilweise gefährlich die Zusammenarbeit der KI-Agenten verlief.
„Observed behaviors include unauthorized compliance with non-owners, disclosure of sensitive information, execution of destructive system-level actions, denial-of-service conditions, uncontrolled resource consumption, identity spoofing vulnerabilities, cross-agent propagation of unsafe practices, and partial system takeover“ (Shapira, N. et al. 2026 Agents of Chaos. Available from https://arxiv.org/abs/2602.20021).
Auf Basis guter wissenschaftlicher, transparenter und nachvollziehbarer Arbeit, haben die Forscher auf der dazugehörenden Website (Abbildung) die Vorgehensweise, die verwendeten KI-Agenten und die generierten Daten veröffentlicht. Es kann sich somit jeder ein eigenes Bild von dem Chaos der Agenten machen. Nicht umsonst heißt der Titel der Veröffentlichung und der dazugehörenden Website Agents of Chaos.
Es wäre gut, wenn einzelne Personen, Unternehmen und Öffentliche Verwaltungen nicht blind den Marketingversprechen der Konzerne folgen, sondern auch wissenschaftliche Erkenntnisse in ihre Entscheidungen zu KI einbeziehen würden.
Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf solche Zusammenhänge ein:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
In den letzten Jahren gibt es sehr viele Content-Entwickler aus allen möglichen Bereichen, die sich gegen die Übernahme ihrer Inhalte als Trainingsdaten in den bekannten, kommerziellen KI-Modellen wehren.
Dabei kommt es einem so vor, als ob die großen KI-Unternehmen das wohl schon irgendwie „eingepreist“ haben und langwierige Gerichtsverfahren eingehen. Darüber hinaus muss auch die folgende Frage gestellt werden
Ist es möglich ist, leistungsfähige KI-Sprachmodelle zu trainieren, die ausschließlich auf gemeinfrei und offenen Texten basieren?
Die Antwort: Ja, es ist möglich.
In ihrem Paper hat eine Forscher-Gruppe nicht nur ausführlich dargelegt, welche Quellen sie dafür ausgewählt haben, sondern auch gleichzeitig ein entsprechendes Modell entwickelt und auf Hugging Face veröffentlicht:
„We release Common Pile v0.1, an 8TB corpus that—to our knowledge—constitutes the largest dataset built exclusively from openly licensed text. Alongside our dataset, we release Comma v0.1-1T and -2T, two performant 7-billion-parameter LLMs trained on text from the Common Pile, as well as the filtered and rebalanced data mixture we used for training. Our results demonstrate that not only is the Common Pile the strongest dataset for pretraining under an open-license constraint, but also that it produces models comparable to those trained on an equivalent amount of unlicensed data. This positive result holds promise for future of open-license pretraining, especially if the research community invests in collecting larger quantities of openly licensed text data in the future. Ultimately, we believe that the Common Pile v0.1 represents the first step on the path towards a more ethical language model ecosystem, where performance need not come at the cost of creator rights and legal transparency.“ (Kandpahl et al. (2025): The Common Pile v0.1: An 8TB Dataset of Public Domain and Openly Licensed Text).
Natürlich dominieren die proprietären KI-Modelle den Markt, und es fällt den Marktteilnehmer wegen dem in der Zwischenzeit eingetretenen Lock-in schwer, sich an andere KI-Modelle zu gewöhnen (Pfadabhängigkeit). Dennoch überlegen viele Einzelpersonen, Unternehmen, Not for Profit Organisationen oder auch Öffentliche Verwaltungen, ob sie sich nicht von der eingetretenen Abhängigkeit lösen sollten, ja müssen.
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
In dem Buch Muldoon, J., Graham, M., Cant, C. (2025) Feeding the Machine geht es den Autoren darum, zu hinterfragen, wie die großen KI-Modelle (LLM: Large Language Models) mit ihren riesigen Datenmengen entstehen, und von großen Unternehmen für ihre geschäftlichen Aktivitäten genutzt werden.
„Das ist aus Sicht von Muldoon, Graham und Cant auch das grundsätzliche Problem der KI-Entwicklung: dass sie vor allem von wenigen mächtigen Akteuren in deren Eigeninteresse entwickelt und genutzt werde. Die Kapitalintensität von KI führe dazu, dass sich Machtstrukturen weiter verfestigen, da nur wenige Unternehmen weltweit das Geld, die Hardware und das Knowhow besitzen, um die Entwicklung voranzutreiben. Durch die Arbeit dieser Unternehmen würden auch koloniale Strukturen aufrechterhalten, schreiben sie. Weil sich Arbeitskräfte im globalen Süden gezwungen sähen, für sehr wenig Geld unter schlechten Bedingungen zu arbeiten, während die hohen Gewinne in die Kassen der Konzerne und Investoren fließen“ (Scherer, K. (2025): KI-Erklärwerk und Kapitalismuskritik, Deutschlandfunk, Andruck, 30.06.2025 | PDF).
Es ist daher gut, dass sich in den letzten mehr als 20 Jahren weltweit Alternativen entwickelt haben, die frei verfügbare Daten in frei verfügbaren KI-Modellen zur Verfügung stellen (Open Data and Open Source AI – a perfect match). Je mehr diese genutzt werden, umso weniger Marktmacht haben die großen Tech-Konzerne. Es wundert daher nicht, dass diese an alternativen Entwicklungen wenig interessiert sind, und versuchen eine Art open washing mit ihren Modellen zu betreiben. Siehe dazu auch
Es wundert daher nicht, dass in den letzten Jahren immer mehr KI-Modelle entwickelt wurden, die in europäischen Sprachen trainiert wurden. Beispiele dazu sind Teuken 7B und Open EuroLLM. Darüber hinaus gibt es in Europa auch schon viele KI-Modelle, die in der jeweiligen Landessprache trainiert wurden. Beispiele dazu sind das Ungarisches Modell, das Schwedisches Modell, das Italienische Modell usw.
Dass es in kritischen Bereichen wie dem Gesundheitswesen wichtig ist, bei KI-Modellen den sprachlichen und kulturellen Kontext zu beachten, wurde in einer Veröffentlichung der United Nations (UN) noch einmal beispielhaft hervorgehoben:
„In Tigrinya, spoken by 7 to 9 million people in Eritrea and northern Ethiopia, machine translation has rendered smallpox as syphilis, gonorrhoea as diabetes and “You have been given intravenous antibiotics” as “You have been given intravenous insecticides”. These mistranslations can be life-threatening. A recent review of natural language processing for African languages in healthcare found that, despite advances in multilingual AI tools, major challenges remain. These include cultural and linguistic bias, poor adaptation to medical contexts, limited explainability and translation errors that can affect diagnosis and treatment decisions. The evidence suggests that AI systems are not ready for use in high-stakes settings unless they have been properly adapted, constrained and tested for the relevant linguistic and cultural contexts“ (UN 2026).
Mit Hilfe von Small Language Models (SLM) und der Berücksichtigung sprachlicher und kultureller Besonderheiten einzelner Regionen in Europa können gerade Kleine und Mittlere Unternehmen (KMU) innovative Produkte und Dienstleistungen entwickeln, die einen Mehrwert für die Nutzer bieten.
Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in einem Paper ein:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Mein zweites Paper:
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Diese Website benutzt Cookies. Wenn du die Website weiter nutzt, gehen wir von deinem Einverständnis aus.