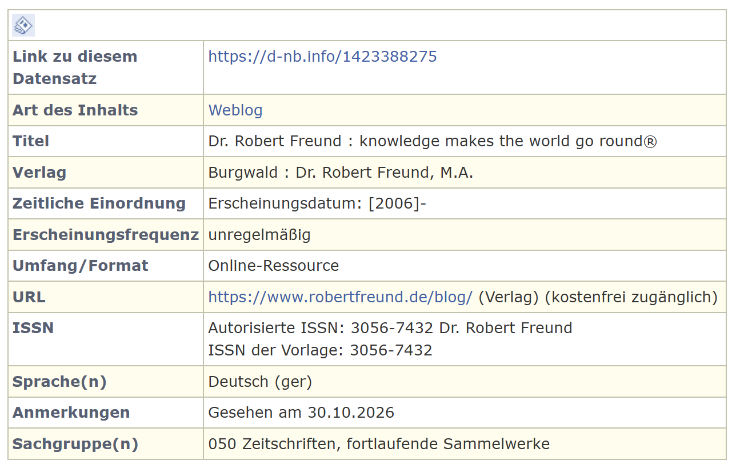
Ende Oktober haben wir die ISSN 056-7432 erhalten (Blogbeitrag). In der Zwischenzeit ist unser Blog auch in der Deutschen Nationalbibliothek geführt (Abbildung). Der Blog hat nun den Status einer fortlaufenden wissenschaftlichen Online-Publikation. Es freut uns sehr, dass die Blogbeiträge nun offiziell zitiert werden können. Hier ein Beispiel:
Harvard-Zitierweise (deutschsprachiger Standard):
Freund, Robert (2026): ISSN erhalten: Vom Weblog zur wissenschaftlichen Publikation, in: Dr. Robert Freund (ISSN 3056-7432), 31.10.2026, [online] https://www.robertfreund.de/blog/2026/10/31/issn-erhalten-vom-weblog-zur-wissenschaftlichen-publikation/ [abgerufen am TT.MM.JJJJ].
Wenn sich Berater zu etwas äußern steckt oft das Ziel dahinter, einen Bedarf aufzuzeigen, um dann daraus abgeleitet Aufträge zu generieren. Insofern schaue ich z.B. auf die folgende Veröffentlichung (positiv) kritisch. Dennoch möchte ich auf die in der Zusammenfassung genannten Punkte eingehen.
MGI (2026): AI Economy (2026): AI Economy. Interconnected forces, feedback loops, and speeds of change. Discussion Paper. MGI, 10.09.2026.
MGL: AI’s advance will leave few of us unaffected. Dass kaum jemand nicht von AI berührt ist oder sein wird, ist nicht gerade eine neue Erkenntnis. AI wird sich auch auf die Beraterbranche auswirken. Warum sollte ich teure Berater beauftragen, wenn ich einen Großteil der Themen von einem AI-Modell bearbeiten lassen kann?
MGI: Answering big questions about AI means seeing the whole picture, not just focusing on the technology. Mein Kommentar: Das ist bemerkenswert, da es ja gerade die großen Beratungsgesellschaften waren, die die Technologie in den Mittelpunkt ihrer Tätigkeiten (Transformationen) gestellt haben. Jetzt dämmert es langsam, dass das nicht ausreicht. In manchen Bereichen ist es möglicherweise etwas zu spät, da dort schon ein technologischer Lock-in stattgefunden hat, aus denen Organisation nur mit viel Aufwand wieder herauskommen (Switching Costs).
MGI: Risks and bottlenecks arise because different parts of the AI system are moving at vastly different paces. Mein Kommentar: Hier geht es um das KI-System, dessen Teile unterschiedliche Geschwindigkeiten haben. Das ist bei technologischen Entwicklungen nicht ungewöhnlich – der Hinweis darauf also eher banal.
In the AI era, leaders must therefore learn to manage at multiple speeds. Mein Kommentar: Den Umgang mit unterschiedlichen Geschwindigkeiten müssen also Führungskräfte heute lernen. Von wem, von McKinsey? Den Hinweis darauf, dass eine Systembetrachtung die Möglichkeit bietet, mit so komplexen Problemstellungen hilfreich ist, kann ich nur zustimmen. Wenn man alle Akteure eines gesellschaftlichen Systems betrachtet, ist AI allerdings nur eine Komponente und nicht die Dominierende. Kern eines gesellschaftlichen Systems sind die Menschen, die sich in Europa beispielsweise zu bestimmten Werten verpflichtet haben. Diese sind dann auch bindend für AI-Modelle – nicht umgekehrt.
Die Veröffentlichungen von Beratern sind oftmals gut aufbereitet und werden von Business-Leuten gelesen. Auch der Name McKinsey Global Institute gibt McKinsey’s publications and research give a „quasi-academic“ image (vgl. Wikipedia). Quasi akademisch ist eben nicht wirklich akademisch, also wissenschaftlich.
Doch: Wer liest schon wissenschaftliche Veröffentlichungen? Ich, und es ist spannender als viele denken! Siehe dazu auch meine beiden Paper zur MCP-CE 2026:
Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs – Abstract
Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework – Abstract
Nach den großen KI-Sprachmodellen (LLM: Large Language Models), den kleineren Modellen (SLM: Small Language Models), den Mixed of Experts (MoE) Models sind seit einiger Zeit KI-Agenten im Fokus der Anbieter, Anwender und Forscher.
Nach dem ersten Hype um KI-Agenten mit Aussagen wie „KI Agenten ersetzen Mitarbeiter“ oder „KI-Agenten erhöhen die Produktivität“ usw. ist in der Zwischenzeit eine gewissen Ernüchterung eingetreten.
Ein weiterer Aspekt ist, dass die KI-Agenten eine Eigendynamik entwickeln, die von den Tech-Konzernen nicht mehr kontrolliert werden kann. Dazu haben Sie sicherlich auch in den einschlägigen Medien die Berichte über KI-Agenten gelesen, die „von sich aus“ andere Unternehmen und Organisationen gehackt haben. Beispielhaft sei hier nur die Meldung von der Tagesschau vom 22.07.2026 genannt: KI von OpenAI steuert eigenständig Hackerangriff – und nein, das ist kein Einzelfall.
Dass Unternehmen so sorglos mit dieser Entwicklung umgehen ist bemerkenswert, denn: Wer trägt den angerichteten Schaden? Möglicherweise entsteht der Schaden auch noch viel später und kann gar nicht mehr auf die Ursache zurückgeführt werden. Die in der Softwarebranche übliche Vorgehensweise, unfertige Software auf den Markt zu bringen und durch die Anwendung der Nutzer zu optimieren, ist im Zusammenhang mit KI-Agenten nicht sehr intelligent.
In der Forschungslandschaft haben schon viele Forscher auf die Tücken von KI-Agenten hingewiesen, doch werden solche Erkenntnisse oftmals von den Tech-Konzernen als störend für das Geschäftsmodell empfunden. Es ist allerdings die Aufgabe von Forschern, ohne Rücksicht auf die ohnehin einseitigen wirtschaftlichen Interessen von Unternehmen, auf wichtige Erkenntnisse hinzuweisen.
Beispielhaft möchte ich dazu die folgende Veröffentlichung nennen. Die Ergebnisse zeigen, wie chaotisch und teilweise gefährlich die Zusammenarbeit der KI-Agenten verlief.
„Observed behaviors include unauthorized compliance with non-owners, disclosure of sensitive information, execution of destructive system-level actions, denial-of-service conditions, uncontrolled resource consumption, identity spoofing vulnerabilities, cross-agent propagation of unsafe practices, and partial system takeover“ (Shapira, N. et al. 2026 Agents of Chaos. Available from https://arxiv.org/abs/2602.20021).
Auf Basis guter wissenschaftlicher, transparenter und nachvollziehbarer Arbeit, haben die Forscher auf der dazugehörenden Website (Abbildung) die Vorgehensweise, die verwendeten KI-Agenten und die generierten Daten veröffentlicht. Es kann sich somit jeder ein eigenes Bild von dem Chaos der Agenten machen. Nicht umsonst heißt der Titel der Veröffentlichung und der dazugehörenden Website Agents of Chaos.
Es wäre gut, wenn einzelne Personen, Unternehmen und Öffentliche Verwaltungen nicht blind den Marketingversprechen der Konzerne folgen, sondern auch wissenschaftliche Erkenntnisse in ihre Entscheidungen zu KI einbeziehen würden.
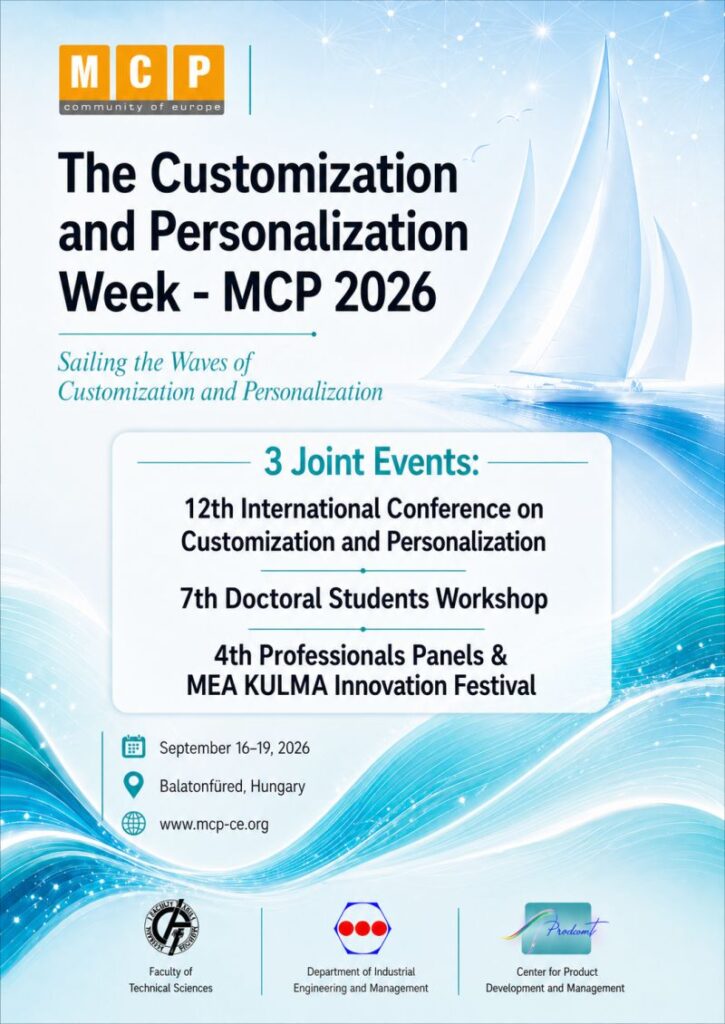
Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf solche Zusammenhänge ein:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.
Es ist nur natürlich, dass jeder Einzelne, Organisationen und Öffentliche Verwaltungen ausprobieren, was mit Künstlicher Intelligenz (GenAI) möglich ist. Im wissenschaftlichen Umfeld wundere ich mich allerdings immer wieder darüber, wie unkritisch GenAI eingesetzt wird, wodurch die Kriterien wissenschaftlicher Arbeit konterkariert werden. Warum ist das so? Eine ausführlich Begründung habe ich im aktuellen OECD Report gefunden. Dabei geht es hier speziell um die Reproduzierbarkeit als Säule wissenschaftlichen Arbeitens geht.
Reproducibility is a pillar of scientific operations. To be accepted by the scientific community, results must (usually) be verifiable, and reproducible by others. One condition for reproducibility is full disclosure of the methods and data that led to the conclusion, meaning transparency and accessibility. From this perspective, GenAI models do not meet scientific criteria. First, the most popular models of GenAI are “black boxes”, as neither their weights (the parameters that define a neural network) nor their training data are publicised. Thus, disentangling the contribution of the data and the contribution of various components of the model is difficult in any scientific result coming from such a model. This comes from the very nature of neural networks: knowledge is distributed, hence difficult to localise. As GenAI models have a random component at their core, some results might not be robust. In addition, access to the training data can be limited due to the proprietary nature of many GenAI models: one example is the “AI Structural Biology Consortium”, a follow-up to AlphaFold-3, an ongoing project which makes use of data owned by pharmaceutical companies, which is secret and will remain secret (Callaway, 2025). Currently, solutions for access include open weights (e.g. Llama) and open source (including access to training data). The importance of openness was demonstrated by AlphaFold2, as the disclosure of its code and data triggered a series of initiatives refining the tool (Saplakoglu, 2024). Openness is essential to the cumulative progress at the core of science“ (OECD Digital Education Report 2026).
Am Beispiel von Pharmaunternehmen wird deutlich, dass es gerade in sensiblen Branchen wichtig ist, offene KI-Modelle zu nutzen. Offenheit ist: „Offenheit ist für den kumulativen Fortschritt im Kern der Wissenschaft unerlässlich“ (ebd.). Siehe dazu auch
Wenn man sich die vielen Meldungen in den Medien ansieht, kann man zu dem Schluss kommen, dass es (fast) allen um Aufmerksamkeit, und damit auch um Beeinflussung geht. Dahinter können wirtschaftliche, politische oder soziale Interessen stecken. Viele gehen dabei sehr subtil vor, indem sie Daten nicht genau wiedergeben, oder bewusst aus dem Zusammenhang nehmen.
Oft fehlt bei den Angaben auch die genaue Quelle. Es wird von einer diffusen Studie gesprochen oder geschrieben, doch wird die Quelle nicht genannt. Weiterhin steht bei Zeitungsartikel oft der Hinweis, dass der Beitrag auf Basis von Inhalten anderer Medien geschrieben wurde – diese werden allerdings im Text – wenn überhaupt – nicht deutlich kenntlich gemacht.
Die wenigen Beispiele zeigen schon auf, dass eine mehr wissenschaftlich basierte Arbeit wünschenswert wäre. Die Prinzipien einer solchen Arbeit würden helfen, zwischen eigener Meinung und Quelle zu unterscheiden, um sich ein eigenes Bild machen zu können. Damit kommen wir zur Akademischen Integrität, die es ermöglichen soll, dass wissenschaftlich korrekt und damit transparent gearbeitet und veröffentlicht wird. Gerade in Zeiten von Künstlicher Intelligenz muss das ganz besonders beachtet werden.
Was ist unter Akademischer Integrität zu verstehen?
Dazu habe ich eine Definition der International Centre for Academic Integrity [ICAI] gefunden, die eher im amerikanischen Umfeld genutzt wird. In Europa beziehen sich akademische Institutionen eher auf die Definition der ENAI:
The definition from the European Network for Academic Integrity [ENAI] (2022) is less philosophical than ICAI’s. ENAI states that academic integrity is: Compliance with ethical and professional principles, standards, practices and consistent system of values, that serves as guidance for making decisions and taking actions in education, research and scholarship.“ (Gallant, T. B. ; Davis, M. Khan, Z. R. (2026): ACADEMIC INTEGRITY IN THE AGE OF AI. DOI 10.1017/9781009672078).
Wenn wir unterstellen, dass akademische Integrität bedeutet, selbst verantwortlich, transparent und ethisch zu arbeiten wird klar, dass sich diese Vorgehensweise dann auch auf die Gesellschaft auswirkt.
Es wird Zeit, dass alle Akteure in einer von Künstlicher Intelligenz getriebenen Welt, akademische Prinzipien berücksichtigen. In Europa haben wir erste Ansätze dazu, die oftmals platt mit Regulierung gleichgesetzt werden. In den USA oder China erodieren diese Grundlagen eher. Es ist daher gut, dass wir in Europa einen eigenen Weg gehen, bei dem die Gesellschaft im Mittelpunkt steht.
Sogar in unseren Blogbeiträgen haben wir von Anfang an darauf geachtet, zwischen Originaltexten mit Quellenangaben, und unserer eigenen Meinung zu unterscheiden. Dass ich die Prinzipien bei meiner Dissertation und bei meinen verschiedenen wissenschaftlichen Paper einhalte, versteht sich von selbst. Aktuell beispielsweise für die beiden Paper, die ich für die MCP 2026, 16.-19.09.2026, in Balatonfüred, Ungarn vorbereite.
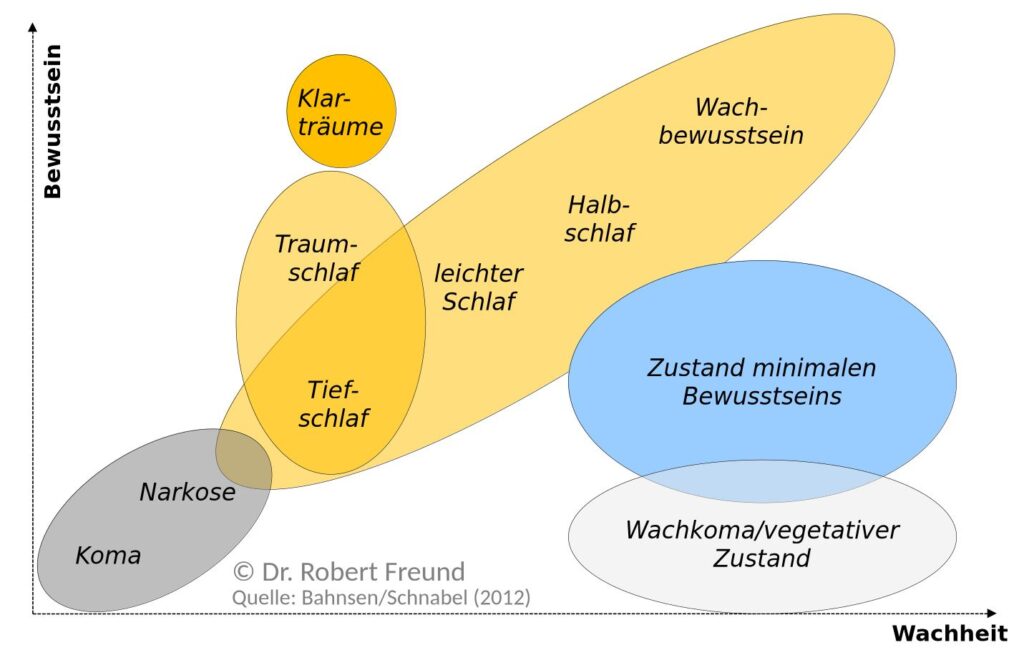
Quelle: Bahnsen/Schnabel (2012(; (c) Dr. Robert Freund
Ein wichtiges Element, worin sich Künstliche Intelligenz und Menschliche Intelligenz unterscheiden, soll das Bewusstsein sein (Penrose 2025). Schauen wir uns zunächst einmal an, was das menschliche Bewusstsein ausmacht. In einem Artikel von Bahnsen und Schnabel (2012) wird u.a. der Entwicklungspsychologe Tomasello wie folgt zitiert:
„Das menschliche Selbstbewusstsein existiert nicht für sich allein, behauptet Michael Tomasello, Leiter der Abteilung Entwicklungspsychologie. Es ist wesentlich ein Produkt der Interaktion mit anderen“ (ebd.).
Es geht hier um die Interaktion mit und zwischen Menschen – unter weiter:
„Ihr Bewusstsein entsteht durch spezielle und hoch entwickelte Formen sozialer Fähigkeiten bei der Interaktion mit anderen – etwas was Tomasello „kulturelle Intelligenz“ nennt“ (ebd.).
Die vernetzten Interaktionsformen bei Menschen weisen auf eine Dynamik bei dem Bewusstsein hin, die in der Abbildung beispielhaft in Bezug zu Wachheit zu erkennen ist. Da diese Argumente sehr stark auf Menschen bezogen sind, ergibt sich in der Zwischenzeit die Frage, ob auch Künstliche Intelligenz so eine Art von Bewusstsein haben kann.
Nobelpreisträger Sir Roger Penrose hat hier eine deutliche und klare Meinung. Da Künstliche Intelligenz nach seiner Auffassung kein Bewusstsein haben wird, sollten wir nicht von Künstlicher Intelligenz, sondern eher von Künstlicher Cleverness sprechen. Sie dazu Künstliche Cleverness statt Künstliche Intelligenz?
Sir Roger Penrose, Gödel’s theorem debunks the most important AI myth. AI will not be conscious, Interview, YouTube, 22 February 2025. This Is World. Available at: https://www.youtube.com/watch?v=biUfMZ2dts8
AI will not have conscious – Künstliche Intelligenz wird kein Bewusstsein haben.
In seiner Argumentation verwendet Penrose Gödels Theorem, was als Penrose-Lucas Argument (englisch) durchaus auf Kritik in der Wissenschaftswelt gestoßen ist. Was erwartbar war – so ist eben spannende, lebendige Wissenschaft.
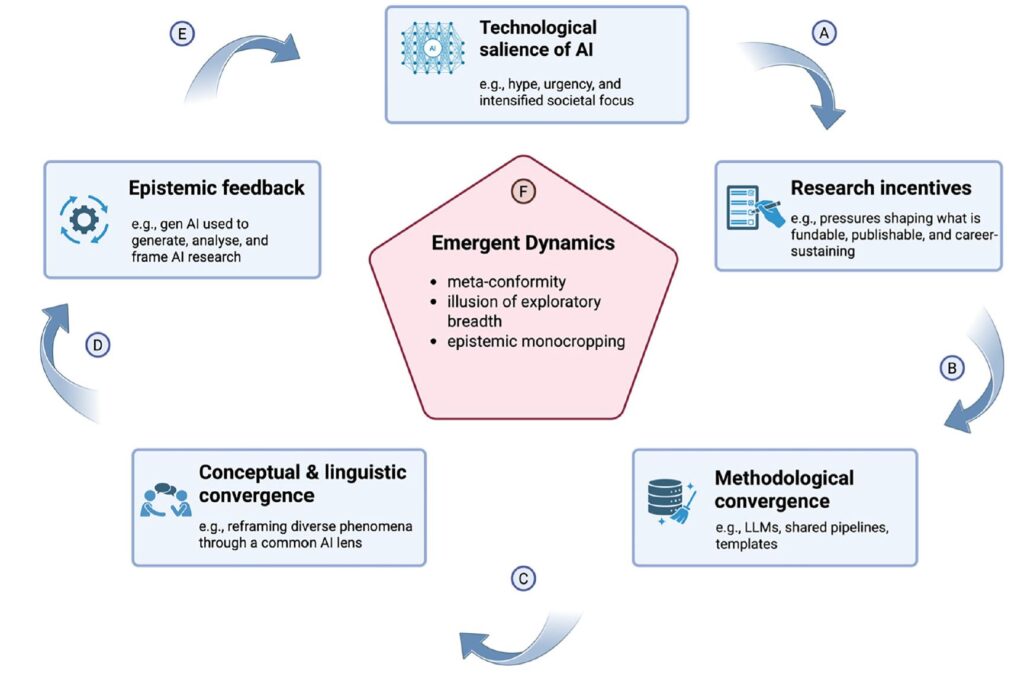
AI monoculture feedback loop (Traberg et al. 2026)
In allen möglichen Kontexten soll und wird Künstliche Intelligenz genutzt. Dabei dominieren in unserem Kulturkreis die von den amerikanischen Konzernen entwickelten GenAI-Modelle. Diese werden in allen privaten und organisatorischen Prozessen integriert. Ein Großteil der Personen und Organisationen nutzen dabei die gleichen KI-Workflows.
Das hat beispielsweise im wissenschaftlichen Kontext einen unschönen Effekt: Dadurch, dass alle Wissenschaftler mehr oder weniger stark die selben GenAI-Modelle für ihre Arbeiten nutzen, kommt es zu einer Art „wissenschaftlicher Monokultur„.
Traberg, C.S., Roozenbeek, J. & van der Linden, S. AI is turning research into a scientific monoculture. Commun Psychol4, 37 (2026). https://doi.org/10.1038/s44271-026-00428-5
In der Abbildung ist der Kreislauf mit seinen einzelnen Schritten dargestellt. Es wird deutlich, dass es sich hier um eine Art Generator handelt, also ein sich selbst verstärkender Wirkungskreislauf.
Auch hier wird deutlich, dass es gut ist, verschiedene KI-Modelle für wissenschaftliche Arbeiten zu nutzen, und die jeweiligen Ergebnisse zu bewerten.
Es stellt sich natürlich auch gleich die Frage, ob diese „wissenschaftliche Monokultur“ auch bei Innovationsprozessen vorkommt. Auch hier nutzen viele Personen und Unternehmen oftmals die gleichen KI-Modelle.
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
In meinen Konferenz-Paper der letzten Jahrzehnte habe ich natürlich immer darauf geachtet, die jeweilige Quelle anzugeben. Damit ist aus wissenschaftlicher Sicht gewährleistet, dass deutlich wird, was von einem anderen Autor, und was von mir stammt.
Mit der gleichen Vorgehensweise erstellen wir auch unsere Blogbeiträge. Da wir dafür keinen KI-generierten Content nutzen, kann der Leser darauf vertrauen. Das ist besonders wichtig, daVertrauen die Basis für die Arbeit mit Künstlicher Intelligenzist – it all starts with trust.
Sollte also jemand Künstliche Intelligenz für seine Blogbeiträge, oder sogar für seine wissenschaftlichen Veröffentlichungen nutzen, steht er vor mehreren Herausforderungen, denn das jeweils verwendete KI-Modell zeigt nicht immer auf, welche Quelle es verwendet hat.
Texte, die originalgetreu von anderen übernommen wurden, werden zwar bei einigen KI-Modellen gekennzeichnet, doch andere Texte sind möglicherweise von der KI selbst zusammengestellt worden. Earp et al. (2025) haben das in einem veröffentlichten Paper als Herkunftsproblem (provenance problem) bezeichnet:
„Suppose the LLM trained on, but does not mention, Smith’s text. And suppose we have never read it or even heard of Smith or her work. So, we don’t cite the paper either. Still, our essay now inherits — via nebulous, machine-mediated means — a distinctive insight that Smith developed but for which she receives no credit“
Source: Earp, B.D., Yuan, H., Koplin, J. et al. LLM use in scholarly writing poses a provenance problem. Nat Mach Intell 7, 1889–1890 (2025). https://doi.org/10.1038/s42256-025-01159-8.
Es handelt sich dabei also nicht um Plagiate, sondern um eine subtilere Art der Verschleierung der Herkunft.
Im wissenschaftlichen Kontext wird das thematisiert, doch wie sieht es mit der privaten Nutzung der allseits eingesetzten KI-Modelle wie ChatGPT, Gemini, Anthropix, Grok etc. aus, die man als Black Box bezeichnen kann?
Da deren Trainingsdaten nicht transparent sind, ist das Herkunftsproblem natürlich auch hier vorhanden, doch die einzelnen Nutzer reflektieren über die Ergebnisse nicht so, wie es Wissenschaftler tun, die auf Qualität achten.
Dadurch werden alle möglichen und unmöglichen KI-Resultate weitergegeben und sind dann wiederum Bestandteil der nächsten Ergebnisse. In dem gesamten System entsteht so eine Unschärfe, die auch zu Manipulationen genutzt werden kann.
Source: Illustration of the relative prominence of four forms of disciplinary approach in the scientific literature, both in terms of when they are referred to in isolation and when they are referred to in combination. The numbers represent the count of documents returned when searching the Scopus database for each term using Boolean operators (title, abstract and keywords from 1954 until the search date of February 2023).(Crilly, N. 2024)
Das Handeln wird oft vom Denken bestimmt, und das Denken wiederum vom Handeln. Insofern ist es nicht ungewöhnlich, wenn das Denken (Thinking) in verschiedenen wissenschaftlichen Veröffentlichungen untersucht wird. Dabei gibt es sehr viele spezifische Ansätze wie Design Thinking, Computational Thinking, Entrepreneurial Thinking und Systems Thinking (Diese vier stellen eine Auswahl dar).
Jetzt sollte man meinen, dass es in der heutigen Zeit darum geht, über die jeweiligen Ansätze hinaus, Vernetzungen mit anderen Ansätzen in wissenschaftlichen Veröffentlichungen zu beachten. Dass dem nicht so ist, zeigt die Abbildung. Wie der Beschreibung zu entnehmen ist, wurde ein sehr lange Zeitraum (1954-2024) untersucht.
„Denning and Tedre do not then analyse or compare these various disciplinary approaches or the projects they originate from, but they do acknowledge that variety, which is seemingly very rare. In fact, just conducting simple literature searches for works on disciplinary approaches reveals the very small number of those works that focus on two or more approaches in comparison to those that focus on just one approach (see Figure). Similarly, it can be observed that even the most cited works describing one disciplinary approach (e.g.Wing’s description of computational thinking) are seldom cited in works describing other disciplinary approaches (e.g. various descriptions of design thinking)“ (Crilly, N. 2024).
Auch hier ist wieder zu erkennen, das jede Perspektive für sich beansprucht, die richtige, bzw. die beste zu sein. Immer unter der Überschrift „One Size Fits All“. Das wird allerdings der Komplexität unseres Lebens (Arbeitslebens) nicht gerecht, und bestätigt wieder eine Art Silo-Denken (Thinking). Wissenschaftliches Arbeiten sollte zeigen, dass es auch anders geht. Bisher kann das noch nicht nachgewiesen werden.
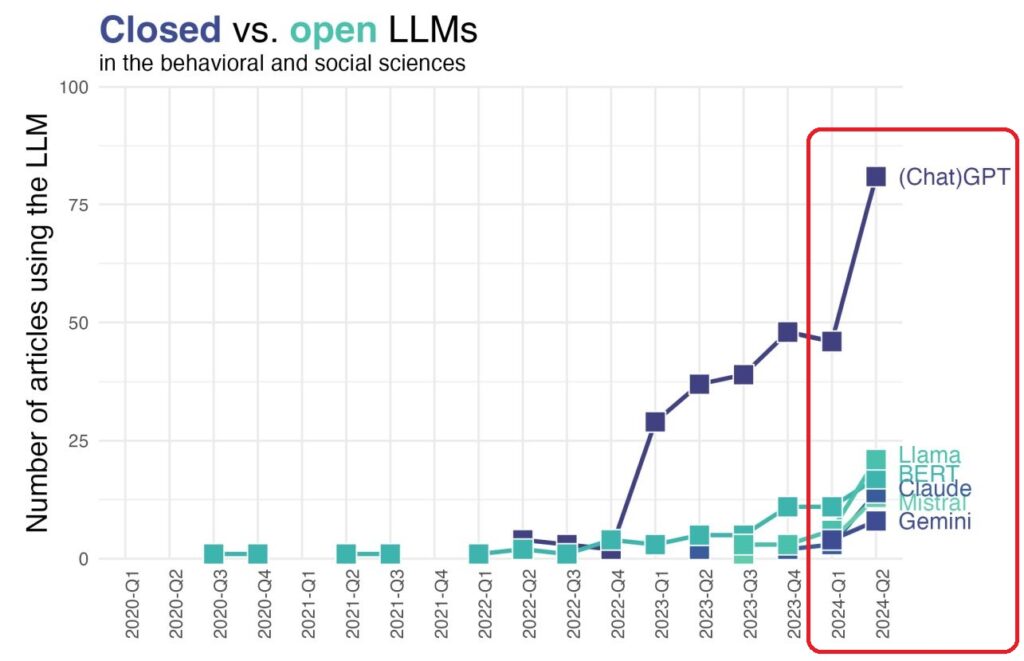
Usage of large language models (LLMs) in behavioral and social sciences research (Wulff/Hussain/Mata 2024). Die Hervorhebung in Rot ist von mir (Robert Freund) ergänzt worden.
Natürlich verwenden immer mehr Wissenschaftler Künstlichen Intelligenz in ihrer Arbeit. Wie die Grafik zeigt, wird ChatGPT beispielsweise in den Verhaltens- und Sozialwissenschaften sehr stark genutzt. ChatGPT ist allerdings von OpenAI, dessen Large Language Model (LLM) als eher geschlossenes System (Closed LLM) bezeichnet werden kann, da das zugrundeliegende Datenmodell nicht transparent ist. Andere LLM – wie z.B. LLama – sind eher offen LLM (Open LLM), die gerade für Forschung und Wissenschaft geeigneter erscheinen.
„Academic research should prefer open LLMs because they offer several practical and ethical advantages that are essential for scientific progress.
First, open models provide the transparency necessary for thorough scrutiny, allowing researchers to understand better the tools they are using and ensuring accountability.
Second, this transparency, combined with the adaptability of open models, facilitates innovation by enabling researchers to customize models to meet specific needs and explore new applications (Wulff & Mata, 2024).
Third, open LLMs support reproducibility, a cornerstone of scientific research, by allowing other researchers to replicate and build upon existing work.
Finally, the ethical implications of AI usage are better managed with open models, as they enable greater scrutiny of AI decisions, arguably reduce the risks of deploying biased or unethical systems, and avoid giving away data to further train closed, proprietary models.“
Ich frage mich an dieser Stelle, ob solche Hinweise nicht auch für die Nutzung von Künstlicher Intelligenz in Unternehmen gelten sollten.