Warum sollte man sich mit Open User Innovation befassen?

(c) Dr. Robert Freund

Auf der MCP 2026 in Balatonfüred (15.-19.09.2026) ging es um Customization and Personalization. Mit meinem Paper Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework konnte ich aufzeigen, welche Möglichkeiten es heute für User gibt, ihre Ideen in einem Personal Fabrication Framework umzusetzen.

Ich werde immer wieder darauf angesprochen, ob es sich lohnt, sich mit User Innovation – speziell mit Open User Innovation nach Eric von Hippel – zu befassen. Immerhin sind Unternehmen, Institutionen zur Förderung von Innovation und auch Universitäten eher an dem klassischen Innovationsansatz interessiert, der von Schumpeter geprägt ist. An Universitäten forschen Professoren und Studenten beispielsweise gerne an innovativen Projekten für Unternehmen, da sie (Professoren und Studenten) sich hiervon Finanzmittel und möglicherweise auch Jobs versprechen.

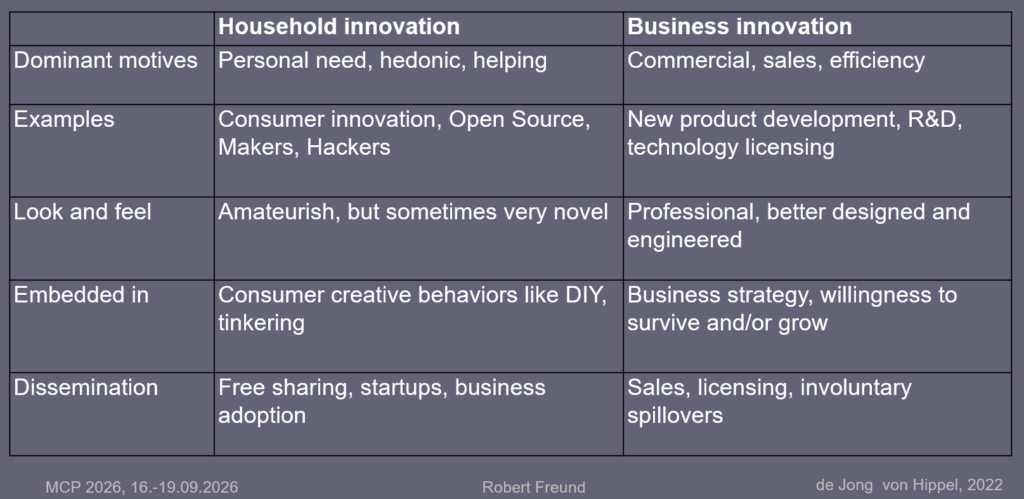
Das ist durchaus verständlich, doch zeigen verschiedene Entwicklungen in der Innovationsforschung auf, dass von Unternehmen skalierte Innovationen oft von Usern ausgegangen sind. Es lohnt sich daher auch für Unternehmen, sich mit User Innovation zu befassen. Die Abbildung stellt noch einmal die unterschiedlichen Ansätze von User Innovation (Household Innovation) und Business Innovation gegenüber.

Einerseits können User immer mehr Ideen selbst herstellen, andererseits gibt es immer weniger Unternehmen, die wirklich innovativ sind (Innovationsmilieu, Bertelmann 2025). Zwischen beiden Polen existiert ein Kontinuum an Möglichkeiten. Almudi et al. haben 2026 dazu ein Paper veröffentlicht, in dem sie aufzeigen, wie ein theoretischer Rahmen dazu aussehen kann:

„It has sometimes been argued that von Hippel innovation is very small relative to typical expenditures on an innovation project by a firm. This observation is correct but is, we think, the wrong way to judge importance. User innovation should be seen as a scanning and prototyping function, involving tens of millions of individuals continuously exploring the frontiers of the desirable and possible. Producer innovation, in contrast, focuses investment in specific development areas where user-innovators have identified signals of commercialization gold“
Almudi et al. (2026). Open user innovation, producer innovation and industrial dynamics: An ABM approach.

Auf dieses Framework werde ich in weiteren Blogbeiträgen noch einmal eingehen.

Gedanken zu Künstlicher Intelligenz und Wissensarbeit

AdobeStock_192581451-1024×614-1

Es wird immer deutlicher, dass Künstliche Intelligenz in allen Lebensbereichen Einfluss nimmt. In Prozessen, in denen Wissen (explizit es Wissen, implizites Wissen) eine wichtige Rolle spielt. kann Künstliche Intelligenz in der Zwischenzeit viele Aufgaben übernehmen, die bisher Experten mit ihrem besonderen Wissen vorbehalten waren.

Künstliche Intelligenz ist somit nicht nur für explizierbares Wissen geeignet, das artikuliert und in Daten und Informationen dargestellt wird, sondern auch für domänenspezifisches Wissen – der Expertise. Das ist ein großer Unterschied zu traditionellen IT-Systemen oder auch Expertensystemen.

„Massive impact on knowledge work. Where earlier waves of automation transformed physical labour, AI is the first to massively affect cognitive and creative work, including writing, programming, legal analysis, medical diagnostics, scientific discovery, forecasting and image generation“ (UN, 2026).

Da es in diesem Beitrag um Wissensarbeit geht, kommt jetzt der Begriff der Arbeit ins Spiel. Arbeit wird heute meistens als Erwerbsarbeit interpretiert, die dazu geeignet sein soll, den Lebensunterhalt zu bestreiten.

Wenn Wissen immer nur in Bezug auf Arbeit, und den damit verbundenen Prozess gesehen wird, und Künstliche Intelligenz einen Großteil übernehmen oder ersetzen kann, wird es für Wissensarbeiter natürlich problematisch. Viele Studien zeigen daher auch in der aktuellen Debatte auf, welche Berufsbilder von dieser Entwicklung stark oder weniger stark betroffen sein werden. Dabei bin ich der Meinung, dass es nicht immer um gesamte Berufe geht, sondern um viele einzelne, eher kleine Tätigkeitsbereiche – also um ein Tätigkeitsportfolio.

Möglicherweise wird es Zeit darüber nachzudenken, ob Arbeit im Sinne einer Erwerbsarbeit weiterhin die Basis für das Bestreiten des Lebensunterhaltes sein sollte, ja sogar sein kann. Wenn jede Art von Erwerbsarbeit von Künstlicher Intelligenz – und bald von KI-Robotern – beeinflusst und ersetzt werden kann, ist der Bezugspunkt der Erwerbsarbeit für die Sicherung unseres sozialen Systems nicht mehr geeignet. Die Struktur der Einnahmenseite und die Struktur der Ausgabenseite müssen gleichzeitig angegangen werden. Erste zarte Anzeichen für alternative Konzepte gibt es schon.

Es ist allerdings auf Grund der demographischen Struktur in Deutschland sehr schwierig, mögliche Lösungen umzusetzen, da der überwiegende Teil der Wählerschaft in einem alter ist, die ihr Leben auf Erwerbsarbeit aufgebaut haben. Diese älteren Menschen haben ein sehr eingefahrenes Deutungsmuster, das nicht so einfach veränderbar ist.

Ist Künstliche Intelligenz magisch oder sogar mystisch?

Image by Michaela ? from Pixabay

In dem Blogbeitrag Künstliche Intelligenz: Von der Antike über das Mittelalter bis zum Dartmouth College habe ich aufgezeigt, dass es schon lange Konzepte zum Thema gibt und Künstliche Intelligenz erst seit 1956 eine akademische Disziplin wurde.

Diese Betrachtung rüttelt an der von Big Tech immer wieder verbreiteten Meinung, dass Künstliche Intelligenz in der Geschichte der Menschheit etwas Einmaliges, Unvergleichbares ist – für das es noch keine gesellschaftlichen Regeln gibt.

Dadurch, dass Big Tech ihre Modelle nicht transparent macht (Closed Source AI) umgibt sie eine Aura des Mystischen, des Magischen. Wenn sie die Modelle transparent machen würden, wie es Open Source AI Modelle vormachen, so würde man erkennen, dass da nichts dergleichen ist.

Die in den Jahrzehnten immer wieder genannte geheime Formel für die Herstellung von Coca Cola war auch so eine Vorgehensweise des Storytellings. Es ist und bleibt „nur“ geschicktes Marketing.

Auch lehrt uns die Geschichte, dass es den Menschen in ihren gesellschaftlichen Strukturen bisher immer gelungen ist, Regelungen zu finden, um neue Technologien zu nutzen, und gleichzeitig gesellschaftliche Auswirkungen zu dämpfen.

„The question is, hence, how to avoid the trap of treating AI as entirely novel, while at the same time being sufficiently mindful of the very concrete ways in which it can (adversely) affect society, and ensuring tailored governance mechanisms to counter potential harms“ (Smuha 2025).

Aktuell gibt es ein Ungleichgewicht in den Diskussionen, denn Big Tech dominiert die Debatte und möchte damit auch die gesellschaftlichen Strukturen wie gewünscht anpassen. In den USA sehen wir, wie das alles funktionieren soll.

In Europa haben wir die Chance, beide Extreme zu einem Kontinuum der Möglichkeiten für die sinnvolle gesellschaftliche Nutzung von Künstlicher Intelligenz zusammenzuführen. Es wundert nicht, dass Big Tech davon nicht begeistert ist. Doch immer mehr Menschen und Organisationen in Europa erkennen, dass eine Abhängigkeit von den Big Tech Denkmustern nicht unbedingt gut ist. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Gefühlt nennt sich heute jeder in der Geschäftswelt KI-Experte

Image by Md Ishak Rahman from Pixabay

Es ist einfach nur interessant zu beobachten, wie sich die Muster ähneln. In den 90er Jahren waren es die Lean-Experten, dann die Experten für Agilität in den Organisationen und jetzt ist es eben das Attribut „KI-Experte“, das den Markt überschwemmt. Da sich jeder so nennen darf, wird es eben auch gemacht.

Ich stelle mir dabei oft die Frage, in welchen Teilgebieten des gesamten Feldes der Künstlichen Intelligenz will denn diese Person Experte sein, und was macht diese Person zu einem Experten?

Die eigene Zuschreibung reicht dafür nicht aus, denn richtige Experten werden von anderen dazu gemacht – es ist also eine Zuschreibung von anderen.

Experten werden von anderen gesucht und möglicherweise auch gefunden. Manche davon wissen gar nicht, dass sie in diesem Sinne Experten sind, geschweige denn nennen sie sich so.

Ein Beispiel für „richtige Experten“ kennen wir aus dem Bereich Innovationen – und hier speziell User Innovation. Diese Personen können durch ein spezielles Suchverfahren erkannt werden:

„Pyramiding search is a variant of snowballing – but with an important difference. Pyramiding requires that people having a strong interest in a given attribute or quality, for example a particular type of expertise, will tend to know of people who know more about and/or have more of that attribute than they themselves do (von Hippel et al 1999)“. zitiert von von Hippel/Franke/Prügl 2009).

Das Attribut „KI-Experte“ ist letztendlich das, was es ist: ein Marketingansatz. – nicht mehr und nicht weniger.

Lassen Sie andere darüber entscheiden, ob Sie ein KI-Experte sind.

Weitere Blogbeiträge zum Thema Expertise finden Sie hier.

Künstliche Intelligenz: Von der Antike über das Mittelalter bis zum Dartmouth College

Conceptual technology illustration of artificial intelligence. Abstract futuristic background

Wenn es um Künstliche Intelligenz geht wird fast immer davon geschrieben oder gesprochen, dass die Konferenz am Dartmouth College in den Jahren 1955 und 1956 (Konferenz) der Beginn dieser akademischen Disziplin war.

In dem Cambridge Handbuch Smuha, N. A. (Ed.) (2025): Cambridge Handbook of THE LAW, ETHICSAND POLICY OF ARTIFICIAL INTELLIGENCE weist die Autorin Nathalie A. Smuha zwar auch darauf hin, erweitert den Blick allerdings auch auf frühere Entwicklungen zum Thema.

Smuha zeigt auf, dass es schon in der griechischen Antike erste Überlegungen, zum Thema gab:

„First, it should be born in mind that the history of AI as a concept dates back at least to antiquity, where myths already existed about “automata” or self-operating machines displaying human behavior“ (ebd.).

Anschließend gibt es einen Hinweis auf die Entwicklungen im Mittelalter. Zu der Zeit lebte Ismail al Jazzi, der Vater der Robotik.

„The human drive to transgress the boundaries of the natural and the artificial and to create “intelligent” machines by no means diminished in the Middle Ages. For instance, in 1206, Ismail al-Jazari, an Arab polymath from Mesopotamia who is described as the “father of robotics,” wrote the Book of Knowledge of Ingenious Mechanical Devices, including detailed accounts of how to construct musical robot hands and drink-serving waitresses“ (ebda.).
Footnote: Shahino Mah Abdullah, “Intelligent robots and the question of their legal rights: an Islamic perspective (2018) ICR Journal, 9(3): 394–397.

Und zeitlich anschließend, natürlich der Verweis auf das Dartmouth College und der Konferenz in 1955:

„Artificial intelligence (AI) was founded as an academic discipline almost 70 years ago, when a conference took place at Dartmouth College“ (Smuha 2025).
Footnote: John McCarthy, Marvin Minsky, Nathaniel Rochester, and Claude Shannon, Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, August 31, 1955 (ebd.).

Die Unterscheidung zwischen den Konzepten aus der Antike und dem Mittelalter und der nach Dartmouth entstandenen akademischen Disziplin ist sehr wertvoll. Zeigt sie doch, dass neue, umwälzende technologische Entwicklungen ihren Ursprung schon weitaus früher hatten, und zwar oft als erste Konzepte.

Künstliche Intelligenz als Konzept hat eine sehr lange Geschichte.

Diese Erkenntnis steht im Gegensatz zu der immer wieder – gerade von Big Tech – genannten Einmaligkeit von Künstlicher Intelligenz in der Geschichte der Menschheit.

Für eine Aufgabe das geeignete KI-Modell mit dem Smart Router in Langflow auswählen

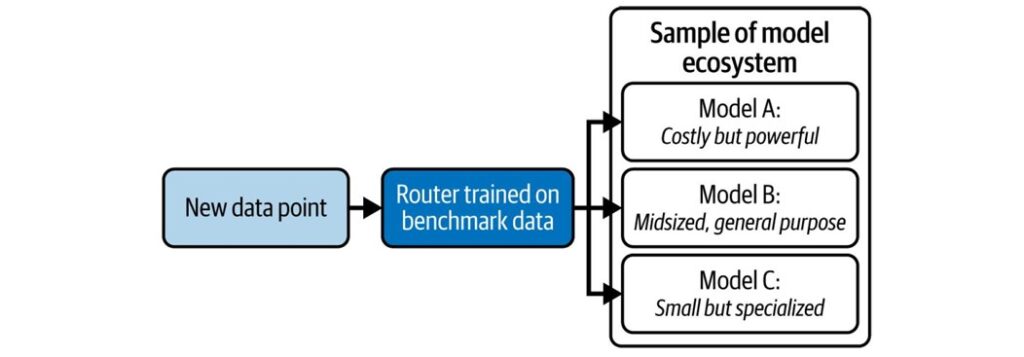
An AI router that understands the capabilities of models in its library directs
a given inference request to the best model able to perform the task at hand (Thomas et al. 2025)

Es ist in Organisationen nicht mehr zeitgemäß, alle anfallenden Aufgaben (Tasks) von einem sehr großen und Leistungsfähigen KI-Modell bearbeiten zu lassen. Dieses „One Size Fits All“ führt nur zu einem erhöhten Ressourcenverbrauch und damit zu hohen Kosten.

Besser ist es, für jede Anfrage das geeignete Modell auszuwählen. In dem Beitrag Künstliche Intelligenz: Mit einem AI Router verschiedene Modelle kombinieren hatte ich diese Vorgehensweise grob dargestellt. Die Abbildung zeigt das prinzipielle Vorgehen: Ein AI Router entscheidet auf Basis von Vorgaben, welches KI-Modell für den Task geeignet erscheint.

Da wir auf Open Source Software und Open Source AI setzen, ist es interessant, dass Langflow nun die Möglichkeit bietet, einen Smart Router zu nutzen. Basis ist dabei die schon vorhandene Wenn > Dann (If-Else) Funktion.

„The Smart Router component is an LLM-powered variation of the If-Else component. Instead of string matching, the Smart Router uses a connected Language Model component to categorize and route incoming messages“
Langflow. (o. D.). Quickstart. Langflow Documentation. Abgerufen am 16. Oktober 2026, von https://docs.langflow.org/get-started-quickstart)

Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Personalisierung von Software: Kann bald jeder mit KI seine eigene Software erstellen? Warum eigentlich nicht?

Image by Pexels from Pixabay

Immer mehr User (Nutzer) entwickeln ihre eigenen Produkte, da die Unternehmen mit ihren begrenzten Ressourcen (fixed innovation space) und Renditeüberlegungen oftmals Ideen von Usern nicht umsetzen. In meinem Paper zur MCP 2026 habe ich das ausführlich hergeleitet und beschrieben:

Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework. Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 76-85 · 17. Sep. 2026

Die Konferenzreihe legt seit 2004 alle 2 Jahre den Fokus auf (Mass) Customization and Personalization. – siehe MCP-CE.org. Dabei ging es in der Vergangenheit meistens darum herauszufinden, wie Unternehmen mit neuen Technologien – und jetzt auch mit Künstlicher Intelligenz – (massenhaft) individuelle Produkte und Dienstleistungen anbieten können – zum Preis von Standardprodukten.

In meinem Paper habe ich den Ansatz Customization and Personalization aus der Perspektive eines Users dargestellt: Open User Innovation. An mehreren Beispielen konnte ich aufzeigen, wie es in den letzten Jahren einen Paradigmenwechsel gegeben hat. User sind heute immer mehr in der Lage, ihre Ideen selbst umzusetzen. Dabei helfen natürlich die niederschwelligen Technologien der Maker Bewegung und Künstliche Intelligenz, um die vielen Hürden im Prozess der persönlichen Fabrikation zu überwinden.

Über meine in dem Paper genannten Beispiele hinaus, wird nun auch deutlich, dass es in Zukunft auch möglich sein wird, seine eigene Software von Künstlicher Intelligenz „bauen“ zu lassen. Lange genug haben wir uns den etablierten Softwareanbieter angepasst, ja geradezu unterworfen.

Wenn über 97% der Codebasis von Software Open Source ist, sollte es möglich sein, aus diesen Bausteinen seine eigene Software zusammenzustellen. Künstliche Intelligenz kann hier bei den Schnittstellen und möglichen rechtlichen Fragen helfen.

„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).

Auch die aktuellen Entwicklungen beim Vibe Coding gehen in diese Richtung. Dabei wird mit Hilfe eines Prompts der Quellcode von Künstlicher Intelligenz generiert. Warum eigentlich nicht?

Ich bin gespannt, was es in diesem Bereich noch für überraschende neue Chancen für die „Herstellung“ eigener Produkte und Dienstleistungen geben wird. Ganz im Sinne einer Open User Innovation, die sich von den etablierten Unternehmensangeboten löst, und eigene Lösungen entwickelt und nutzt.

Es gibt durchaus immer mehr Forscher, die schon eine Veränderung in den ökonomischen Bereichen sehen: Von der Market Economy zur Self-organized Gift Economy.

Fünf neue KI-Modelle aus Europa in unsere Open Street Map aufgenommen

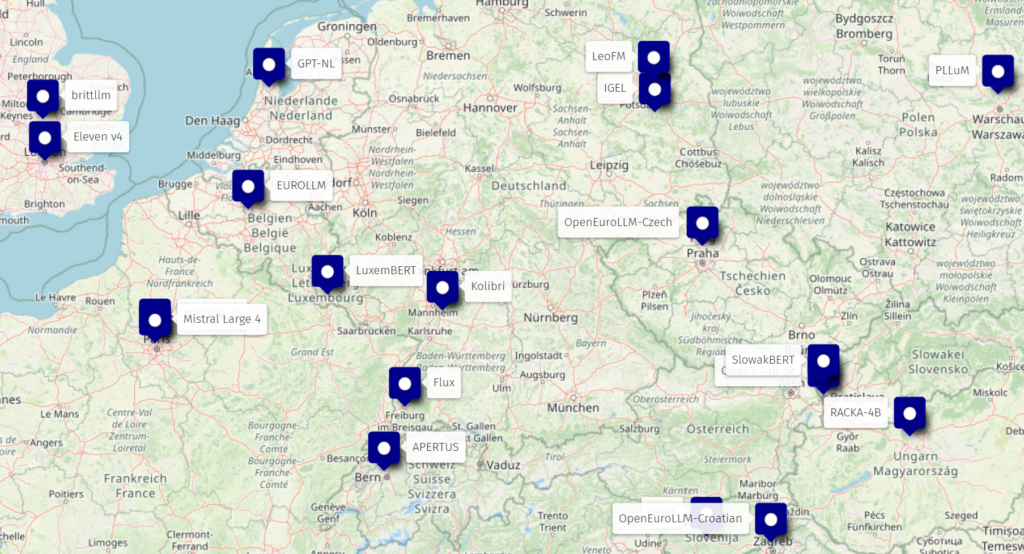
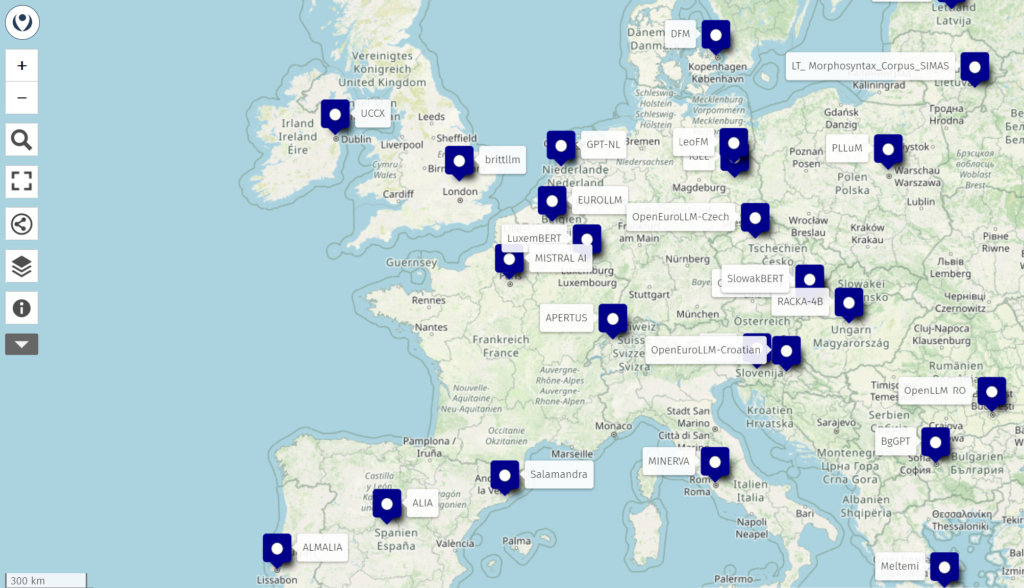
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Immer mehr KI-Modelle aus Europa kommen auf den Markt. Alleine vom 22. September bis 06.10.2026 wurden fünf neue Modelle veröffentlicht (KI-News von Thomas Ertl, 08.10.2026 auf LinkedIn).

In der folgenden Tabelle sind die Modelle, das Land und unter Bemerkungen, die Zugangsform (Open Source, Open Weight oder nur per API) angegeben. Die KI-Modelle sind direkt verlinkt.

KI-ModellLandBemerkung
KolibriAleph Alpha, Heidelberg, DeutschlandOpen Source
Flux 3 ActionBlack Forest Labs, Freiburg, DeutschlandOpen Weight
Flux 3 ImageBlack Forest Labs, Freiburg, DeutschlandAPI
Eleven v4ElevenLabs, London, UKAPI
Large 4Mistral, Paris, FrankreichOpen Weight
Europäische KI-Modelle, veröffentlicht im Zeitraum vom 22.09.-06.10.2026

Weiterhin haben wir diese Modelle in unsere Open Street Map mit aufgenommen, in der viele länderspezifische KI-Modelle zu finden sind. Die Map zeigt die dynamische Entwicklung in Europa, und den Trend zu mehr Digitaler Souveränität bei KI-Modellen.

Für die meisten Anwendungen ist es nicht erforderlich, das beste und größe Modell zu haben. Es geht vielmehr darum, ein KI-Modell zu nutzen, das vertrauenswürdig ist, in Europa gehostet wird und transparent zeigt, wie mit Daten umgegangen wird.

Ein gutes KI-System im Unternehmen schlägt dabei den Ansatz, alles im Unternehmen einem gigantischen KI-Modell wie Claude von Anthropic, Gemini von Google, ChatGPT von OpenAI etc. unterzuordnen. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz: Welcher Mensch?

Atari et al. (2023): Which Human? [PDF]

Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.

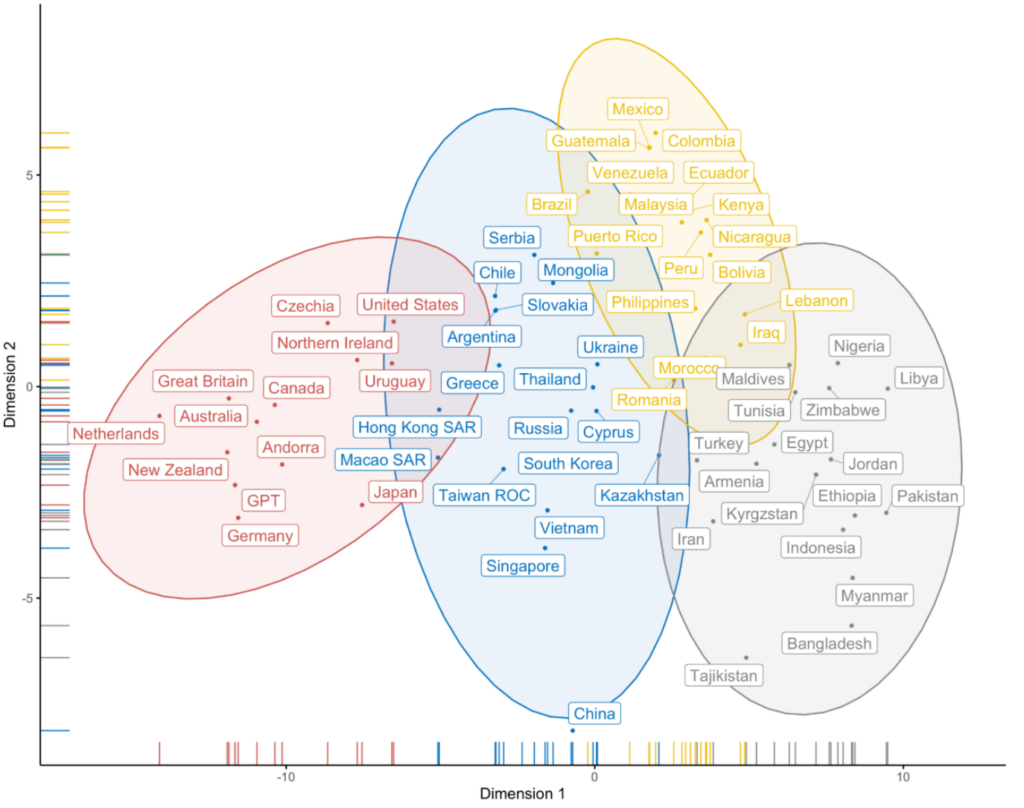
In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).

Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.

Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#5/46.052101/6.218511

Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

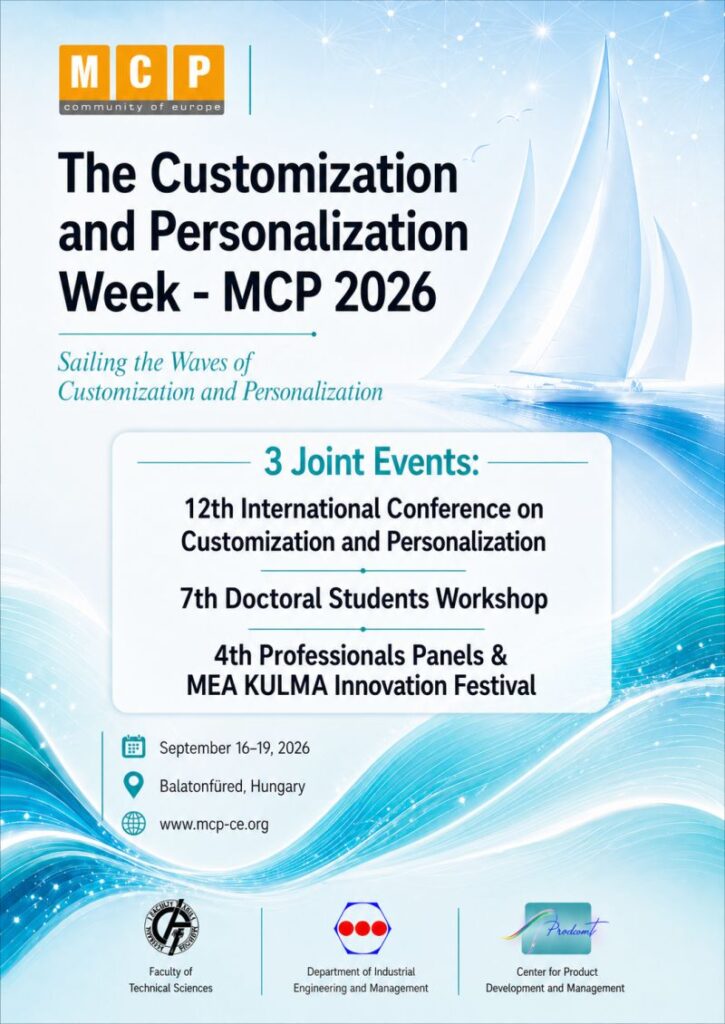
MCP 2026: The Customiztaion and Personalization Week

In der nächsten Woche trifft sich die Customization und Personalization Community auf der MCP 2026. Die letzten Konferenzen, die seit 2004 alle 2 Jahre stattfinden, hatten wir an der Technischen Universität Novi Sad (Serbien) durchgeführt. Da die Gesamtsituation an der Universität für Lehrende und für Studenten immer schwieriger wurde, haben wir uns dazu entschlossen, diesmal nach Balatonfüred in Ungarn auszuweichen.

Wie nach allen letzten Konferenzen auch werden wir auch nach der MCP 2026 ausführlich über alle Themen reflektieren. Als Initiator der Konferenzreihe, die in Rzeszow (Polen) in 2004 begann, kann ich mich nur bei allen bedanken, die diese Konferenzreihe schon so lange mit ihrer Teilnahme unterstützen.

Wir (Jutta und ich) freuen uns schon jetzt, die Kollegen und Freunde in der kommenden Woche in Balatonfüred zu treffen. Auf der Konferenz stelle ich zwei Paper vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework