Speech bubbles, blank boards and signs held by voters with freedom of democracy and opinion. The review, say and voice of people in public news adds good comments to a diverse group.
In meinem Blogbeitrag vom 24.10.2026 ging es um Cyberself und Personalisierung. Dabei wurde herausgestellt, dass Menschen und KI-Systeme durchaus mehrere „Persönlichkeiten“ haben können, wobei der Begriff bei Menschen und KI-Modellen unterschiedlich ist.
Wenn Menschen also KI-Modelle als Interaktionspartner nutzen, passen sich die KI-Systeme dem Nutzer an, wodurch eine Art Zuschreibung einer „Persönlichkeit“ durch den Nutzer entsteht. Manche Nutzer schreiben das KI-Modell auch in damit verbundenen Texten (Prompts) an.
Dadurch entsteht eine Interaktion der Bestätigung, die kritische oder konfliktträchtige, emotionale – eben menschliche – Interaktionen verkümmern lässt. Treffen die Personen, die ihre KI-Modelle und -Agenten als Partner sehen, auf die reale menschliche Welt, kann es zu antisozialen Reaktionen kommen.
„Zusammengefasst ist KI kein neutraler Interaktionspartner, sondern ein sozial wirksamer Akteur, dessen Effekte maßgeblich durch seine Funktionslogik, sein Trainingsziel und sein Interaktionsdesign bestimmt werden. Anwendungen, die primär auf Zustimmung und Konfliktvermeidung ausgelegt sind, riskieren langfristig eine Schwächung der Selbstreflexion, Perspektivenvielfalt und sozialen Konfliktfähigkeit sowie eine Verschiebung sozialer Bindungen weg von menschlichen Beziehungen. Aufklärung über Konsequenzen und die Stärkung individueller Kompetenzen sind zentral“ (Glöckner et al., 2026).
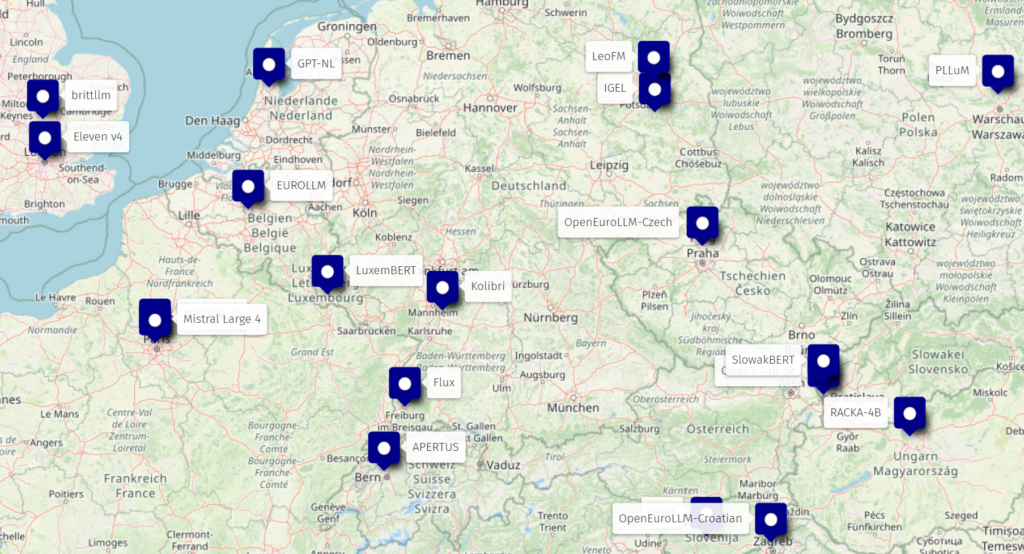
Es bieten sich daher verschiedene europäischen KI-Modelle an (Open Weight und Open Source), die ich auf einer Open Street Map zusammengetragen habe:
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089
Wenn es um Künstliche Intelligenz geht, werden oftmals Begriffe benutzt, die in der Diskussion beliebig verwendet werden. Wenn es beispielsweise um den Begriff „Lernen“ geht, vermuten viele, dass es sich beim maschinellen Lernen um eine Art menschliches Lernen handelt. Durch Verkürzungen in den Beschreibungen werden (manchmal bewusst) Begriffe synonym verwendet. BTW: Joe Pine hat dieses Phänomen in Bezug auf Mass Customization and Personalization als Bastardization bezeichnet.
Wenn es um den Begriff „Lernen“ geht, haben Knauff et al. in ihrem aktuellen Paper folgendes deutlich gemacht:
„Der Unterschied ist dennoch entscheidend: anders als bei KI Systemen, zielt menschliches Lernen darauf ab, strukturierte, handlungsrelevante mentale Modelle in einer verkörperten Umwelt aufzubauen (Bohn, & Casillas, 2026; Butz & Kutter, 2017). Es geht um den aktiven Erwerb von Wissen und Überzeugungen, die zielgerichtete Entscheidungen in der physikalischen und sozialen Welt leiten. Maschinelles Lernen hingegen ist meist passiv: vorgegebene Daten werden genutzt, um die Parameter des vorgegebenen Modells zu optimieren.“ M. Knauff, M. V. Butz, B. Kaup, W. Kunde, and und I. Scharlau, “Vorhersage ist nicht Erklärung: Eine Perspektive der Fachgruppe Allgemeine Psychologie (gemeinsam mit der Gesellschaft für Kognitionswissenschaft),” Psychologische Rundschau, vol. 77, no. 4, pp. 225–231, Oct. 2026, doi: 10.1026/0033-3042/a000781.
Die Autoren widersprechen also der landläufigen Meinung, und den Marketingversprechen von Big Tech, in diesem Fall deutlich. Doch: Warum wird dennoch versucht, technische Systeme wie Menschen zu sehen? Indem technische Systeme punktuell mit der Leistungsfähigkeit von Menschen verglichen werden wird deutlich, wie unterlegen der Mensch gegenüber solchen Systemen ist, denn Künstliche Intelligenz kann vieles besser und schneller als es der Mensch jemals können wird. Es geht um die Dominanz der Technologie über den Menschen.
So eine Herangehensweise ist ein bewusster Kategorienfehler, wie von Knauff et al. alleine beim Begriff des „Lernens“ dargestellt wurde. Auch andere haben in der letzten Zeit große Bedenken, wenn es darum geht, die Leistungsfähigkeit von technischen Systemen mit der von Menschen zu vergleichen. Siehe dazu auch
Wenn es um Künstliche Intelligenz geht, wird meistens über die technologischen Möglichkeiten gesprochen und geschrieben. Es geht um Leistungsvergleiche zwischen KI-Modellen, und um KI-Agenten mit ihrem Verbrauch an Tokens – um nur einige wenige Aspekte zu nennen.
Auf der anderen Seite geht es immer mehr Leuten auch darum zu analysieren, welchen Einfluss Künstliche Intelligenz auf die Gesellschaft, also auf soziale Systeme hat. Es geht hier um Regulierungen, Recht, Moral, Ethik usw.
In dem Beitrag Künstliche Intelligenz ist untrennbar in die Gesellschaft eingebettet – oder umgekehrt? habe ich die Wechselwirkungen der beiden Pole Technik und Gesellschaft thematisiert. Zwischen den beiden Dimensionen gibt es – wie immer – ein Kontinuum an Möglichkeiten der Gestaltung. Dabei geht es also nicht alleine um die Gestaltung der Technologie, sondern gleichzeitig auch um die Gestaltung des sozialen Raums, in dem KI eingebettet ist.
Es liegt daher auf der Hand, in die Gesellschaft eingebettete Künstliche Intelligenz als soziotechnisches System zu betrachten. Genau das haben Glöckner et al. in einem frei verfügbaren Paper gemacht.
„Der vorliegende Beitrag betrachtet Künstliche Intelligenz (KI) als ein soziotechnisches System, das verschiedene Auswirkungen auf soziale Interaktionen und die Gesellschaft als Ganzes hat. Auf Basis aktueller empirischer Befunde werden verschiedene mögliche Auswirkungen von KI in den Bereichen (1) soziale Wahrnehmung, (2) soziales Urteilen und Entscheiden sowie (3) Gruppenprozesse, gesellschaftlicher Zusammenhalt und Macht diskutiert.“ A. Glöckner et al., “Künstliche Intelligenz als soziotechnisches System: Eine Perspektive der Fachgruppe Sozialpsychologie,” Psychologische Rundschau, vol. 77, no. 4, pp. 216–224, Oct. 2026, doi: 10.1026/0033-3042/a000780.
Wenn es irgendwo nicht so läuft, wie man sich das vorstellt, kommt immer wieder die gleiche Antwort: Das System benötigt eben mehr Geld. Vergleichen wir unsere Systeme europaweit oder weltweit, so stellen wir oft fest, dass genügend Geld im System sein sollte – manchmal sogar zu viel Geld im System ist. Schauen wir uns einfach einmal an, warum wir immer wieder den Fokus auf Teilsysteme und nicht auf das Gesamtsystem richten.
Wenn wir uns die Medienlandschaft ansehen, geht es im Tagesgeschäft häufig darum, die Menschen aufzuscheuchen (Emotional zu packen) um Aufmerksamkeit und damit Klickraten zu generieren. Da beschweren sich beispielsweise die Landwirte, weil es regnet oder eben nicht, die Autofahrer, dass Benzin und Diesel teurer werden, dass die Lebensmittel schlechter und teurer werden, das Bildungssystem seit den 60er Jahren immer schlechter wird, das Sozialsystem und das Gesundheitssystem seit Jahrzehnten ausufern, unsere Energie- und Kommunikationssysteme zu sehr abhängig sind von anderen, unser Finanzsystem …. usw. usw.
Wie Sie der kleinen Auflistung entnehmen können, kommt häufig der Begriff „System“ vor. Im klassischen Problemlösungsansatz der Industriegesellschaft, ist es ganz einfach: Durch das Optimieren einzelner Bauteile wird das gesamte Produkt (System) optimiert. Das ist allerdings bei genauerer Betrachtung von Systemen ein gravierender Trugschluss.
Die isolierte Optimierung einzelner Teile führt oft zu einer Verschlechterung des Gesamtsystems. Ineffizienz entsteht somit aus Schnittstellenproblemen und mangelnder Kommunikation im Gesamtsystem.
Einige (kleine) Beispiele: (1) Eine Optimierung in einem isolierten landwirtschaftlichen System, in dem es fast ausschließlich um die Wirtschaftlichkeit geht, führt zu erhöhten Kosten im Gesundheitssystem. Industriell hergestellte Lebensmittel machen viele Menschen krank, und das seit Jahrzehnten. (2) Eine betriebswirtschaftliche Optimierung des Bildungssystems anhand industrieller Kennzahlen, führt zu erhöhten Kosten im Sozialsystem und dort wiederum zu einem Lock-in ganzer Familiengenerationen, die dann von sozialer Unterstützung abhängig werden. (3) Überall kritiklos Künstliche Intelligenz einzusetzen, führt zu erheblichen Vorteilen in manchen Bereichen, kann allerdings eine Gesellschaft insgesamt auf Grund der Schnelligkeit von Veränderungen überfordern – usw. usw.
Sicher sehen Sie in Ihrem Umfeld auch, wie alles mit allem zusammenhängt. Diese Vernetzungen sind über die Jahrzehnte immer mehr geworden, sodass die Komplexität in vielen Bereichen im Vergleich „zu früher“ erhöht ist. Komplexes Problemlösen unterscheidet sich allerdings fundmental von einfachem Problemlösungen.
Viele Menschen sind es nicht gewohnt in Systemzusammenhängen zu denken und zu handeln, da sie die einfachen Ursache-Wirkungs-Zusammenhänge aus der industriell geprägten Ära verinnerlicht haben. Dabei vertrauen Sie gerne einfachen Problemlösungen – auch gerne Stammtischparolen – weil diese vorgaukeln, dass die Lösung an einer bestimmten Stelle zu finden ist. Das möchte ich an dieser Stelle nicht weiter ausführen.
Neue Fragen werden mit alten Lösungen angegangen. Es werden beispielsweise keine Systemanpassungen vorgenommen, sondern es wird erwartet, dass sich der Mensch an die neuen Herausforderungen anpasst. Wie Matthiesen et al, es formulieren: Eine Aufgabe, an der man nur scheitern kann:
„Zu den Missverständnissen, die das Dasein in Unternehmen, Universitäten, Behörden, NGOs, Theatern, Schulen und anderen Organisationen unnötig schwer machen, gehört die Annahme, Kern und Kernproblem einer Organisation seien die Menschen, die in ihr arbeiten. Diese Unterstellung macht den Einzelnen zum Puffer, der genötigt wird, jedes Organisationsversagen aufzufangen – eine Aufgabe, an der man nur scheitern kann. Statt das Verhalten des Einzelnen heroisch zu glorifizieren oder therapeutisch zu problematisieren, interessieren uns die Verhältnisse, in denen sich dieses Verhalten abspielt.“ (Matthiesen, K., Muster, J., Laudenbach, P. (2022). Die Humanisierung der Organisation. München: Vahlen).
Eine Systembetrachtung, die das Wohl der Menschen und der Umwelt zum Ziel hat, führt zu ganz anderen Herausforderungen (Systemsteuerungen) als einfach nur das Platte „wir brauchen mehr Geld“.
Manchmal habe ich den Eindruck, es geht aktuell nur noch um Künstliche Intelligenz – in dem Sinne: Wir machen alles, damit es der Künstlichen Intelligenz gut geht. Wir geben unsere Daten einfach so her, damit sie in Trainingsdaten gesammelt werden können, und Big Tech daraus ein lukratives Geschäft machen kann. Wir sind damit einverstanden, dass Künstliche Intelligenz halluziniert, Fakes produziert und über Agenten Unternehmen angreift, ohne dafür programmiert zu sein. Die fehlenden Rahmenbedingungen sind durchaus im Sinne von Big Tech – egal welche gesellschaftlichen Konsequenzen das hat.
Berücksichtigt man allerdings, dass Künstliche Intelligenz untrennbar in die Gesellschaft eingebettet ist, so wirkt Künstliche Intelligenz auf die Gesellschaft je mehr die verschiedenen Möglichkeiten genutzt werden. Es gibt somit auch ein gewisses gesellschaftliches Zersetzungspotenzial, was aktuell Demokratien mit ihren freiheitlichen Ansätzen schwer zu schaffen macht.
Darüber hinaus wirkt natürlich auch die Gesellschaft mit ihrem Rechtssystem, dem sozialen System, seinen Werten, ethischen und moralischen Perspektiven usw. auf Künstliche Intelligenz. Das wird allerdings von Big Tech und den damit kooperierenden Strömungen massiv kritisiert – klar.
Solche Erkenntnisse kommen spät, doch möglicherweise noch nicht zu spät. Beispielsweise sieht man es in der Entwicklung zu mehr europäischer (Digitaler) Souveränität, zu immer mehr europäischen Open Source AI Modellen oder lokal ausgeführten KI-Modellen oder auch zu Modellen, die die jeweilige Sprache besser abbilden (Siehe meinen Blogbeitrag zu agglutinierenden Sprachen).
Es sind viele kleine Aktivitäten, in allen gesellschaftlichen Bereichen, die Europa Schritt für Schritt unabhängiger machen. Das wird nach Jahrzehnten der Abhängigkeit nicht in ein paar Jahren klappen, doch ist die Tendenz eindeutig.
Das Primat der Gesellschaft über technologische Entwicklungen sollte wiederhergestellt werden – zum Wohle aller und nicht nur zum Wohle einiger.
Dazu habe ich einen passenden Text in einem Paper gefunden:
„Third, as already alluded to above, there is an important societal dimension that needs to be considered within any AI history, as it does not stand separate from its technological dimension. Like all technologies, AI is inherently embedded in society, thus affecting and being affected by the broader environment in which it is designed, developed, and deployed – for better and for worse. The societal impact of Artificial Intelligence is of course more noticeable the more it is being implemented and used in a diversity of domains, which also explains the relatively recent surge of (academic and other) interest in AI ethics, in parallel with the technology’s increased uptake. Yet AI’s uptake is also enabled and furthered by the societal condition. These enabling factors pertain, inter alia, to society’s belief in innovation as an almost absolute good, its technology-solutionist orientation, and its conception of “progress” as almost coinciding with technological advancement rather than also considering if and how these advancements translate into higher individual and societal welfare – for all. Yet if we shape technology and technology also shapes us, it is essential to ask how it can be ensured that this mutual shaping process takes place in a way that protects rather than undermines our legal, moral, and political standards“ (Smuha 2025).
Immer häufiger gibt es Meldungen darüber, dass KI-Agenten Aktionen durchführen, die anderen Organisationen schaden könnten. Es scheint, dass die für KI-Agenten gesetzten Grenzen von den KI-Agenten selbst umgangen werden – immerhin ist es ja das Ziel von solchen autonomen Systemen, selbstgesteuert ein Ziel zu erreichen.
In solchen Fällen stellt sich zwangsläufig die Frage nach der Verantwortlichkeit. Den Begriff kann man aus drei Perspektiven betrachten, die miteinander in Verbindung stehen: Kausale Verantwortung, Moralische Verantwortung und Rollenverantwortung.
„The term “responsibility” can be interpreted in several ways. When we say “I am responsible,” we can mean more than one thing by it. In general, a distinction can be made between three meanings: causal responsibility, moral responsibility, and role responsibility. (…) These three types of responsibilities are related“ Lauwaert, L., Oimann, A.-K. (2025): Moral Responsibility and Autonomous Technologies. Does AI Face a Responsibility Gap?, in Smuha (Ed.) 2025).
Die genannten Autoren haben in einem Artikel dazu sehr viele Fragen aufgeworfen, von denen ich hier nur zwei wiedergeben möchte:
(1) Kann ein autonomes System für die gemachten Fehler moralisch verantwortlich sein?Ihre Antwort: „(…) the problem is that there is no one morally responsible for the errors caused by an autonomous system“.
(2) Kann in einem großen autonomen System jemand moralisch verantwortlich gemacht werden, wenn bei der Entwicklung und Ausführung so viele beteiligt sind? „The second problem that deviates from the responsibility gap is the problem of many hands“.
Es ist interessant, sich über die Verantwortung und Verantwortlichkeiten bei der Nutzung von autonomen KI-Systemen Gedanken zu machen. Dabei sollten nicht nur die Kausale Verantwortung und die Rollenverantwortung, sondern auch die Moralische Verantwortung berücksichtigt werden. Diese Dimension ist allerdings schwierig zu fassen. Daher kommen die Autoren bei der Moralischen Verantwortung zu folgendem Ergebnis:
„First, the use of autonomous AI does not necessarily involve a responsibility gap. Second, even if this were the case, we argued why that is not necessarily morally problematic“ (ebd.)..
Diese Betrachtung rüttelt an der von Big Tech immer wieder verbreiteten Meinung, dass Künstliche Intelligenz in der Geschichte der Menschheit etwas Einmaliges, Unvergleichbares ist – für das es noch keine gesellschaftlichen Regeln gibt.
Dadurch, dass Big Tech ihre Modelle nicht transparent macht (Closed Source AI) umgibt sie eineAura des Mystischen, des Magischen. Wenn sie die Modelle transparent machen würden, wie es Open Source AI Modelle vormachen, so würde man erkennen, dass da nichts dergleichen ist.
Die in den Jahrzehnten immer wieder genannte geheime Formel für die Herstellung von Coca Cola war auch so eine Vorgehensweise des Storytellings. Es ist und bleibt „nur“ geschicktes Marketing.
Auch lehrt uns die Geschichte, dass es den Menschen in ihren gesellschaftlichen Strukturen bisher immer gelungen ist, Regelungen zu finden, um neue Technologien zu nutzen, und gleichzeitig gesellschaftliche Auswirkungen zu dämpfen.
„The question is, hence, how to avoid the trap of treating AI as entirely novel, while at the same time being sufficiently mindful of the very concrete ways in which it can (adversely) affect society, and ensuring tailored governance mechanisms to counter potential harms“ (Smuha 2025).
Aktuell gibt es ein Ungleichgewicht in den Diskussionen, denn Big Tech dominiert die Debatte und möchte damit auch die gesellschaftlichen Strukturen wie gewünscht anpassen. In den USA sehen wir, wie das alles funktionieren soll.
In Europa haben wir die Chance, beide Extreme zu einem Kontinuum der Möglichkeiten für die sinnvolle gesellschaftliche Nutzung von Künstlicher Intelligenz zusammenzuführen. Es wundert nicht, dass Big Tech davon nicht begeistert ist. Doch immer mehr Menschen und Organisationen in Europa erkennen, dass eine Abhängigkeit von den Big Tech Denkmustern nicht unbedingt gut ist. Siehe dazu auch
Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.
Es ist einfach nur interessant zu beobachten, wie sich die Muster ähneln. In den 90er Jahren waren es die Lean-Experten, dann die Experten für Agilität in den Organisationen und jetzt ist es eben das Attribut „KI-Experte“, das den Markt überschwemmt. Da sich jeder so nennen darf, wird es eben auch gemacht.
Ich stelle mir dabei oft die Frage, in welchen Teilgebieten des gesamten Feldes der Künstlichen Intelligenz will denn diese Person Experte sein, und was macht diese Person zu einem Experten?
Die eigene Zuschreibung reicht dafür nicht aus, denn richtige Experten werden von anderen dazu gemacht – es ist also eine Zuschreibung von anderen.
Experten werden von anderen gesucht und möglicherweise auch gefunden. Manche davon wissen gar nicht, dass sie in diesem Sinne Experten sind, geschweige denn nennen sie sich so.
Ein Beispiel für „richtige Experten“ kennen wir aus dem Bereich Innovationen – und hier speziell User Innovation. Diese Personen können durch ein spezielles Suchverfahren erkannt werden:
„Pyramiding search is a variant of snowballing – but with an important difference. Pyramiding requires that people having a strong interest in a given attribute or quality, for example a particular type of expertise, will tend to know of people who know more about and/or have more of that attribute than they themselves do (von Hippel et al 1999)“. zitiert von von Hippel/Franke/Prügl 2009).
Das Attribut „KI-Experte“ ist letztendlich das, was es ist: ein Marketingansatz. – nicht mehr und nicht weniger.
Lassen Sie andere darüber entscheiden, ob Sie ein KI-Experte sind.
Weitere Blogbeiträge zum Thema Expertise finden Sie hier.
Immer mehr User (Nutzer) entwickeln ihre eigenen Produkte, da die Unternehmen mit ihren begrenzten Ressourcen (fixed innovation space) und Renditeüberlegungen oftmals Ideen von Usern nicht umsetzen. In meinem Paper zur MCP 2026 habe ich das ausführlich hergeleitet und beschrieben:
Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework. Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 76-85 · 17. Sep. 2026
Die Konferenzreihe legt seit 2004 alle 2 Jahre den Fokus auf (Mass) Customization and Personalization. – siehe MCP-CE.org. Dabei ging es in der Vergangenheit meistens darum herauszufinden, wie Unternehmen mit neuen Technologien – und jetzt auch mit Künstlicher Intelligenz – (massenhaft) individuelle Produkte und Dienstleistungen anbieten können – zum Preis von Standardprodukten.
In meinem Paper habe ich den Ansatz Customization and Personalization aus der Perspektive eines Users dargestellt: Open User Innovation. An mehreren Beispielen konnte ich aufzeigen, wie es in den letzten Jahren einen Paradigmenwechsel gegeben hat. User sind heute immer mehr in der Lage, ihre Ideen selbst umzusetzen. Dabei helfen natürlich die niederschwelligen Technologien der Maker Bewegung und Künstliche Intelligenz, um die vielen Hürden im Prozess der persönlichen Fabrikation zu überwinden.
Über meine in dem Paper genannten Beispiele hinaus, wird nun auch deutlich, dass es in Zukunft auch möglich sein wird, seine eigene Software von Künstlicher Intelligenz „bauen“ zu lassen. Lange genug haben wir uns den etablierten Softwareanbieter angepasst, ja geradezu unterworfen.
Wenn über 97% der Codebasis von Software Open Source ist, sollte es möglich sein, aus diesen Bausteinen seine eigene Software zusammenzustellen. Künstliche Intelligenz kann hier bei den Schnittstellen und möglichen rechtlichen Fragen helfen.
„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).
Auch die aktuellen Entwicklungen beim Vibe Coding gehen in diese Richtung. Dabei wird mit Hilfe eines Prompts der Quellcode von Künstlicher Intelligenz generiert. Warum eigentlich nicht?
Ich bin gespannt, was es in diesem Bereich noch für überraschende neue Chancen für die „Herstellung“ eigener Produkte und Dienstleistungen geben wird. Ganz im Sinne einer Open User Innovation, die sich von den etablierten Unternehmensangeboten löst, und eigene Lösungen entwickelt und nutzt.
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089
In der folgenden Tabelle sind die Modelle, das Land und unter Bemerkungen, die Zugangsform (Open Source, Open Weight oder nur per API) angegeben. Die KI-Modelle sind direkt verlinkt.
Europäische KI-Modelle, veröffentlicht im Zeitraum vom 22.09.-06.10.2026
Weiterhin haben wir diese Modelle in unsere Open Street Map mit aufgenommen, in der viele länderspezifische KI-Modelle zu finden sind. Die Map zeigt die dynamische Entwicklung in Europa, und den Trend zu mehr Digitaler Souveränität bei KI-Modellen.
Für die meisten Anwendungen ist es nicht erforderlich, das beste und größe Modell zu haben. Es geht vielmehr darum, ein KI-Modell zu nutzen, das vertrauenswürdig ist, in Europa gehostet wird und transparent zeigt, wie mit Daten umgegangen wird.
Ein gutes KI-System im Unternehmen schlägt dabei den Ansatz, alles im Unternehmen einem gigantischen KI-Modell wie Claude von Anthropic, Gemini von Google, ChatGPT von OpenAI etc. unterzuordnen. Siehe dazu auch
Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.
Diese Website benutzt Cookies. Wenn du die Website weiter nutzt, gehen wir von deinem Einverständnis aus.