Digitale Souveränität: Nextcloud und Olmo 3 – a perfect match

Nextcloud nutzen wir schon lange als Alternative zu den bekannten Microsoft-Anwendungen. In Nextcloud ist es auch möglich, KI-Modelle zu integrieren. Im Vergleich zu Microsoft kann man auswählen, welches KI-Modell man nutzen möchte.- ein großer Vorteil.

Im Sinne einer Digitalen Souveränität ist es dabei natürlich sinnvoll, auf Open Weight Modelle wie Mistral AI zu setzen, oder sogar ein Open Source Modell wie Ollmo 3 zu nutzen. Es wundert daher nicht, dass Nextcloud Ollmo 3 mit einem grünen Rating versehen hat (Siehe dazu auch die von mir erstellte OpenStreetMap zu geeigneten Modellen aus Europa).

“We deeply believe in the four freedoms of free software and are convinced that being able to inspect and reproduce how the model was built is vital,” says Marcel Klehr, a software engineer at Nextcloud (Ai2 (2026) How Olmo 3 earned the highest ethical rating from Nextcloud, via LinkedIn, 02.11.2026).

Wenn Sie Nextcloud über Ihren eigenen Server betreiben, können Sie die llm-App installieren. Dort sind verschiedene LLMs zu finden, u.a. auch Ollmo 3. Nextcloud selbst nutzt Olmo 3 für verschiedene Funktionen des Nextcloud Assistenten. Die ethische Bewertung „grün“ bedeutet, dass alles quelloffen ist, auch die Trainingsdaten.

Wenn Sie Nextcloud nicht auf Ihrem eigenen Server, sondern beispielsweise IONOS Nextcloud Workspace nutzen, sind Sie hier eher etwas eingeschränkt. Dennoch ist es möglich, über die Ollama-App und die Langlow-App das KI-Modell Olmo 3 zu integrieren.

Gerade für Einzelpersonen, Kleine und Mittlere Unternehmen (KMU) bieten sich hier vielfältige Möglichkeiten auf Digitale Souveränität zu setzen und ein eigenes Open Source basiertes KI-basiertes System aufzubauen. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz ist kein neutraler Interaktionspartner

Speech bubbles, blank boards and signs held by voters with freedom of democracy and opinion. The review, say and voice of people in public news adds good comments to a diverse group.

In meinem Blogbeitrag vom 24.10.2026 ging es um Cyberself und Personalisierung. Dabei wurde herausgestellt, dass Menschen und KI-Systeme durchaus mehrere „Persönlichkeiten“ haben können, wobei der Begriff bei Menschen und KI-Modellen unterschiedlich ist.

Wenn Menschen also KI-Modelle als Interaktionspartner nutzen, passen sich die KI-Systeme dem Nutzer an, wodurch eine Art Zuschreibung einer „Persönlichkeit“ durch den Nutzer entsteht. Manche Nutzer schreiben das KI-Modell auch in damit verbundenen Texten (Prompts) an.

Dadurch entsteht eine Interaktion der Bestätigung, die kritische oder konfliktträchtige, emotionale – eben menschliche – Interaktionen verkümmern lässt. Treffen die Personen, die ihre KI-Modelle und -Agenten als Partner sehen, auf die reale menschliche Welt, kann es zu antisozialen Reaktionen kommen.

„Zusammengefasst ist KI kein neutraler Interaktionspartner, sondern ein sozial wirksamer Akteur, dessen Effekte maßgeblich durch seine Funktionslogik, sein Trainingsziel und sein Interaktionsdesign bestimmt werden. Anwendungen, die primär auf Zustimmung und Konfliktvermeidung ausgelegt sind, riskieren langfristig eine Schwächung der Selbstreflexion, Perspektivenvielfalt und sozialen Konfliktfähigkeit sowie eine Verschiebung sozialer Bindungen weg von menschlichen Beziehungen. Aufklärung über Konsequenzen und die Stärkung individueller Kompetenzen sind zentral“ (Glöckner et al., 2026).

Es kommt daher bei der Nutzung von Künstlicher Intelligenz auch darauf an, Modelle zu nutzen, die transparent und frei verfügbar sind – eben den Anforderungen von Open Source AI (Definition) entsprechen. Siehe dazu auch Mit proprietärer Künstlicher Intelligenz (KI) kauft man sich auch die Denkwelt der Eigentümer ein.

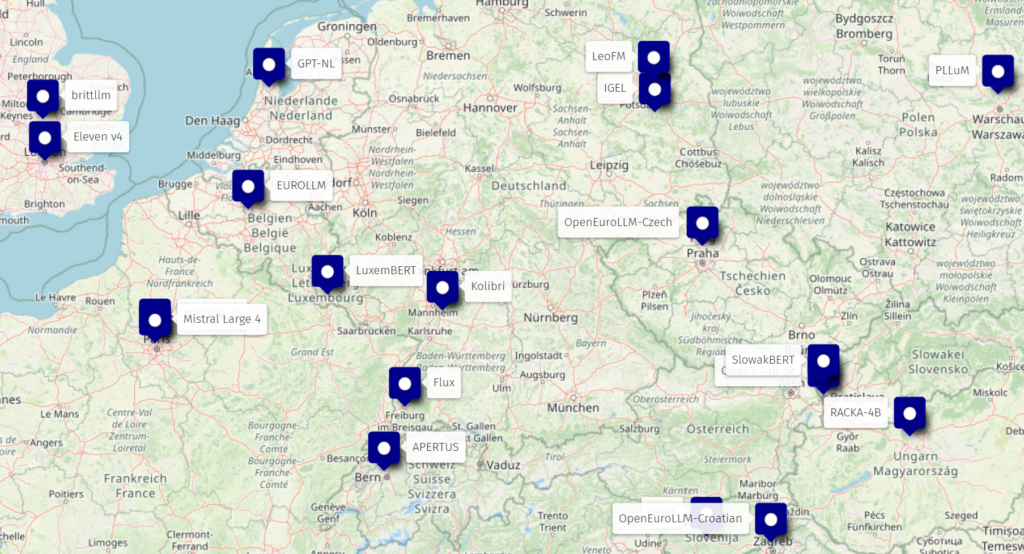
Es bieten sich daher verschiedene europäischen KI-Modelle an (Open Weight und Open Source), die ich auf einer Open Street Map zusammengetragen habe:

Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

EU Score: KI-Modelle und Open Source Anwendungen aus europäischer Sicht bewerten

https://eu-score.tech/

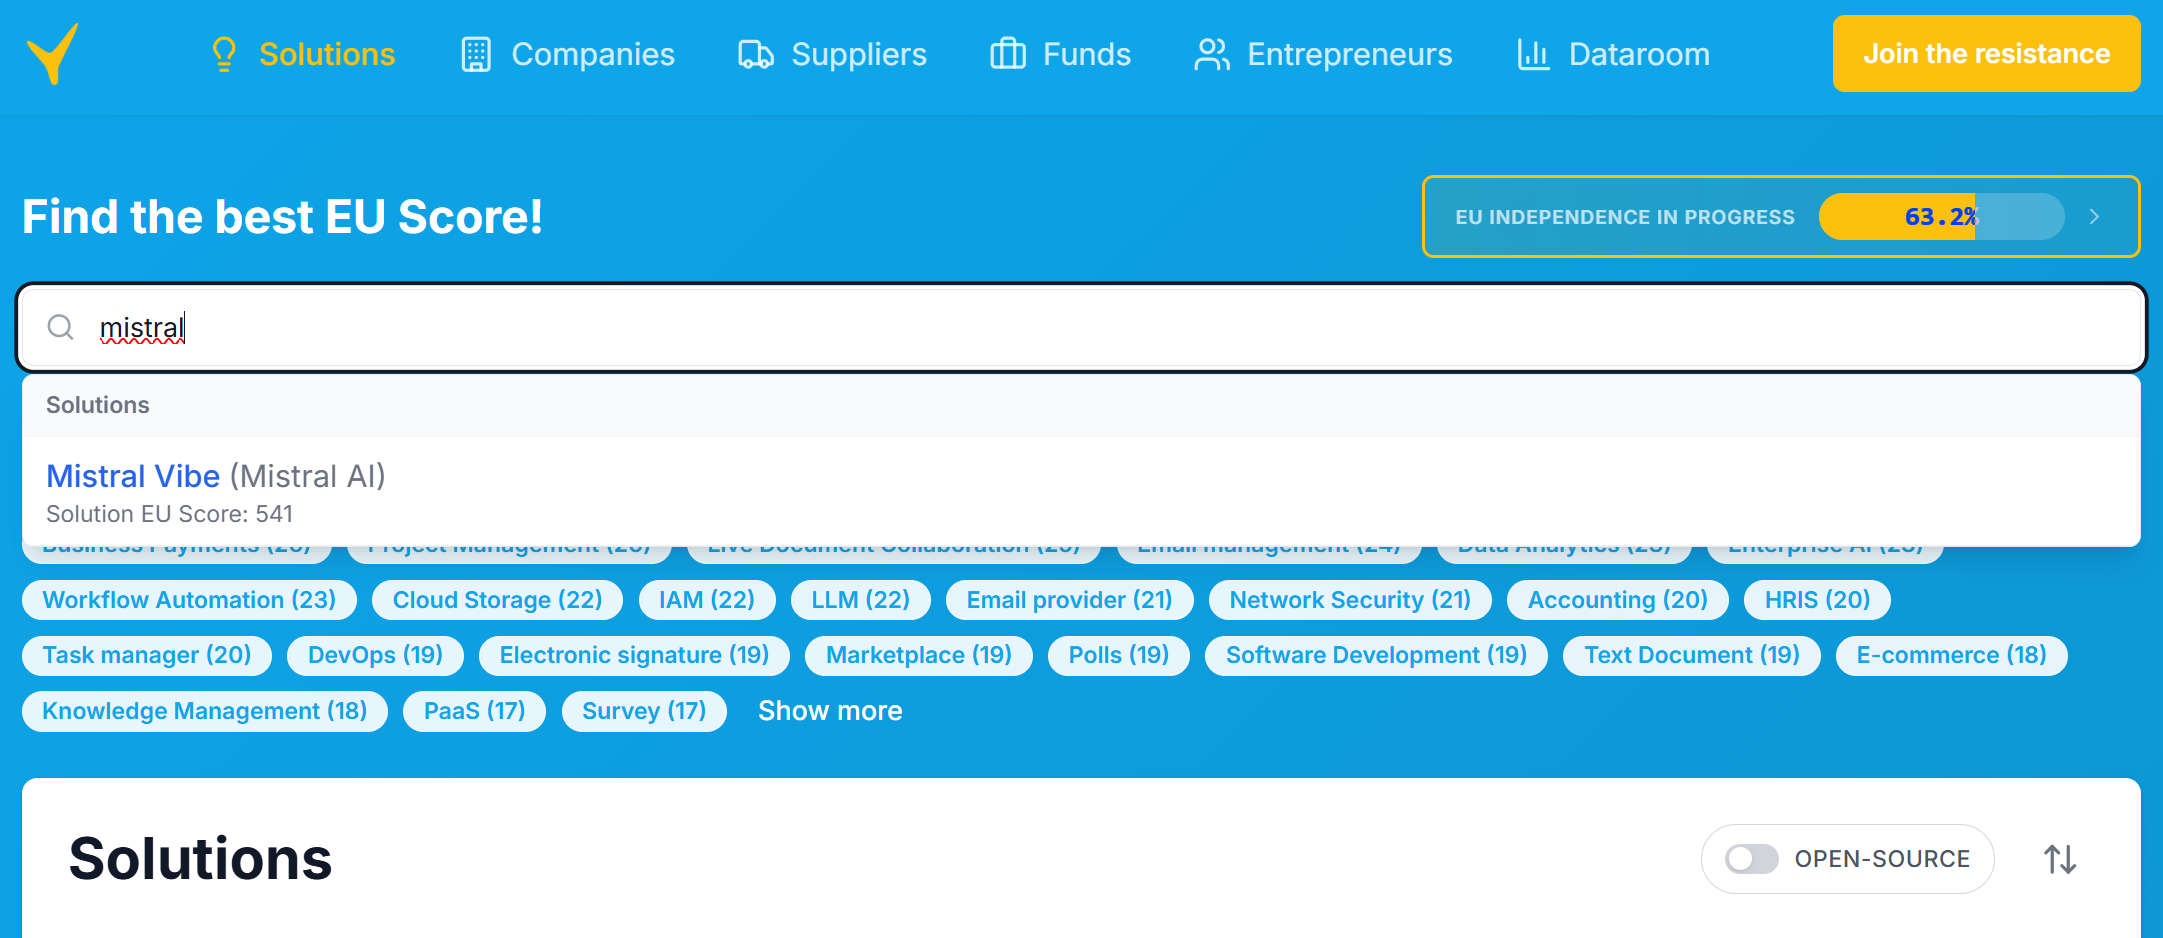
Es ist nicht ganz einfach, sich ein Bild von den ganzen KI-Möglichkeiten zu verschaffen. Es ist erforderlich, eine bestimmte Perspektive einzunehmen, um Bewertungen vorzunehmen. Die Plattform EU Score hat in 2025 damit angefangen, immer mehr Anwendungen aus dem Tech-Umfeld aus der Perspektive der Europäischen Union zu bewerten.

Die Dimensionen sind Population Sovereignty Equity Sovereignty, Supplier Sovereignty, Value Sovereignty und Webserver Sovereignty. Aus den einzelnen Zahlen wird dann ein Gesamtwert für die Souveränität der Europäischen Union ermittelt. In der Abbildung ist oben rechts ein gelb hinterlegter Wert von über 63,2% zu zu sehen.

Wenn ich in das Suchfeld „mistral“ eingebe (Abbildung), erscheint für Mistral Vibe (Mistral AI) der EU Score 541. Wenn ich in das Suchfeld „claude“ von Antropic eingebe, erhalte ich den EU Score 1. Das ist jetzt kein Schreibfehler! Die Unterschiede zwischen den beiden KI-Modellen sind aus europäischer Sicht frappierend. Ähnlich ist es auch bei dem Vergleich von Microsoft Office und Nextcloud usw.

Die Plattform ist eine interessanter Einstieg, um sich die großen Unterschiede zwischen den angebotenen Markt-Alternativen klar zu machen. In der Abbildung ist rechts unten weiterhin zu erkennen, dass man auch nur Open Source Anwendungen betrachten und analysieren kann.

Eine Paper zur Methode habe ich bisher allerdings nicht gefunden. Für Außenstehende wäre eine fundierte wissenschaftliche Begründung und Ableitung der verwendeten Methode klarer und transparenter, was wiederum mehr Vertrauen schaffen würde. It all starts with trust!

Dennoch halte ich die Plattform für ein geeignetes Instrument, für sich selbst, für Organisationen eine Diskussionsgrundlage für die eigene Digitale Souveränität zu schaffen.

Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen

Eigene Open Street Map: https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154

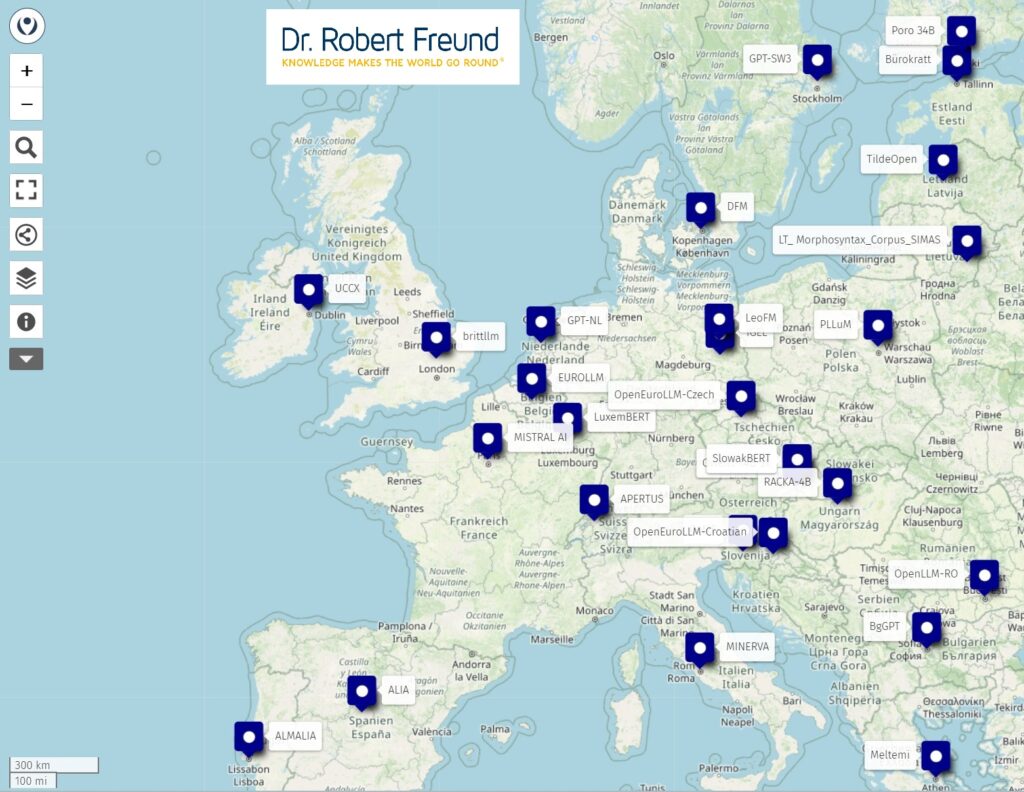
In den letzten Monaten habe ich über viele Open Source KI-Modelle in Europa geschrieben, die in der (oder den) spezifischen Landessprachen trainiert wurden. Die Links zu den jeweiligen Modellen habe ich nun zusammen mit dem Hinweis auf meinen dazugehörenden Blogbeitrag in Open Street Map (bewusst nicht in Google Maps) in einer eigenen Karte eingetragen (Abbildung).

Den Marker für ein Modell ist der Landeshauptstadt zugeordnet. Modelle, die alle europäischen Sprachen berücksichtigen, sind mit einem Marker auf Brüssel versehen.

Klicken Sie auf das Bild und Sie kommen direkt zu meiner angelegten Open Street Map.

Die erste Übersicht zeigt deutlich, wie vielfältig die Landschaft für Open Source KI-Modelle in Europa geworden ist. Ich bin sicher, die Modelle werden in Zukunft immer mehr von Privatpersonen, Kleinen und Mittleren Unternehmen (KMU), oder Öffentlichen Verwaltungen genutzt, da Transparenz (Offene Modelle), kulturelle Bezug (Landestypische Sprache) und die geringen Kosten (frei verfügbar) starke Argumente sind.

Wenn bei der Auswahl der KI-Modelle noch hinzukommt, dass Digitale Souveränität und Resilienz immer wichtiger werden, geht kein Weg an europäischen Open source KI-Modellen vorbei.

Auf der internationalen Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

KI-Sprachmodelle können nicht zuverlässig zwischen Überzeugungen einerseits und Wissen sowie Fakten andererseits unterscheiden

Image by SAMUEL GABRIEL from Pixabay

Es ist immer wieder erstaunlich, was wissenschaftliche Studien so ans Tageslicht bringen. Diesmal geht es darum, ob KI-Modelle gut zwischen dem unterscheiden können, was bekannt ist, und dem, was lediglich geglaubt wird. Dazu habe ich folgendes gefunden:

Die untersuchten Sprachmodelle können nicht zuverlässig zwischen Überzeugungen einerseits und Wissen sowie Fakten andererseits unterscheiden.
Quelle: Suzgun, M., Gur, T., Bianchi, F. et al. Language models cannot reliably distinguish belief from knowledge and fact. Nat Mach Intell 7, 1780–1790 (2025). https://doi.org/10.1038/s42256-025-01113-8

Das kann wiederum in sensiblen Bereichen schwerwiegende Auswirkungen haben. Gerade wenn es um gesundheitliche oder auch rechtliche Fragen geht:

„The distinction between knowledge and belief is important in practice. For example, a model used to support a medical diagnosis based on a patient’s mistaken belief, as opposed to an established fact, could reinforce an inaccurate diagnosis and treatment plan. In a legal setting, a model summarizing testimony that cannot tell the difference between what a witness believes and what is known could misrepresent evidence“ (Stanford University, AI Report 2026).

Es ist gut, wenn wir weiterhin positiv kritisch gegenüber Künstlicher Intelligenz bleiben und darauf bestehen, dass KI-Systeme transparent und nachvollziehbar sind. Die aktuellen proprietären KI-Modelle bieten das nicht, und sollten daher – wenn überhaupt – nur mit Vorsicht gerade in kritischen gesellschaftlichen und Unternehmens-Bereichen eingesetzt werden.

In der Zwischenzeit gibt es gute Alternativen. Die erfolgreiche Geschichte von Open Source KI zeigt, dass immer mehr Personen und Organisationen erkennen, dass dieser Weg ein Möglichkeit darstellt, leistungsfähige und dabei gleichzeitig auch transparente KI-Systeme einzusetzen.

Es ist möglich, leistungsfähige KI-Sprachmodelle zu trainieren, die ausschließlich auf gemeinfreien und offenen Texten basieren

In den letzten Jahren gibt es sehr viele Content-Entwickler aus allen möglichen Bereichen, die sich gegen die Übernahme ihrer Inhalte als Trainingsdaten in den bekannten, kommerziellen KI-Modellen wehren.

Dabei kommt es einem so vor, als ob die großen KI-Unternehmen das wohl schon irgendwie „eingepreist“ haben und langwierige Gerichtsverfahren eingehen. Darüber hinaus muss auch die folgende Frage gestellt werden

Ist es möglich ist, leistungsfähige KI-Sprachmodelle zu trainieren, die ausschließlich auf gemeinfrei und offenen Texten basieren?

Die Antwort: Ja, es ist möglich.

In ihrem Paper hat eine Forscher-Gruppe nicht nur ausführlich dargelegt, welche Quellen sie dafür ausgewählt haben, sondern auch gleichzeitig ein entsprechendes Modell entwickelt und auf Hugging Face veröffentlicht:

„We release Common Pile v0.1, an 8TB corpus that—to our knowledge—constitutes the largest dataset built exclusively from openly licensed text. Alongside our dataset, we release Comma v0.1-1T and -2T, two performant 7-billion-parameter LLMs trained on text from the Common Pile, as well as the filtered and rebalanced data mixture we used for training. Our results demonstrate that not only is the Common Pile the strongest dataset for pretraining under an open-license constraint, but also that it produces models comparable to those trained on an equivalent amount of unlicensed data. This positive result holds promise for future of open-license pretraining, especially if the research community invests in collecting larger quantities of openly licensed text data in the future. Ultimately, we believe that the Common Pile v0.1 represents the first step on the path towards a more ethical language model ecosystem, where performance need not come at the cost of creator rights and legal transparency.“ (Kandpahl et al. (2025): The Common Pile v0.1: An 8TB Dataset of Public Domain and Openly Licensed Text).

Natürlich dominieren die proprietären KI-Modelle den Markt, und es fällt den Marktteilnehmer wegen dem in der Zwischenzeit eingetretenen Lock-in schwer, sich an andere KI-Modelle zu gewöhnen (Pfadabhängigkeit). Dennoch überlegen viele Einzelpersonen, Unternehmen, Not for Profit Organisationen oder auch Öffentliche Verwaltungen, ob sie sich nicht von der eingetretenen Abhängigkeit lösen sollten, ja müssen.

Siehe dazu auch Künstliche Intelligenz: Es ist so bequem, unmündig zu sein.

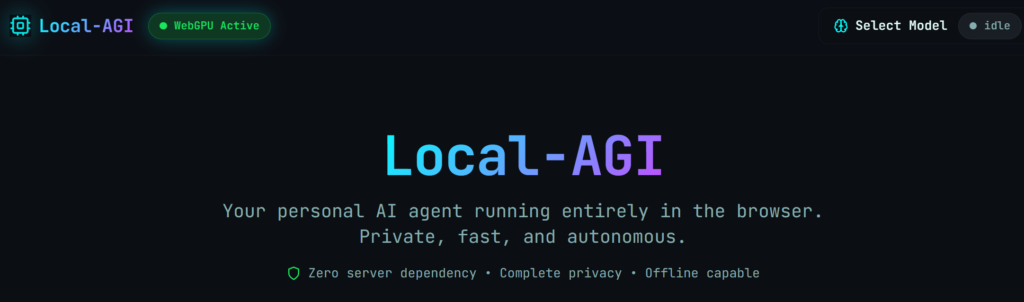
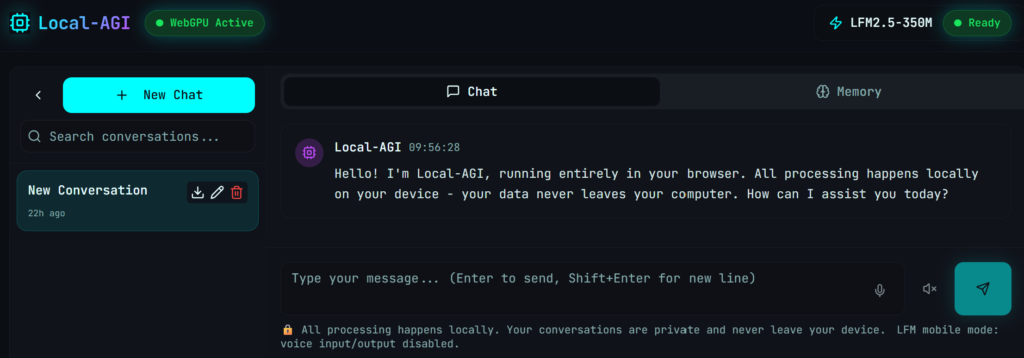
Local-AGI: Your personal AI agent running entirely in the browser. Private, fast, and autonomous.

https://www.local-agi.com/

Über die Möglichkeiten, Open Source KI-Modelle auf dem eigenen Server zu betreiben habe ich in verschiedenen Blogbeiträgen schon geschrieben. Siehe dazu beispielsweise Digitale Souveränität: Wie kann ein KI-Modell aus LocalAI in den Nextcloud Assistenten eingebunden werden?

So ein System mit Nextcloud und LocalAI ermöglicht schon, autonom mit den eigenen Daten und Open Source KI-Modellen zu arbeiten. Dabei wird allerdings auch deutlich, dass es Abläufe gibt, die automatisiert werden können. Das kann durch Workflows oder KI-Agenten erfolgen. KI-Agenten sind im Gegensatz zu Workflows relativ eigenständig bei den Abläufen zur Problemlösung. Um das zu gewährleisten, und aufbauend auf Nextcloud und LocalAI, kann noch Local-AGI integriert werden.

Local-AGI ist eine auf LocalAI aufbauende Plattform, die speziell für autonome KI-Agenten entwickelt wurde. Es ermöglicht die Erstellung und Verwaltung von KI-Agenten, die Werkzeuge nutzen, Aufgaben autonom ausführen und sogar im Internet suchen können – alles lokal und ohne Cloud-Abhängigkeit. LocalAGI integriert LocalAI als Inferenz-Engine und bietet zusätzliche Funktionen wie eine Wissensdatenbank, Echtzeit-Überwachung und eine Benutzeroberfläche für die Agentenverwaltung (Quelle: GitHub).

LocalAI ist die Basis für lokale KI, während Local-AGI die Agenten-Funktionalität auf Basis von LocalAI bereitstellt. Beide Projekte sind modular und können gemeinsam genutzt werden, um komplexe, autonome KI-Systeme lokal zu betreiben.

In der Abbildung oben ist die Startseite von Local-AGI zu sehen, auf der hinterlegte KI-Modelle im Browser direkt getestet werden können. Unter „Select Models“ sind einige wenige Modelle zu finden, die direkt heruntergeladen werden können. Ich habe das kleinste Modell LFM.5-350M ausgewählt, wobei das Modell im Browser gespeichert wurde, und folgende Eingabeseite erscheint:

Hervorheben möchte ich noch einmal den Text, der gleich am Anfang des Chats erscheint: „Hello! I’m Local-AGI, running entirely in your browser. All processing happens locally on your device – your data never leaves your computer. How can I assist you today?“ Dieser Hinweis ist im Sinne einer eigenen Digitalen Souveränität wichtig.

Durch die Integration von Local-AGI mit LocalAI stehen weitere Modelle zur Verfügung. Im Unternehmen kommt es nicht darauf an, einzelne Anwendungen zu vergleichen, sondern darum, Digitale Souveränität und Resilienz in einem System mit Open Source Software und Open Source AI zu erreichen.

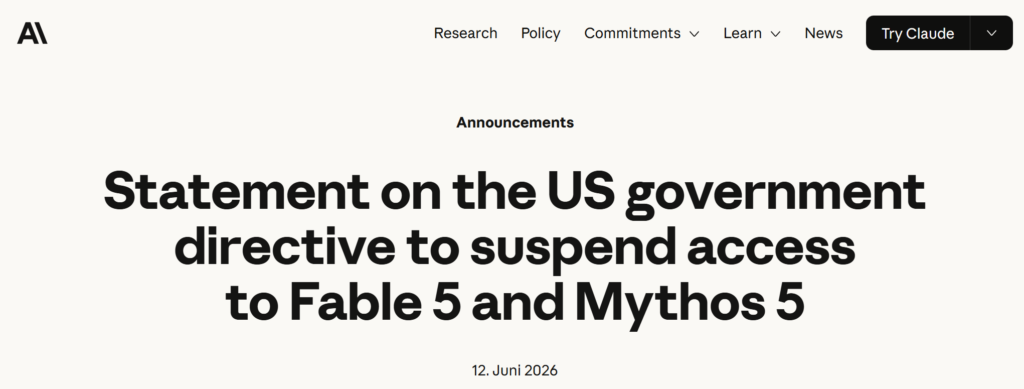
Anthropic: Anweisung der US-Regierung, den Zugang zu Fable 5 und Mythos 5 auszusetzen

https://www.anthropic.com/news/fable-mythos-access

Die US-Regierung hat Anthropic angewiesen, den Zugang zu Fable 5 und Mythos 5 auszusetzen. Das ist schon ein starker Eingriff in die Geschäfte von Antropic – und eine Art von Regulierung. Kein Wunder also, dass sich Anthropic mit einer ausführlichen Stellungnahme dazu geäußert hat:

Statement on the US government directive to suspend access to Fable 5 and Mythos 5 (Antropic, 12.06.2026).

Dieser Vorgang ist deshalb so erstaunlich, da es ja gerade die US-Regierung war, die der Europäischen Union in der Vergangenheit vorgeworfen hat, den Markt für Künstliche Intelligenz zu stark zu regulieren. Siehe dazu auch Bris, A. (2025): SuperEurope: The Unexpected Hero of the 21st Century.

Wie Sie als Leser unseres Blogs wissen, plädieren wir bei Künstlicher Intelligenz dazu, Open Source KI zu nutzen.

Auf der MCP 2026 stelle ich dazu auch ein Paper vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

In meinem zweite Paper geht es um:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Künstliche Intelligenz: Wie kann man Mistral-Modelle auf „Heim-Hardware“ betreiben?

https://mistral.ai/news/mistral-3

Mistral AI ist ein französisches Unternehmen, das eine Modellfamilie veröffentlicht, die europäischen Anforderungen an KI-Modelle entspricht, und Open Source verfügbar ist. (Open Models) Die Leistungsfähigkeit von den Mistral- Modellen nähert sich den Cloud AI Modellen (Closed Models) wie ChatGPT, Gemini etc. an (Open Source AI holt auf). Mit Le Chat gibt es auch eine europäische Alternative zu ChatGPT.

Mistral-Modelle können bei Mistral selbst, also auf in deren Cloud, getestet werden. Darüber hinaus ist es auch möglich, die Modelle über Hugging Face herunterzuladen und auf dem eigenen Server zu nutzen, z.B. mit LocalAI.

Der Trend zu immer kleineren, speziellen und leistungsstarken Modellen (SLM: Small Language Models) macht es immer attraktiver, solche Modelle auf dem eigenen Laptop, also auf „Heim-Hardware„, zu nutzen. Das ist u.a. auch mit Mistral möglich. Wie genau, wird in dem folgenden Artikel gut beschrieben:

Simon, A, (2026) How to run Mistral locally. Available from: https://getdeploying.com/guides/local-mistral

Es ist auch möglich, Mistral über die lokal installierte App von Ollama zu nutzen. Siehe dazu Open Source Modelle mit der Ollama-App auf dem eigenen Desktop.