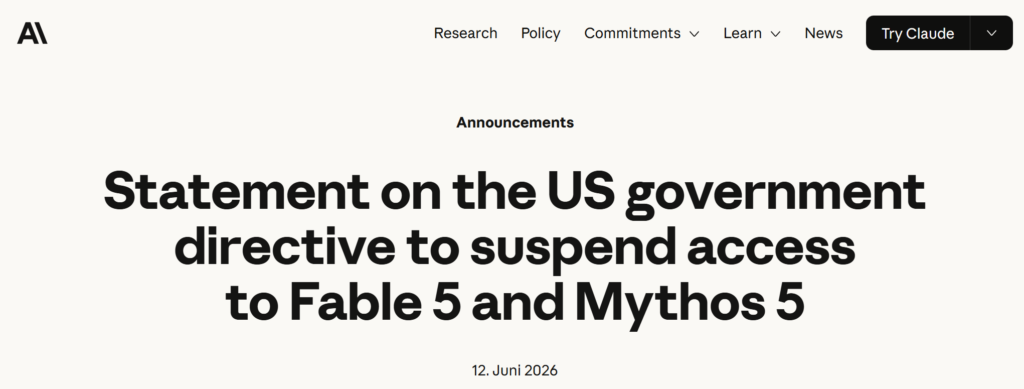
Die US-Regierung hat Anthropic angewiesen, den Zugang zu Fable 5 und Mythos 5 auszusetzen. Das ist schon ein starker Eingriff in die Geschäfte von Antropic – und eine Art von Regulierung. Kein Wunder also, dass sich Anthropic mit einer ausführlichen Stellungnahme dazu geäußert hat:
Dieser Vorgang ist deshalb so erstaunlich, da es ja gerade die US-Regierung war, die der Europäischen Union in der Vergangenheit vorgeworfen hat, den Markt für Künstliche Intelligenz zu stark zu regulieren. Siehe dazu auch Bris, A. (2025): SuperEurope: The Unexpected Hero of the 21st Century.
Wie Sie als Leser unseres Blogs wissen, plädieren wir bei Künstlicher Intelligenz dazu, Open Source KI zu nutzen.
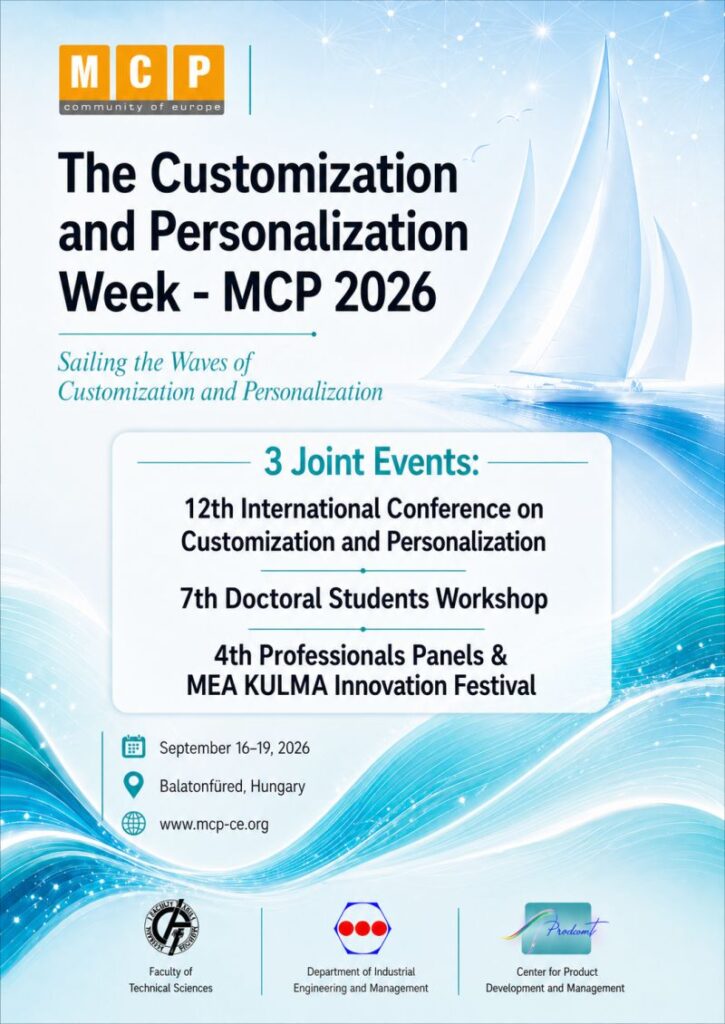
Auf der MCP 2026 stelle ich dazu auch ein Paper vor:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
In meinem zweite Paper geht es um:
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Vor mehreren Jahren, als wir angefangen haben über eine mögliche Digitale Souveränität für Personen, Unternehmen, in Deutschland und in Europa zu schreiben, haben wir einige Rückmeldungen erhalten die zeigten, dass man diesem (europäischen) Weg keine Chance einräumt, und es als unrealistische Vision einschätzte.
In der Zwischenzeit hat sich gezeigt, dass die vielen aufgebauten Abhängigkeiten der letzten Jahrzehnte in eine Sackgasse auf allen Ebenen geführt haben: Energetische Abhängigkeit, militärische Abhängigkeit, digitale Abhängigkeit usw.
Es ist durchaus erstaunlich, dass viele, die diese Abhängigkeiten selbst herbeigeführt haben, nun nach Souveränität rufen. Die einzigen allerdings, die behaupten können, dass sie auf Digitale Souveränität hingewiesen haben, sind Akteure aus dem Open Source Bereich, denn hier geht es schon immer um Transparenz, Offenheit und Rechtstaatlichkeit.
Diejenigen, die sich aus Bequemlichkeit in die digitale Abhängigkeit begeben haben, müssen jetzt zu hohen Kosten umsteuern, da die Nutzung von den bekannten APPs und KI-Modellen in den Köpfen (auch in den Unternehmen) zu einer Pfadabhängigkeit geführt hat, aus der manche möglicherweise gar nicht mehr herauskommen werden.
Die Überschrift des Blogbeitrags ist vom Newsletter Juni 2026 der Open Source Business Alliance – Bundesverband für digitale Souveränität e.V. entnommen. Die Aussage bezieht sich dabei auf die Erkenntnisse aus dem SCS Summit 2026, der in Berlin stattfand.
„Liebe Leserinnen und Leser, am 21. Mai 2026 kamen 200 Menschen im bUm Berlin zusammen – und der diesjährige SCS Summit hat bewiesen, dass digitale Souveränität in der Cloud keine Zukunftsvision mehr ist, sondern gelebter Alltag. Vom ersten Moment an war deutlich zu spüren: es wird weniger von Visionen als von klaren Umsetzungen und Mehrwerten gesprochen“ (OSBA SCSSummit 2026).
Die vielen Beispiele zeigen, was alles schon heute möglich ist, und was schon konkret umgesetzt wurde. Informieren Sie sich weiter über die Entwicklung auf dem Gebiet der Digitalen Souveränität und entscheiden Sie, was für Sie als Person und als Organisation umsetzbar ist.
Vergleichen Sie dabei nicht nur die einzelnen Tools, sondern auch, was Sie durch eine Neuausrichtung wieder erhalten: Sie gewinnen wieder die Kontrolle über ihre eigenen Daten – ein unschätzbarer Vorteil.
Fangen Sie an, ihre eigene Digitale Souveränität zurückzugewinnen.
Mistral AI ist ein französisches Unternehmen, das eine Modellfamilie veröffentlicht, die europäischen Anforderungen an KI-Modelle entspricht, und Open Source verfügbar ist. (Open Models) Die Leistungsfähigkeit von den Mistral- Modellen nähert sich den Cloud AI Modellen (Closed Models) wie ChatGPT, Gemini etc. an (Open Source AI holt auf). Mit Le Chat gibt es auch eine europäische Alternative zu ChatGPT.
Mistral-Modelle können bei Mistral selbst, also auf in deren Cloud, getestet werden. Darüber hinaus ist es auch möglich, die Modelle über Hugging Face herunterzuladen und auf dem eigenen Server zu nutzen, z.B. mit LocalAI.
Der Trend zu immer kleineren, speziellen und leistungsstarken Modellen (SLM: Small Language Models) macht es immer attraktiver, solche Modelle auf dem eigenen Laptop, also auf „Heim-Hardware„, zu nutzen. Das ist u.a. auch mit Mistral möglich. Wie genau, wird in dem folgenden Artikel gut beschrieben:
Jeder benutzt in seiner Kommunikation Emojis, die oft in den üblichen Apps enthalten sind. Um sich etwas zu unterscheiden, haben Studenten mit ihren zwei Professoren das Open Source Projekt OpenMoji ins Leben gerufen.
„OpenMoji is an open source project of 80+ students and 2 professors of the HfG Schwäbisch Gmünd and many external contributors“ (ebd.).
Die Symbole sind somit für jeden frei nutzbar, und können in verschiedenen Größen und Farben – auch Schwarz/Weiß – heruntergeladen werden.
Wieder ein schönes Beispiel für Open Source Projekte, die unseren Alltag bereichern. Mehr Beiträge zu Open Source finden Sie hier.
AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.
Es ist nur natürlich, dass jeder Einzelne, Organisationen und Öffentliche Verwaltungen ausprobieren, was mit Künstlicher Intelligenz (GenAI) möglich ist. Im wissenschaftlichen Umfeld wundere ich mich allerdings immer wieder darüber, wie unkritisch GenAI eingesetzt wird, wodurch die Kriterien wissenschaftlicher Arbeit konterkariert werden. Warum ist das so? Eine ausführlich Begründung habe ich im aktuellen OECD Report gefunden. Dabei geht es hier speziell um die Reproduzierbarkeit als Säule wissenschaftlichen Arbeitens geht.
Reproducibility is a pillar of scientific operations. To be accepted by the scientific community, results must (usually) be verifiable, and reproducible by others. One condition for reproducibility is full disclosure of the methods and data that led to the conclusion, meaning transparency and accessibility. From this perspective, GenAI models do not meet scientific criteria. First, the most popular models of GenAI are “black boxes”, as neither their weights (the parameters that define a neural network) nor their training data are publicised. Thus, disentangling the contribution of the data and the contribution of various components of the model is difficult in any scientific result coming from such a model. This comes from the very nature of neural networks: knowledge is distributed, hence difficult to localise. As GenAI models have a random component at their core, some results might not be robust. In addition, access to the training data can be limited due to the proprietary nature of many GenAI models: one example is the “AI Structural Biology Consortium”, a follow-up to AlphaFold-3, an ongoing project which makes use of data owned by pharmaceutical companies, which is secret and will remain secret (Callaway, 2025). Currently, solutions for access include open weights (e.g. Llama) and open source (including access to training data). The importance of openness was demonstrated by AlphaFold2, as the disclosure of its code and data triggered a series of initiatives refining the tool (Saplakoglu, 2024). Openness is essential to the cumulative progress at the core of science“ (OECD Digital Education Report 2026).
Am Beispiel von Pharmaunternehmen wird deutlich, dass es gerade in sensiblen Branchen wichtig ist, offene KI-Modelle zu nutzen. Offenheit ist: „Offenheit ist für den kumulativen Fortschritt im Kern der Wissenschaft unerlässlich“ (ebd.). Siehe dazu auch
KI-Agenten sind aktuell gefühlt überall. Natürlich bieten die proprietären Modelle wie ChatGPT, Gemini, Grok etc. viele Möglichkeiten an, solche KI-Agenten zu erstellen und zu nutzen. Wie Sie als Leser unseres Blogs wissen, tentieren wir allerdings dazu, Open Source AI zu nutzen, gerade wenn es um eigene, spezielle Expertise, oder unternehmensspezifisches Wissen in Innovationsprozessen geht.
Neben den von uns schon beschriebenen Möglichkeiten von Langflow und Ollama, möchten wir Ihnen eine weitere Alternative vorstellen, eigene KI-Agenten zu nutzen, und dabei unterschiedliche LLMs einzubinden.
„Smolagents is a minimalist AI agent framework developed by the Hugging Face team, crafted to enable developers to deploy robust agents with just a few lines of code. Embracing simplicity and efficiency, smolagents empowers large language models (LLMs) to interact seamlessly with the real world“ (Source: https://smolagents.org/de/).
Das Team von Hugging Face bietet hier eine minimalistische Möglichkeit, auf Open Source Basis KI-Agenten zu entwickeln, und der Community in einem Repository zur Verfügung zu stellen (Best Smolagents in Hugging Face).
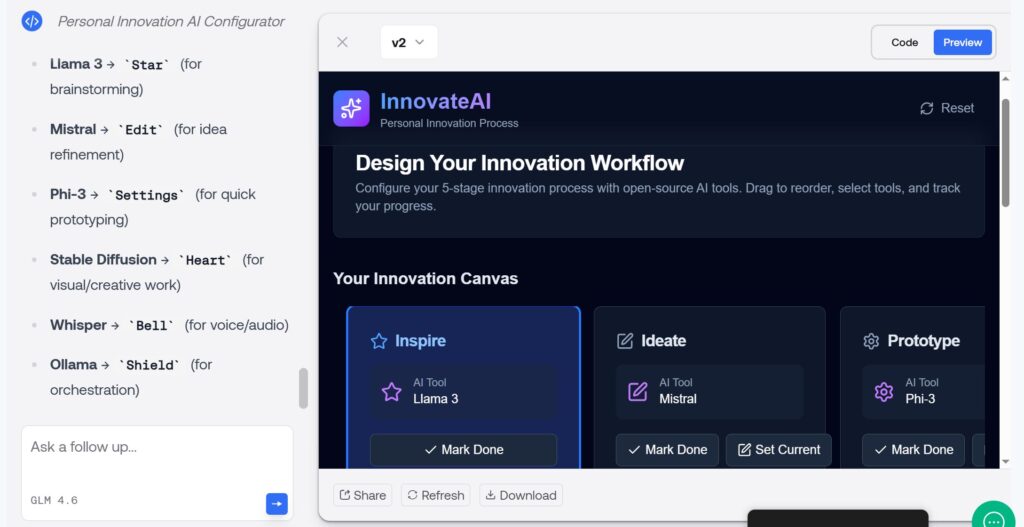
Es ist interessant zu sehen, wie einfach man seine Idee in einem ersten KI-Agenten umsetzen kann. In dem folgenden Beispiel habe ich versucht, einen persönlichen Innovationsprozess abzubilden. In jedem Prozessschritt wollte ich ein anderes Open Source KI-Modell einsetzen.
Eigener Screenshot
In der Abbildung sind erste Prozessschritte für die Entwicklung von Innovationen zu sehen: Inspire mit Llama 3, Ideate mit Mistral, Prototype mit Phi 3 etc. Die jeweiligen LLM kann ich auswählen und testen. Das ging sehr schnell und war super einfach.
AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.
Die Nutzung von KI-Modellen ist im privaten und unternehmerischen Umfeld angekommen. Dabei ist es für Kleine und Mittlere Unternehmen (KMU) entscheidend, ob sie sich in die Abhängigkeit der proprietären KI-Modelle begeben, oder mehr Wert auf die eigene Datenhoheit legen. Gerade KMU können es sich nicht leisten, hier knappe Ressourcen zu verschwenden.
Wenn es um Digitale Souveränität geht, und darum, leistungsfähige KI-Modelle mit eigenen oder anderen Daten zu verknüpfen, bietet das MCP-Protocol in der Zwischenzeit sehr spannende Möglichkeiten.
„MCP (Model Context Protocol) is an open standard from Anthropic designed to establish seamless interoperability between LLM applications and external tools, APIs, or data sources“ (Source: Langflow 1.4: Organize Workflows + Connect with MCP).
Wie das beispielsweise mit Langflow möglich ist, habe ich in verschiedenen Blogbeiträgen erläutert. Im Zusammenhang mit Open Source AI bietet das MCP einen Rahmen für ein eigenes, innovatives KI-System, bei dem Sie die Datenhoheit haben.
„Open-Source-Sprachmodelle sind die natürliche Ergänzung zu MCP. Während MCP den sicheren Rahmen vorgibt, liefern Open-Source-Modelle die Freiheit, diesen Rahmen nach eigenen Bedürfnissen zu gestalten“ (Hennekeuser, D. (2026): Model Context Protocol (MCP) und Open-Source-Sprachmodelle: Die Eröffnung neuer souveräner Wege. In Mittelstand Digital Fokus Mensch (2026): Digitale Souveränität als Basis für sichere KI-Anwendungen).
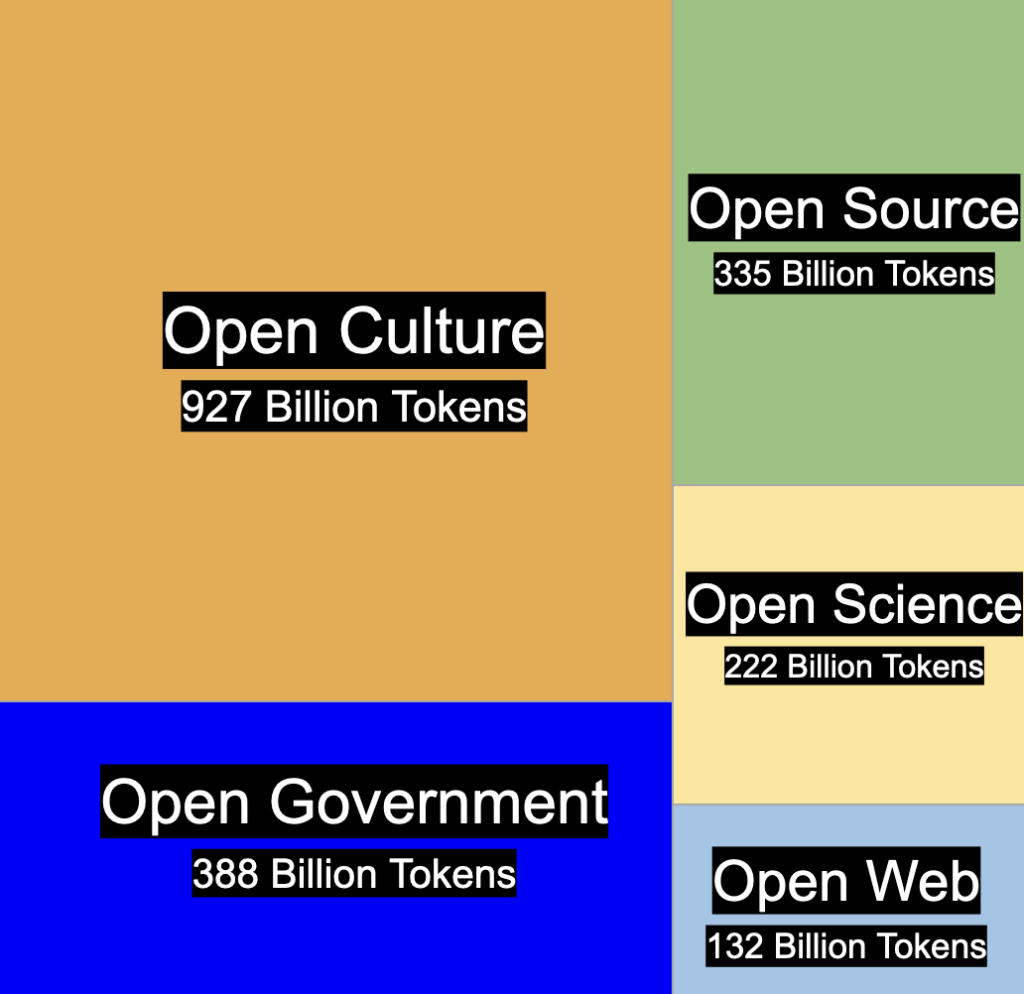
„Many have claimed that training large language models requires copyrighted data, making truly open AI development impossible. Today, Pleias is proving otherwise with the release of Common Corpus (part of the AI Alliance Open Trusted Data Initiative)—the largest fully open multilingual dataset for training LLMs, containing over 2 trillion tokens of permissibly licensed content with provenance information (2,003,039,184,047 tokens)“ (Source).
In der Zwischenzeit wurde Common Corpus schon mehr als 1 Millionen Mal heruntergeladen. Der starke Anstieg der Downloads zeigt eine relative Verschiebung auf dem KI-Markt, denn immer mehr Marktteilnehmer suchen nach Open Data, die sie frei nutzen können.
„Open-Source-Datensätze wie das Common Corpus bieten hier eine Lösung. Sie ermöglichen es Forschern und Unternehmen, auf eine breite Palette von Daten zuzugreifen, ohne sich über komplexe Lizenzfragen oder potenzielle Urheberrechtsverletzungen Gedanken machen zu müssen“ ( Common Corpus übertrifft eine Million Downloads und hebt Bedeutung von Open Data für KI hervor, Mindverse vom 12.03.2026).
Langsam aber sicher wollen immer mehr KI-Nutzer Künstliche Intelligenz gesellschaftlich verantwortungsvoll nutzen – ganz im Sinne einer Digitalen Souveränität.
Alle KI-Anwendungen basieren darauf, dass Daten zur Verfügung stehen. Bei den bekannten proprietären Anbietern ist die Herkunft der Daten, und der Umgang mit den Daten oft nicht transparent. Diese KI-Modelle werden daher auch Closed AI Models genannt.
Demgegenüber gibt es die (wirklichen) Open Source KI-Modelle, die sich an der Definition von Open Source AI orientieren, somit transparent sind, wie Mistral AI auch in Europe gehostet werden, und der DSGVO entsprechen.
Solche Modelle können auf viele frei verfügbaren Daten (Open Data) in Europa, Deutschland, ja sogar aus Ihrer Region zurückgreifen. Für Einzelpersonen und für Kleine und Mittlere Unternehmen (KMU) ist das wichtig, um keine rechtlichen Probleme bei der KI-Anwendung zu bekommen.
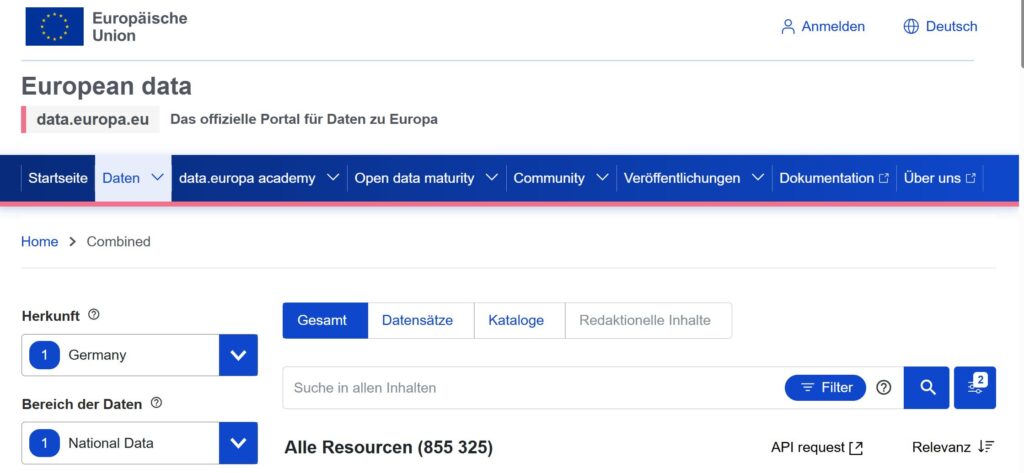
Dort kann man für jedes Land analysieren, welche Datensätze zur Verfügung stehen. In der folgenden Abbildung ist zu erkennen, dass für Deutschland 855.325 Datensätze (Stand: 05.04.2026) vorliegen..
Auf der Seite können Sie weiter auswählen und so die Datensätze (Open Data) recherchieren, die Sie für Ihre Anwendungen (Innovationen) im Unternehmen oder auch für sich selbst nutzen wollen.
Die Datensätze können dann in KI-Modelle eingebunden werden. Wir schlagen natürlich vor, Open Source KI zu verwenden, beispielsweise Mistral 3 Modellfamilie. Siehe dazu auch meine verschiedenen Blogbeiträge zu Mistral AI.
Open Data and Open Source AI – a perfect match. Ganz im Sinne einer Digitalen Souveränität.
Die beiden Kriege in der Ukraine und im Iran haben wieder einmal deutlich gemacht, wie Abhängig wir in Europa von der Lieferung fossiler Energie sind. Dabei haben wir gerade in den letzten 5-10 Jahren deutliche Fortschritte bei der Energiesicherheit gemacht. Beispielsweise hatten erneuerbare Energien in Deutschland Anfang 2026 einen 60%- Anteil an der Bruttostromerzeugung (Bundesministerium für Wirtschaft und Energie).
Im europäischen Raum mit seinen vernetzten Energiestrukturen kommt es nun immer stärker darauf an, die unterschiedlichen Netze sicher zu steuern, ohne auch hier wieder in eine technologische Abhängigkeit zu geraten. Das Fraunhofer Institut entwickelt hierzu die SCADA Plattform und setzt dabei bewusst auf Open Source.
Um Anomalien europaweit frühzeitig erkennen und beheben zu können, entwickeln die Forschenden eine Open-Source-Plattform zur Datenerfassung, Fernüberwachung und Steuerung von Energienetzen. Experten sprechen von einer SCADA Plattform, kurz für »Supervisory Control and Data Acquisition Platform«. (…) Die Open-Source Software ist quasi der Werkzeugkasten, mit dem das KI-Modell trainiert und später betrieben wird. Quelle: Auf zu sicherer Energie, Fraunhofer-Magazin 1 | 2026 (PDF).
Es ist bezeichnend, dass auch in der Energieversorgung auf Open Source Lösungen gesetzt wird, und dass diese dann Basis für die Anwendung Künstlicher Intelligenz sein wird. Ich würde mir wünschen, dass auch Open Source KI verwendet wird, da diese offen und transparent sind, und unsere Daten schützen. Ganz im Sinne einer Digitalen Souveränität.
Diese Website benutzt Cookies. Wenn du die Website weiter nutzt, gehen wir von deinem Einverständnis aus.