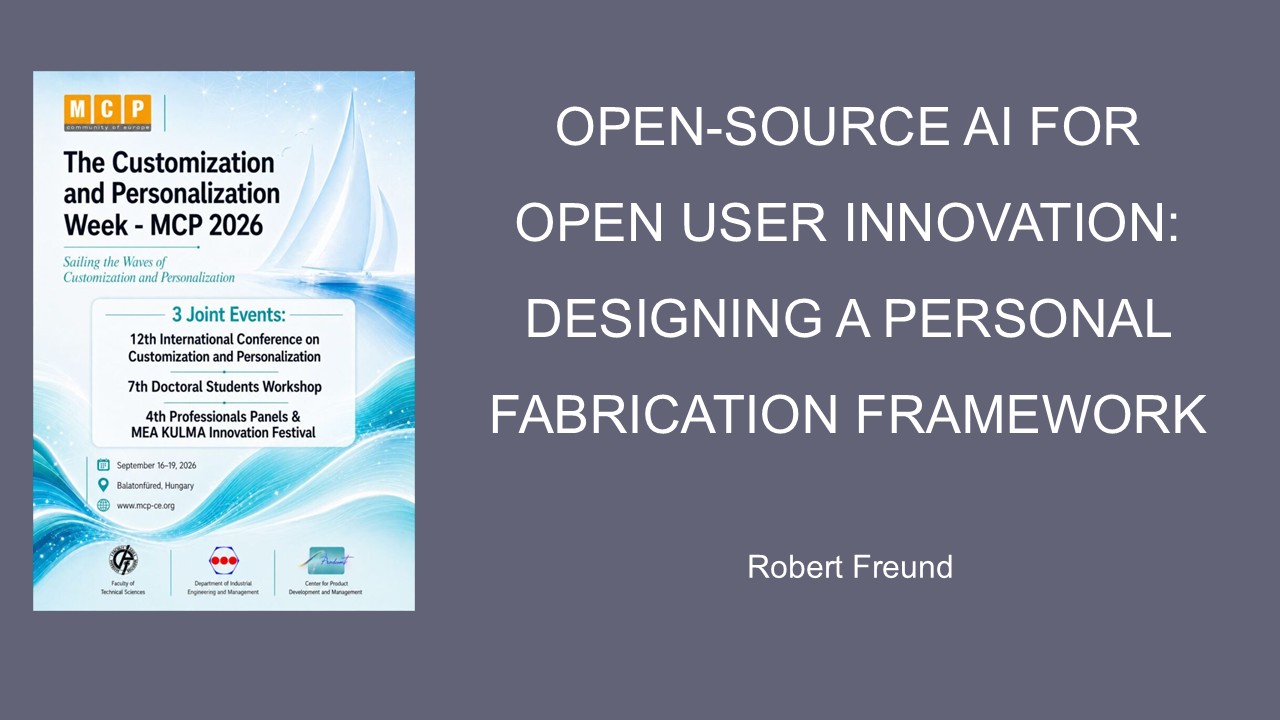
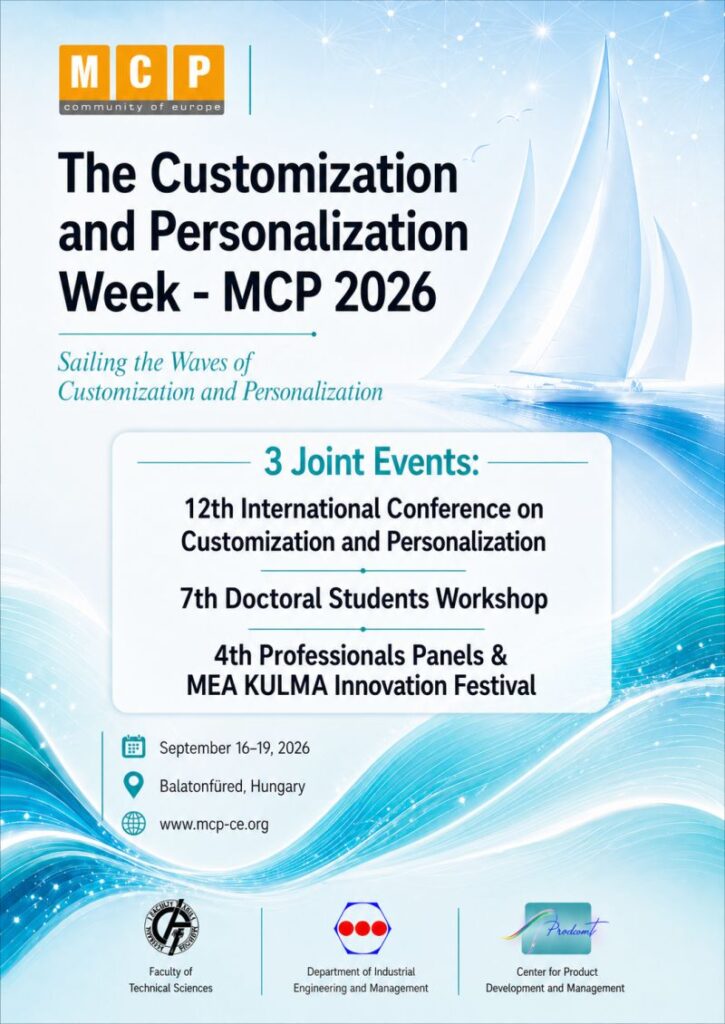
Meine Startfolie bei der Präsentation meines Papers auf der MCP 2026
Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework, in Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 76-85 · 17. Sep. 2026
Abstract: While the role of generative AI in producer-centric open innovation has attracted growing scholarly attention, its potential within Open User Innovation (OUI) — where individuals innovate for personal use rather than commercial sale — remains largely unexplored. This paper argues that Open-Source AI is structurally better aligned with user-driven innovation than proprietary models, because both share the principles of democratization, transparency, and contextual adaptability. Drawing on a literature-based conceptual approach, we examine the theoretical distinction between Chesbrough’s Open Innovation and von Hippel’s Open User Innovation paradigm, with particular attention to the user’s system of use — a framework that integrates product and behavioral innovations in context-specific ways. We then extend Baudisch and Müller’s (2017) six-challenge personal fabrication framework by incorporating Open User Innovation principles, Open-Source Software, Open-Source AI models, and Open-Source AI agents. A proof-of-concept illustration, using Mistral AI Vibe to support a FabLab-based fabrication task, demonstrates the framework’s practical applicability. The paper concludes by identifying three priority areas for future empirical research: validation through platform-based case studies, responsible integration of autonomous AI agents in user innovation, and cultural adaptation of the framework to regional contexts.
Wenn es um Künstliche Intelligenz geht, werden oftmals Begriffe benutzt, die in der Diskussion beliebig verwendet werden. Wenn es beispielsweise um den Begriff „Lernen“ geht, vermuten viele, dass es sich beim maschinellen Lernen um eine Art menschliches Lernen handelt. Durch Verkürzungen in den Beschreibungen werden (manchmal bewusst) Begriffe synonym verwendet. BTW: Joe Pine hat dieses Phänomen in Bezug auf Mass Customization and Personalization als Bastardization bezeichnet.
Wenn es um den Begriff „Lernen“ geht, haben Knauff et al. in ihrem aktuellen Paper folgendes deutlich gemacht:
„Der Unterschied ist dennoch entscheidend: anders als bei KI Systemen, zielt menschliches Lernen darauf ab, strukturierte, handlungsrelevante mentale Modelle in einer verkörperten Umwelt aufzubauen (Bohn, & Casillas, 2026; Butz & Kutter, 2017). Es geht um den aktiven Erwerb von Wissen und Überzeugungen, die zielgerichtete Entscheidungen in der physikalischen und sozialen Welt leiten. Maschinelles Lernen hingegen ist meist passiv: vorgegebene Daten werden genutzt, um die Parameter des vorgegebenen Modells zu optimieren.“ M. Knauff, M. V. Butz, B. Kaup, W. Kunde, and und I. Scharlau, “Vorhersage ist nicht Erklärung: Eine Perspektive der Fachgruppe Allgemeine Psychologie (gemeinsam mit der Gesellschaft für Kognitionswissenschaft),” Psychologische Rundschau, vol. 77, no. 4, pp. 225–231, Oct. 2026, doi: 10.1026/0033-3042/a000781.
Die Autoren widersprechen also der landläufigen Meinung, und den Marketingversprechen von Big Tech, in diesem Fall deutlich. Doch: Warum wird dennoch versucht, technische Systeme wie Menschen zu sehen? Indem technische Systeme punktuell mit der Leistungsfähigkeit von Menschen verglichen werden wird deutlich, wie unterlegen der Mensch gegenüber solchen Systemen ist, denn Künstliche Intelligenz kann vieles besser und schneller als es der Mensch jemals können wird. Es geht um die Dominanz der Technologie über den Menschen.
So eine Herangehensweise ist ein bewusster Kategorienfehler, wie von Knauff et al. alleine beim Begriff des „Lernens“ dargestellt wurde. Auch andere haben in der letzten Zeit große Bedenken, wenn es darum geht, die Leistungsfähigkeit von technischen Systemen mit der von Menschen zu vergleichen. Siehe dazu auch
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
In verschiedenen digitalen Räumen stellen sich Personen unterschiedlich dar, wobei diese Darstellung nicht unbedingt der digitalen Person (Persönlichkeit) entsprechen muss. Laura Robinson (2007) hat beispielsweise argumentiert, dass „das Subjekt anhand der digitalen Elemente ein „self-ing“ betreibe und sich sodann als „Cyberself“ (2007, S. 98) hervorbringe. Das Cyberself sei ein ephemeres Selbst, so Robinson, welches nur für kurze Zeit beständig, rasch änderbar und ohne langfristige Bedeutung sei, da es sich stets in Abhängigkeit zu Handlungen bilde (vgl. ebd.)“ (Rathmann 2022).
Robinson, L. (2007). The cyberself: the self-ing project goes online, symbolic interaction in the digital age. New Media & Society, 9(1), 93–110. https://doi.org/10.1177/1461444807072216
Auch KI-Modelle unterscheiden sich untereinander. Je nachdem mit welchen Daten, Restriktionen und Regeln sie versehen wurden, spiegeln diese KI-Modelle eine Art „Persönlichkeit“ gegenüber den Nutzern, die sich allerdings von der menschlichen Persönlichkeit unterscheidet.
„Auch KI weist individuelle Unterschiede und eine Art „Persönlichkeit“ auf. Jedoch unterscheiden sich LLMs grundlegend vom Menschen: Sie agieren ohne neurobiologische Prozesse und primär über sprachliche Kanäle, während sich menschliche Persönlichkeit multimodal manifestiert“ (Schrödel et al., 2026).
Wenn sich also Künstliche Intelligenz, und hier speziell das hinterlegte Large Language Model (LLM), mit seiner „Persönlichkeit“ der menschlichen Persönlichkeit annähert, ist es möglich, einen Prozess der ständigen Personalisierung von Aussagen, Dienstleistungen und Produkten anzustoßen.
„LLMs bieten damit interessante Ansatzpunkte für personalisierte Anwendungen: Sie können aktuelles Verhalten erkennen, zukünftige Entwicklungen vorhersagen und durch sprachbasierte Interventionen gezielt verändern. Eine fortlaufende Personalisierung auf Basis längerer Interaktionsverläufe dürfte die Wirksamkeit dieser Schritte erhöhen. Belastbare empirische Evidenz zu Wirksamkeit und Nebenwirkungen fehlt bislang (Stade et al., 2024)“ Schödel et al., (2026). Künstliche Intelligenz und Individuelle Unterschiede: Eine Perspektive der Fachgruppe Differentielle Psychologie, Persönlichkeitspsychologie und Psychologische Diagnostik, Psychologische Rundschau, vol. 77, no. 3, pp. 149–155, Jul. 2026, doi: 10.1026/0033-3042/a000766.
Wenn sich also ein LLM – oder mehrere – immer wieder an die das Cyber-self anpasst, kann das gut gelingen, es kann allerdings auch sein, dass dieses multiple Cyberself gar nicht der analogen Person entspricht. Es käme dann zu einem Mismatch, der nicht dazu beiträgt, Werte für den Nutzer zu schaffen. Im schlimmsten Fall, könnte der Prozess sogar Werte vernichten.
Wenn ein Unternehmen also Personalisierung mit Hilfe der verfügbaren LLMs aufbauen möchte, sollte es sich darüber im Klaren sein, dass das Cyberself von dem analogen Menschen immer noch abweicht. Ich habe manchmal den Eindruck, dass Unternehmen immer noch dem Mythos unterliegen, dass sie durch die vielen generierten Daten eine Art Abbild vom Menschen vorliegen haben.
In der von mir initiierten Konferenzreihe zu Customization and Personalization geht die Community of Europe auf solche Zusammenhängen mit aktuellen Forschungsergebnissen und Fallstudien ein. Zuletzt haben wir uns auf der MCP 2026 vom 16.-19.09. in Balatonfüred (Ungarn) getroffen. Auch 2028 werden wir uns wieder treffen. Zu der Konferenzreihe können Sie sich gerne auf MCP-CE.org informieren.
Immer mehr User (Nutzer) entwickeln ihre eigenen Produkte, da die Unternehmen mit ihren begrenzten Ressourcen (fixed innovation space) und Renditeüberlegungen oftmals Ideen von Usern nicht umsetzen. In meinem Paper zur MCP 2026 habe ich das ausführlich hergeleitet und beschrieben:
Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework. Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 76-85 · 17. Sep. 2026
Die Konferenzreihe legt seit 2004 alle 2 Jahre den Fokus auf (Mass) Customization and Personalization. – siehe MCP-CE.org. Dabei ging es in der Vergangenheit meistens darum herauszufinden, wie Unternehmen mit neuen Technologien – und jetzt auch mit Künstlicher Intelligenz – (massenhaft) individuelle Produkte und Dienstleistungen anbieten können – zum Preis von Standardprodukten.
In meinem Paper habe ich den Ansatz Customization and Personalization aus der Perspektive eines Users dargestellt: Open User Innovation. An mehreren Beispielen konnte ich aufzeigen, wie es in den letzten Jahren einen Paradigmenwechsel gegeben hat. User sind heute immer mehr in der Lage, ihre Ideen selbst umzusetzen. Dabei helfen natürlich die niederschwelligen Technologien der Maker Bewegung und Künstliche Intelligenz, um die vielen Hürden im Prozess der persönlichen Fabrikation zu überwinden.
Über meine in dem Paper genannten Beispiele hinaus, wird nun auch deutlich, dass es in Zukunft auch möglich sein wird, seine eigene Software von Künstlicher Intelligenz „bauen“ zu lassen. Lange genug haben wir uns den etablierten Softwareanbieter angepasst, ja geradezu unterworfen.
Wenn über 97% der Codebasis von Software Open Source ist, sollte es möglich sein, aus diesen Bausteinen seine eigene Software zusammenzustellen. Künstliche Intelligenz kann hier bei den Schnittstellen und möglichen rechtlichen Fragen helfen.
„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).
Auch die aktuellen Entwicklungen beim Vibe Coding gehen in diese Richtung. Dabei wird mit Hilfe eines Prompts der Quellcode von Künstlicher Intelligenz generiert. Warum eigentlich nicht?
Ich bin gespannt, was es in diesem Bereich noch für überraschende neue Chancen für die „Herstellung“ eigener Produkte und Dienstleistungen geben wird. Ganz im Sinne einer Open User Innovation, die sich von den etablierten Unternehmensangeboten löst, und eigene Lösungen entwickelt und nutzt.
In der nächsten Woche trifft sich die Customization und Personalization Community auf der MCP 2026. Die letzten Konferenzen, die seit 2004 alle 2 Jahre stattfinden, hatten wir an der Technischen Universität Novi Sad (Serbien) durchgeführt. Da die Gesamtsituation an der Universität für Lehrende und für Studenten immer schwieriger wurde, haben wir uns dazu entschlossen, diesmal nach Balatonfüred in Ungarn auszuweichen.
Wie nach allen letzten Konferenzen auch werden wir auch nach der MCP 2026 ausführlich über alle Themen reflektieren. Als Initiator der Konferenzreihe, die in Rzeszow (Polen) in 2004 begann, kann ich mich nur bei allen bedanken, die diese Konferenzreihe schon so lange mit ihrer Teilnahme unterstützen.
Wir (Jutta und ich) freuen uns schon jetzt, die Kollegen und Freunde in der kommenden Woche in Balatonfüred zu treffen. Auf der Konferenz stelle ich zwei Paper vor:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
In unserem Blog habe ich schon des Öfteren über Green Washing, Open Washing und Sovereignty Washing geschrieben. Doch gibt es auch zu vielen anderen Themen immer wieder Ungenauigkeiten und Plattitüden, die die Personen aufregen, die neue Begriffe oder Konzepte entwickelt und etabliert haben.
In einem Beitrag von B. Joseph Pine II geht es beispielsweise unter anderem um den von Davis formulierten Begriff Mass Customization als Oxymoron, und um das von Pine dazu veröffentlichte Buch, in dem er das Konzept einer hybriden Wettbewerbsstrategie skizziert..
Pine ist der Auffassung, dass CRM (Customer Relationship Management) den Ansatz von Mass Customization bastardisiert hat.
„Mass Customization was coined by the late great Stan Davis in his 1987 book Future Perfect, which is as applicable today as when he wrote it. I read his book while a strategic planner at IBM and after getting it into our plans and strategies spent a year at MIT where I turned my masters’ thesis into my first book, Mass Customization: The New Frontier in Business Competition.
CRM bastardized the concept of Mass Customization
CRM bastardized the concept of Mass Customization, which is about understanding individual customers and giving them exactly what they want. In the hands of consultants and software companies, however, CRM became understanding individual customers to better sell them what has already been produced. Ouch.“(Joe Pine (2026): It´s called bastardization).
Da der Ansatz von Mass Customization and Personalization in so vielfältiger Weise verwässert wurde und wird, sollte man sich möglichst aus erster Hand informieren und keine Sekundär-, Tertiärquellen oder „Erzählungen“ von Beratern nutzen.
Eine sehr gute Möglichkeit bietet sich bei den jeweiligen Konferenzen zu Mass Customization and Personalization.
Die von mir initiierte Konferenzreihe findet seit 2004 alle 2 Jahre statt.
In diesem Jahr, treffen wir uns auf der MCP 2026 vom 16.-19.09.2026 in Balatonfüred, Ungarn.
Die Internationale Konferenz zu Mass Customization and Personalization, MCP 2026, findet diesmal vom 16.-19.2026 in Balatonfüred, Ungarn statt. Es freut mich sehr, dass die von mir in 2004 initiierte Konferenzreihe alle 2 Jahre stattfindet. Die MCP 2026 ist somit die 12. Konferenz ihrer Art. Auf der MCP 2026 Website finden Sie auch Informationen zu allen vergangenen Konferenzen.
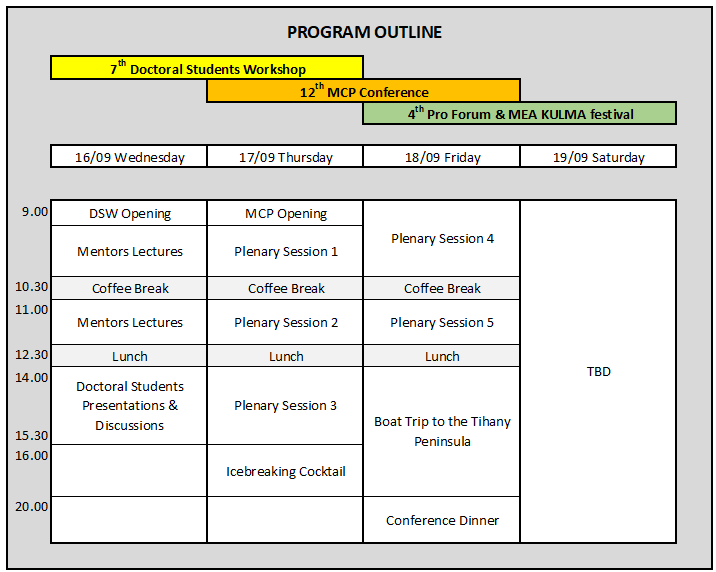
Wie in den bisherigen Konferenzen üblich starten wir mit einem Doktoranden-Workshop, in dem die Teilnehmer von erfahrenen Professoren in Ihren arbeiten unterstützt werden.
Anschließend stellen Teilnehmer ihre eingereichten und bestätigten Paper in kurzen Präsentation und ihre Arbeiten vor. Dabei bleibt auch Zeit für Diskussionen. Ich bin sehr gespannt darauf, welche Fragen und Anregungen zu meinen Themen kommen werden.
Ein weiteres wichtiges Element bei der Konferenz ist das soziale Zusammensein. Dazu haben alle Teilnehmer im Laufe der Tage immer wieder Gelegenheit. Speziell natürlich beim Ice Breaking Cocktail und beim Conference Dinner.
Am Samstag ist noch ein Innovations-Forum geplant, dessen Ablauf aktuell allerdings noch nicht feststeht.
Wir (Jutta und ich) freuen uns schon sehr, die Teilnehmer persönlich in Balatonfüred zu treffen. Es ist auf allen Ebenen sehr bereichernd, sich mit interessanten Menschen auszutauschen.
Am 12. November 2025 habe ich in einem Blogbeitrag auf KMI 2 Thinking hingewiesen. Nach DeepSeek R1 war KIMI 2 ein weiteres chinesisches Modell das aufgezeigt hatte, dass es möglich ist ein leistungsfähiges Open Source KI-Modell zu entwickeln, das viel weniger Ressourcen – und damit Kosten – erfordert. Der Schwerpunkt des von KIMI 2 Thinking liegt dabei auf „Coding“.
Nun ist mit KIMI 3 ein weiteres Open Source KI-Modell für den 27.07.2026 angekündigt. Wenn man es genau nimmt, ist es ein Open Weight Modell, da die Trainingsdaten nicht frei verfügbar sind. Der Schwerpunkt liegt bei dem Modell wieder auf Coding, allerdings auch auf Knowledge Work (Wissensarbeit).
„Kimi K3 is the first open-source model to reach 2.8 trillion parameters.“ Source: KIMI Platform, accessed 19.07.2026).
In dem Beitrag Moonshot AI zeigt Kimi K3: Open- Source-KI aus China (IT Business vom 17.07.2026 wird auf die Leistungsfähigkeit des Modells hingewiesen („Vorsprung der USA auf chinesische KI-Labore mittlerweile auf nur noch sechs bis neun Monate geschmolzen“).
Weiterhin musss allerdings auch kritisch angemerkt werden, dass chinesische KI Modell (Open Source AI oder nicht) den Vorgaben der chinesischen (und amerikanischen ) Administration unterliegen. In China sind beispielsweise Beiträge zu Taiwan oder zum Tiananmen-Platz usw. reglementiert. Solche Restriktionen schränken die Qualität der generierten Antworten deutlich ein.
Die Chance von Europa ist, Open Source KI-Modelle zu entwickeln, die auch einen niedrigen Ressourcenbedarf haben, ein ähnliches oder bessres Leistungsniveau wie die chinesischen open source Modelle haben, und letztendlich den europäischen Werten entsprechen.
Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auf solche Entwicklungen ein:
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
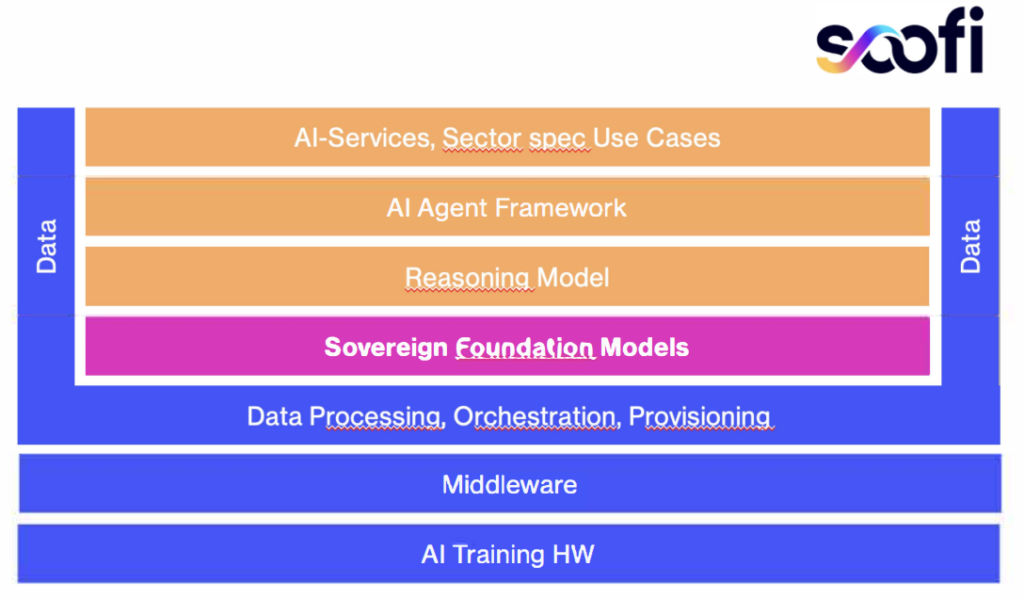
Das Modell ist auf englische und deutsche Texte ausgelegt und ein 30B Mixture-of-Experts-Modell. Dabei wird für den jeweiligen Input das geeignete Experten-Modell ausgewählt, um einen qualitativ hochwertigen Output zu generieren. Die folgende Abbildung zeigt die Intergration des Souvereign Foundation Models in das Gesamtkonzept.
Quelle: https://www.soofi.info/
Aktuell wird das SOOFI S Modell in industriellen Anwendungen getestet. Die dabei gemachten Erfahrungen fließen in das Modell ein. Eine Veröffentlichung zur allgemeinen Nutzung ist daher noch nicht erfolgt.
SOOFI S ist ein weiteres positives Beispiel für ein europäisches Open Source Foundation Model, das es Unternehmen in der Zukunft ermöglichen wird, ihre Abhängigkeiten von US amerikanischen oder chinesischen Modellen zu reduzieren. Dadurch werden die Organisationen digital souveräner und letztendlich auch resilienter.
Die Abhängigkeiten von US amerikanischen KI-Systemen führt zwangsläufig zu der berechtigten und aktuellen Frage: Was passiert, wenn der Zugang zu wichtigen und modernen KI-Systemen reduziert, oder gar verwehrt wird. Dass dieses Szenario nicht nur theoretisch, sondern praktisch besteht, hat die Anweisung der US Regierung den Zugang zu zu Fable 5 und Mythos 5 auszusetzen gezeigt.
„In der öffentlichen Diskussion ist der „Kill Switch“, also die Einschränkung oder Abschaltung digitaler Dienste für einzelne Personen, Organisationen oder sogar ganze Staaten, ein viel beachtetes Thema. Eine zentrale Rolle spielt dabei US-Präsident Donald Trump, der öffentlich damit gedroht hat, den Zugang zu US-Digitaldiensten, wie denen der Hyperscaler, einzuschränken oder vollständig zu sperren“ (Lünendonk-Studie 2026).
Wenn andere entscheiden, was wir tun dürfen ist das Fremdbestimmung, mit allen Konsequenzen. Wenn wir alles selbst machen könnten, wären wir autark. Zwischen beiden Polen ist die Souveränität (hier: Digitale Souveränität) anzusiedeln:
„Wir sind handlungsfähig und entscheiden selbst, was wir tun“ (ebd.).
Der oben erwähnte Kill Switch, oder auch die Möglichkeit eines Kill Switchs, sollten Treiber für einen selbstbestimmten, an europäischen Werten ausgerichteten offenen Zugang zu digitalen Systemen sein. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.
Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred, Ungarn, vor:
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Diese Website benutzt Cookies. Wenn du die Website weiter nutzt, gehen wir von deinem Einverständnis aus.