Divergentes und konvergentes Denken mit KI unterstützen

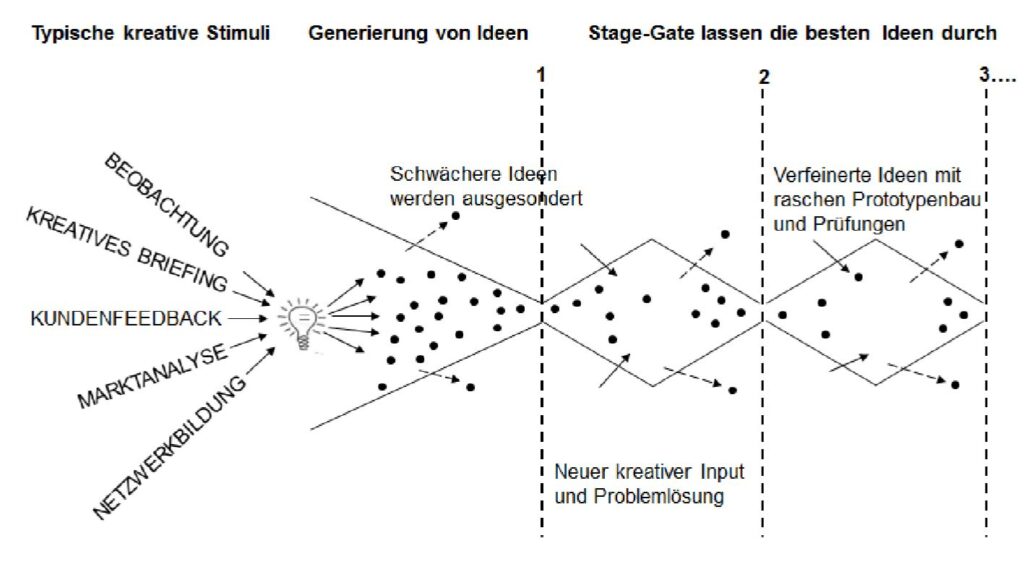
Typischer Stage-Gate Ideenverfeinerungs- und Auswahlprozess (CEN/TS 16555-2014)

Für den kreativen Prozess, bzw. den Problemlösungsprozess, sind grundsätzlich zwei Denkstile erforderlich (Hornung/Patzak 2011):

Divergentes Denken (divergent: „auseinandergehend, ausschweifend, verzweigend“): die Gedanken schweifen lassen, in die Breite gehendes Denken, den Gedanken freien Lauf lassen, eine Ausweitung des Suchraumes.

Konvergentes Denken (konvergent: „zusammenlaufend, zusammenführend“): die Gedanken auf einen Punkt bringen, einem Ziel zuführen, eine Einengung des Suchraumes, vorsehen von Randbedingungen und Beschränkungen.

Divergentes und Konvergentes Denken sind im Ideenverfeinerungs- und Auswahlprozess gefragt (Abbildung).

Die jeweiligen Schritte können heute gut mit Künstlicher Intelligenz unterstützt werden. Es stellen sich dabei folgend Fragen:

Welches KI-Modell soll verwendet werden? Eher ein Modell, oder mehrere, spezialisierte Modelle? Siehe dazu Von „One Size Fits All“ über Variantenvielfalt in die Komplexitätsfalle?

Soll es ein proprietäres KI-Modell sein, oder doch besser ein Open Source AI Modell? Siehe dazu Das Kontinuum zwischen Closed Source AI und Open Source AI.

Welche Daten sollen verwendet werden? Sollen relativ wahllos Daten aus den Netz genutzt werden? Das kann zu rechtlichen Problemen führen. Oder sollen frei verfügbare (Open Data) Daten und eigene Daten aus der Organisation genutzt werden?

Bei der Beantwortung der jeweiligen Fragen merkt man sehr schnell, dass Open Data und Open Source AI ein perfect match bilden.

Natürlich kann der Prozess auch weiter geöffnet werden, wobei sich zwei Ansätze anbieten: Einmal ist es der Open Innovation Ansatz von Henry Chesbrough, der von offeneren Innovationsprozessen in Unternehmen ausgeht und somit auf das jeweilige Business Model zielt.

Andererseits kann ein persönlicher offener Innovationsprozess, also Open User Innovation nach Henry Chesbrough gemeint sein. Siehe dazu Henry Chesbrough über die Zukunft von Open Innovation.

Racka-4B – ein ungarisches KI-Modell

Image by Hermann Traub from Pixabay

In dem Blogbeitrag Für agglutinierende Sprachen wie Ungarisch, Baskisch, etc. reichen die üblichen KI-Modelle nicht aus wurde deutlich, dass es beispielsweise für die ungarische Sprache gut ist, ein spezielles Modell zu haben. So ein Modell (LLM) liegt nun mit Racka (Regionális Adatokon Célzottan Kialakított Alapmodell) vor.

„We present Racka-4B, a lightweight, continually pretrained large language model designed to bridge the resource gap between Hungarian and high-resource languages such as English and German. (…) The results also showcase that Racka-4B is capable of Hungarian chat with English reasoning even in the absence of explicit Hungarian post-training on these tasks“ (Csibi, Z. et al. (2026): Racka: Efficient Hungarian LLM Adaptation on Academic Infrastructure | PDF).

Das Modell Racka-4B basiert auf Qwen-3 und steht bei Huggingface zur Verfügung. Es ist also transparent und offen – ganz im Gegensatz zu den proprietären KI-Modellen der großen Tech-Konzerne. Diese suggerieren, dass es ausreicht, ein Modell für alles zu haben.

Dieser One Size Fits All – Gedanke ist zwar aus deren Sicht wirtschaftlich interessant, doch trifft dieser Ansatz immer weniger die Bedürfnisse der Menschen. Auch Racka-4B bestätigt eine Entwicklung zu europäischen Sprach-Modellen, die stärker regionale Besonderheiten berücksichtigen. Siehe dazu auch

Die MCP Community of Europe trifft sich in diesem Jahr vom 16.-19.09.2026 auf der MCP 2026 in Balatonfüred, Ungarn. Neueste Entwicklungen zu Mass Customization and Personalization, auch in Zeiten von Künstlicher Intelligenz, werden auf der Konferenz vorgestellt und diskutiert. Die Konferenz findet seit 2004 durchgehend alle 2 Jahre statt – die MCP 2026 ist somit die 12. Konferenz ihrer Art.

Open EuroLLM: Ein Modell Made in Europe – eingebunden in unsere LocalAI

Künstliche Intelligenz: Das polnische Sprachmodell PLLuM

Minerva AI LLM: Das italienischsprachige KI-Modell

Open Source AI: Veröffentlichung der ALIA AI Modelle für ca. 600 Millionen Spanisch sprechender Menschen weltweit

Mistral Forge: Eigene Unternehmens-KI entwickeln

Quelle: https://mistral.ai/products/forge

Die Nutzung den bekannten KI-Modelle (GenAI) wie ChatGPT, Gemini, Grok, Anthropic, Claude etc ist weit verbreitet. Es ist auch möglich, diese Modelle mit eigenen Daten zu trainieren, doch ist der Großteil dann immer noch zu wenig unternehmensspezifisch. Siehe dazu auch Digitale Souveränität: Europa, USA und China im Vergleich.

Mistral AI ist hier in den letzten Jahren einen eigenen Weg gegangen, indem es als europäische Modell Familie DSGVO-konform ist, und auch als Open Source AI zur Verfügung steht.

Mit dem nun veröffentlichten Mistral Forge können Unternehmen auf Basis der eigenen Daten und Expertise ihr eigenes KI-Modell entwickeln.

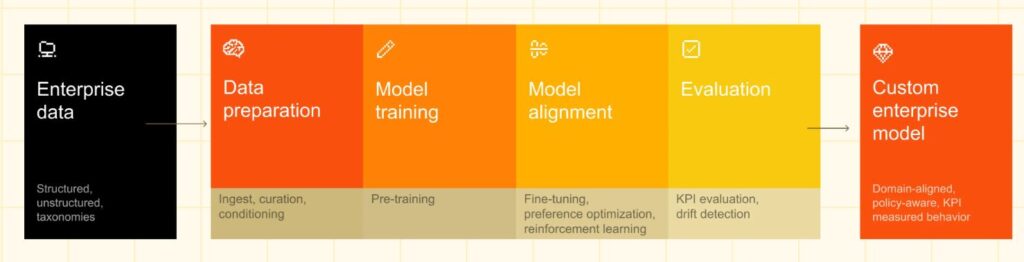
From your data to your model

Vorgehensweise bei Mistral Forge: https://mistral.ai/products/forge

Die einzelnen Schritte werden auf der genannten Webseite ausführlich dargestellt. Es wir spannend zu sehen, welche Organisationen diesen Weg gehen werden. Aktuell sind das immerhin so bekannte Namen wie ASML, Ericsson, ESA und DSO National Laboratories aus Singapur. Siehe dazu auch

Österreichische Verwaltung setzt bei Künstlicher Intelligenz auf Mistral

Mistral Le Chat: Eine europäische Alternative zu ChatGPT

Digitale Souveränität: Mistral 3 KI-Modell-Familie veröffentlicht

Wenn alle die selben KI-Workflows nutzen entsteht eine wissenschaftliche Monokultur

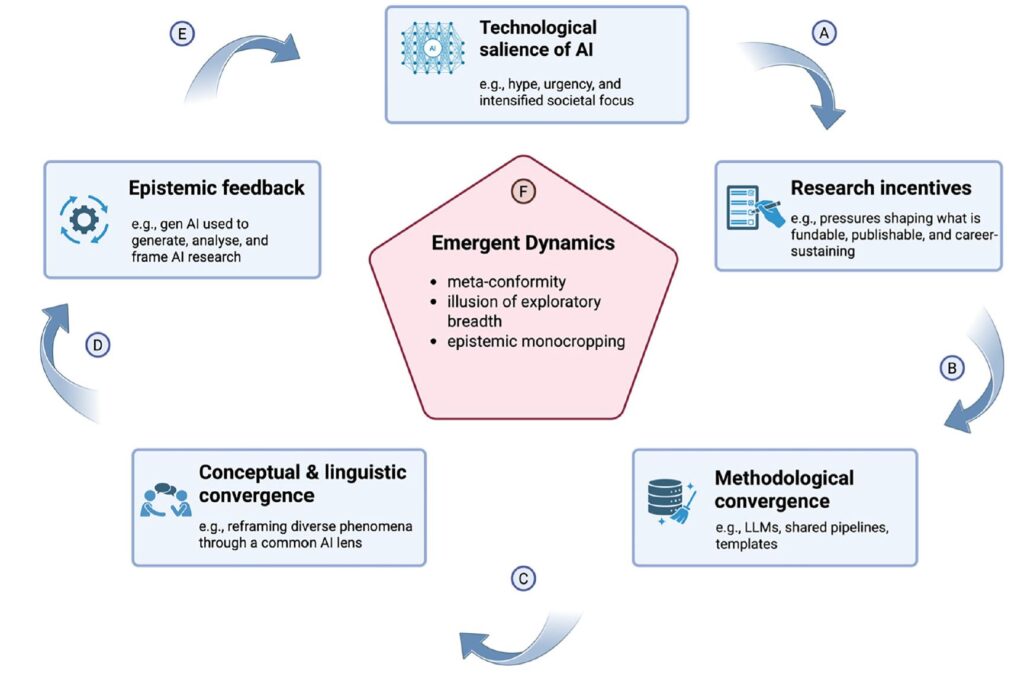
AI monoculture feedback loop (Traberg et al. 2026)

In allen möglichen Kontexten soll und wird Künstliche Intelligenz genutzt. Dabei dominieren in unserem Kulturkreis die von den amerikanischen Konzernen entwickelten GenAI-Modelle. Diese werden in allen privaten und organisatorischen Prozessen integriert. Ein Großteil der Personen und Organisationen nutzen dabei die gleichen KI-Workflows.

Das hat beispielsweise im wissenschaftlichen Kontext einen unschönen Effekt: Dadurch, dass alle Wissenschaftler mehr oder weniger stark die selben GenAI-Modelle für ihre Arbeiten nutzen, kommt es zu einer Art „wissenschaftlicher Monokultur„.

Traberg, C.S., Roozenbeek, J. & van der Linden, S. AI is turning research into a scientific monoculture. Commun Psychol 4, 37 (2026). https://doi.org/10.1038/s44271-026-00428-5

In der Abbildung ist der Kreislauf mit seinen einzelnen Schritten dargestellt. Es wird deutlich, dass es sich hier um eine Art Generator handelt, also ein sich selbst verstärkender Wirkungskreislauf.

Auch hier wird deutlich, dass es gut ist, verschiedene KI-Modelle für wissenschaftliche Arbeiten zu nutzen, und die jeweiligen Ergebnisse zu bewerten.

Es stellt sich natürlich auch gleich die Frage, ob diese „wissenschaftliche Monokultur“ auch bei Innovationsprozessen vorkommt. Auch hier nutzen viele Personen und Unternehmen oftmals die gleichen KI-Modelle.

Minerva AI LLM: Das italienischsprachige KI-Modell

https://minerva-ai.org/

In dem Blogbeitrag Open Source AI-Models for Europe: Teuken 7B – Training on >50% non English Data hatte ich schon erläutert, wie wichtig es ist, dass sich Organisationen und auch Privatpersonen nicht nur an den bekannten AI-Modellen der Tech-Giganten orientieren.

Die dort oftmals hinterlegten Daten, die natürlich zum überwiegenden Teil in Englisch (oder Chinesisch) vorliegen, spiegeln nicht die vielfältige europäische Kultur mit ihren vielen Nuancen wieder. Kulturelle Bereiche, definieren sich oftmals über die jeweilige Sprache.

Es ist daher nicht verwunderlich, dass es in den jeweiligen europäischen Ländern einen Trend gibt, KI-Modelle zu entwickeln, die die jeweilige sprachlichen Besonderheiten beachten – wie z.B. Minerva AI LLM:

Minerva AI LLM is the first family of Large Language Models pretrained from scratch in Italian developed by Sapienza NLP in collaboration with Future Artificial Intelligence Research (FAIR) and CIN AIECA. The Minerva models are truly-open (data and model) Italian-English LLMs, with approximately half of the pretraining data composed of Italian text. You can chat with Minerva for free directly through the app — it’s easy, fast, and open to everyone.

Es handelt sich also um eine Modell-Familie, die offen für jeden nutzbar ist. Es zeigt sich auch hier wieder, dass Künstliche Intelligenz auf Vertrauen basieren muss, damit sie den gesellschaftlichen und wirtschaftlichen Anforderungen gerecht werden kann. Siehe dazu auch beispielhaft

Künstliche Intelligenz – It All Starts with Trust

Open EuroLLM: Ein Modell Made in Europe

Spanisch: Open Source AI: Veröffentlichung der ALIA AI Modelle für ca. 600 Millionen Spanisch sprechender Menschen weltweit

Schwedisch: GPT SW3

Macht es heute noch Sinn, den Begriff „Verbraucher“ zu verwenden?

Image by gonghuimin468 from Pixabay

Die verwendete Sprache, und hier speziell die verwendeten Begriffe, lassen oft Rückschlusse auf die dazugehörende Denkweise (Mindset) zu. Beispielsweise ist die Metapher „Unternehmen als Maschine“ oder „Menschen sind Zahnräder“ sinnbildlich für eine sehr mechanistische Denkweise, die heute in vielen Bereichen nicht mehr angemessen erscheint.

Der Begriff „Verbraucher“ hat eine ähnliche Wirkung. In vielen Meldungen, Statistiken usw. wird immer noch der Begriff verwendet, gerade so, als ob alle Produkte und Dienstleistungen verzehrt werden, also einer Abnutzung unterliegen.

„Verbrauch ist in der Wirtschaftstheorie der Verzehr von Gütern und Dienstleistungen zur direkten oder indirekten Bedürfnisbefriedigung. Ein Synonym für Verbrauch ist Konsum“ (Quelle: Wikipedia) Bei einem Acker ist das so, da hier die Fläche begrenzt, und nicht so einfach erweiterbar ist. Es leuchtet daher ein, dass versucht wird, das „maximale aus dem Boden herauszuholen“.

Bei digitalen Produkten ist das etwas anders. Auf das eben beschriebene Beispiel angewendet bedeutet das: „Der digitale Acker ist ein Zauberhut, aus dem sich ein Kaninchen nach dem anderen ziehen lässt, ohne dass er jemals leer würde. Die »Verbraucher« von Informationsgütern »verbrauchen« ja eben gerade nichts“ (Grassmuck 2004, Bundeszentrale für politische Bildung (bpb), 2., korrigierte Auflage).

In einer immer stärker digitalisierten Welt, werden digitale Produkte und Dienstleistungen durch deren Nutzung nicht „verbraucht“, sondern ganz im Gegenteil: Durch die Nutzung von Daten und Informationen entstehen wieder viele neue Daten, die dann oftmals von Unternehmen wertschöpfend genutzt werden. Daten sind für diese Unternehmen das neue Öl.

Im Zusammenhang mit digitalen Produkten (Daten, Informationen, Wissen) sollten wir daher nicht mehr von „Verbraucher“ sprechen, da der Begriff einfach nicht mehr passt.

Common Crawl: Freie Daten für jeden?

Website: https://commoncrawl.org/

Large Language Models (LLMs) benötigen eine Unmenge an Daten. Bei den Closed Source KI-Modellen von OpenAI, Meta, etc. ist manchmal nicht so klar (Black Box), woher diese ihre Trainingsdaten nehmen. Eine Quelle scheint Common Crawl zu sein.

„Common Crawl maintains a free, open repository of web crawl data that can be used by anyone. The Common Crawl corpus contains petabytes of data, regularly collected since 2008“ (ebd.)

Die Daten werden von Amazon gehostet, können allerdings auch ohne Amazon-Konto genutzt werden. Eine Datensammlung, die für jeden frei nutzbar und transparent ist, und sogar rechtlichen und Datenschutz-Anforderungen genügt, wäre schon toll.

Doch es gibt auch Kritik: Wie auf der Wikipedia-Seite zu Common Crawl zu lesen ist, respektiert Common Crawl wohl nicht immer Paywalls bei ihrer Datensammlung: Wired (2024): Publishers Target Common Crawl In Fight Over AI Training Data.

Es ist also Vorsicht geboten, wenn man Common Crawl nutzen möchte. Dennoch kann diese Entwicklung interessant für diejenigen sein, die ihr eigenes, auf den Werten von Open Source AI basierendes KI-Modell nutzen wollen. Siehe dazu auch

Open Source AI: Common Corpus als größte offene Trainingsdatenbank veröffentlicht.

Open Source AI-Models for Europe: Teuken 7B – Training on >50% non English Data.

Organisationale Daten-Souveränität bedeutet nicht unbedingt Digitale Souveränität

Image by Tumisu from Pixabay

Digitale Souveränität wird oftmals mit Daten-Souveränität in Organisationen verwechselt. Es ist daher wichtig zu verstehen, was Organisationale Daten-Souveränität ausmachen kann. Dazu habe ich folgenden Vorschlag in einem Paper gefunden:

„We define organizational data sovereignty as the self-determined and deliberate exercise of control over an organization’s data assets, which includes the recognition of their value, the proactive management of data activities (collection, storage, sharing, analysis, and interpretation), and the ability to assimilate and apply these data to drive value creation through interorganizational collaboration“ (Moschko et al. 2024).

In dem Paper geht es den Autoren um Organisationale Daten-Souveränität in Bezug auf Open Value Creation (OVC) in offenen Innovationsprozessen (Open Innovation).

Die hier angesprochene eigene (organisationale) Kontrolle der Daten würde durch den Einsatz von proprietären (Closed Models) KI-Anwendungen konterkariert, da man bei deren Nutzung nicht wirklich weiß, was mit den eigenen Daten passiert. Siehe dazu auch Künstliche Intelligenz: Würden Sie aus diesem Glas trinken?

In dem Blogbeitrag Digitale Souveränität, oder doch nur Souveränitäts-Washing? finden Sie eine Definition von Digitaler Souveränität. Dabei werden Sie feststellen, dass Digitale Souveränität in diesem Sinne nur möglich ist, wenn Open Source AI – Modelle verwendet werden.

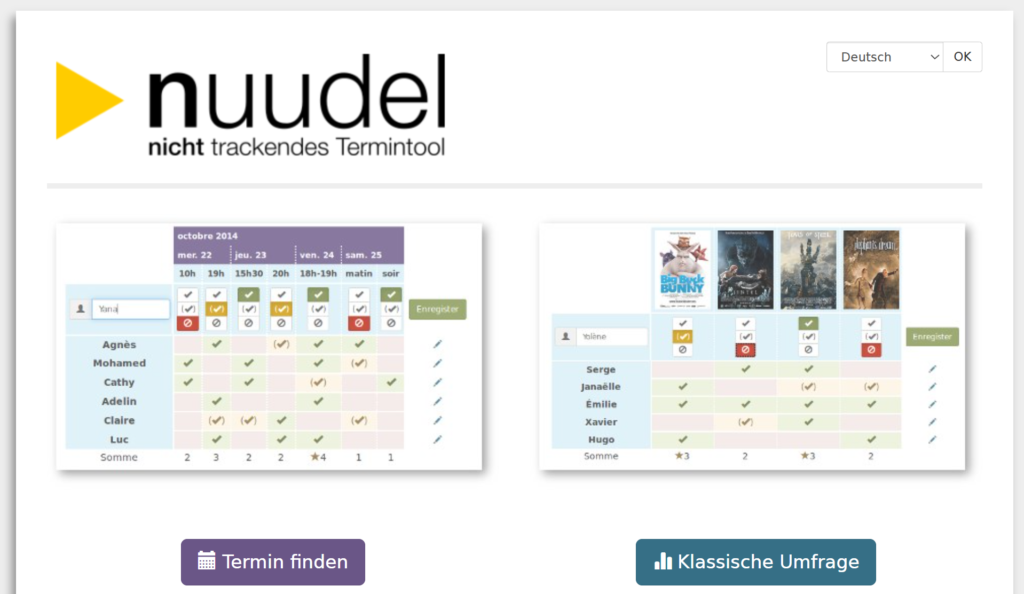
Digitale Souveränität: Nuudle – ein nicht-trackendes Termintool

Screenshot: https://nuudel.digitalcourage.de//

Viele Menschen nutzen Doodle für die einfache Terminabstimmung. Im Sinne einer Digitalen Souveränität kann alternativ Nuudle genutzt werden. Wie die Abbildung zeigt, können über Termine hinaus auch noch klassische Umfragen erstellt werden.

Nuudle ist ein datensparsames Termintool und unterstützt daher Personen und Organisationen, die ihre Daten schützen möchten.

Das Tool ist auf der Website von digitalcourage zu finden, auf der es viele Hinweise dazu gibt, wie man seine eigenen Daten schützen kann. Manches finde ich gut, manches etwas überzogen – wie immer…

Siehe dazu auch Welche Open Source Alternativen gibt es?

Open Newswire: Professionelle Journalisten stellen Artikel frei zur Verfügung

Screenshot von der Startseite https://www.opennewswire.org/

In der heutigen Daten- und Informationsflut ist es gut zu wissen, welchen Informationen man trauen kann. Viele Quellen wollen manipulieren, aufhetzen, oder einfach nur Klicks generieren. In diesem Umfeld ist Vertrauen ein wichtiges Gut.

Professionelle Journalisten traut man zu, Inhalte zu sammeln, aufzuarbeiten und ohne Wertung an den Leser zu bringen. Wertungen können ja in separaten Kommentaren geschrieben werden. Solche Artikel stehen auf der Plattform Open Newswire „frei“ zur Verfügung.

Über die Plattform Open Newswire ist das in über 90 Sprachen möglich. Es handelt sich um ein Non Profit Projekt, das 2020 von einem australischen Journalisten gestartet wurde. Die Artikel unterliegen den hier gelisteten Creative Commons Licences.