Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

Komplexe Systeme: Ist die Antwort einfach mehr Daten?

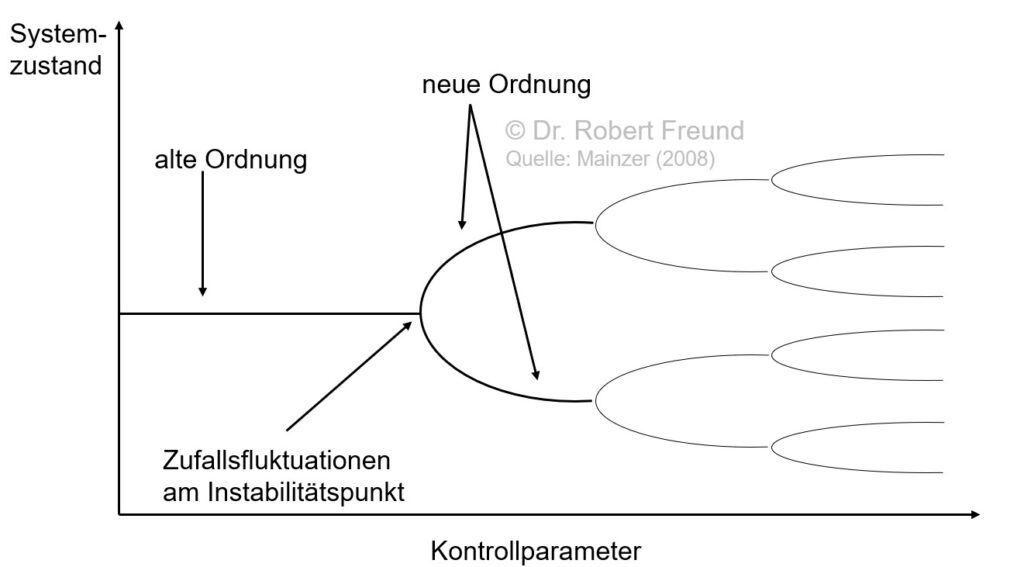
Eigene Darstellung nach Mainzer (2008)

Auf der Basis umfangreicher Geburts- und Sterbedaten berechnen Versicherungen seit dem 19. Jahrhundert die durchschnittliche Lebenserwartung von Menschen. Dabei wird eine Normalverteilung und das Gesetz der großen Zahl unterstellt. Die Verwendung von Normalverteilungen ist dabei nicht nur auf Versicherungen beschränkt. Ein weiteres Beispiel für die Nutzung der Normalverteilung ist die Berechnung des Intelligenz-Quotienten. In der Zwischenzeit gibt es deutliche Kritik an diesen Vorgehensweisen.

„Vom zentralen Grenzwertansatz und Normalverteilungen ging die klassische Sicht von Zufall und Wahrscheinlichkeit aus. Sie ist untypisch für komplexe Systeme, in denen sich Ordnungen und Strukturen selbst organisieren. Normalverteilungen setzen nämlich völlig unabhängige Ereignisse voraus. Daher können sie keine Korrelationen und Synergieeffekte von zusammenwirkenden Ereignissen berücksichtigen, die erst zu neuen Formen und Strukturen in Natur und Gesellschaft führen“ (Mainzer, 2008).

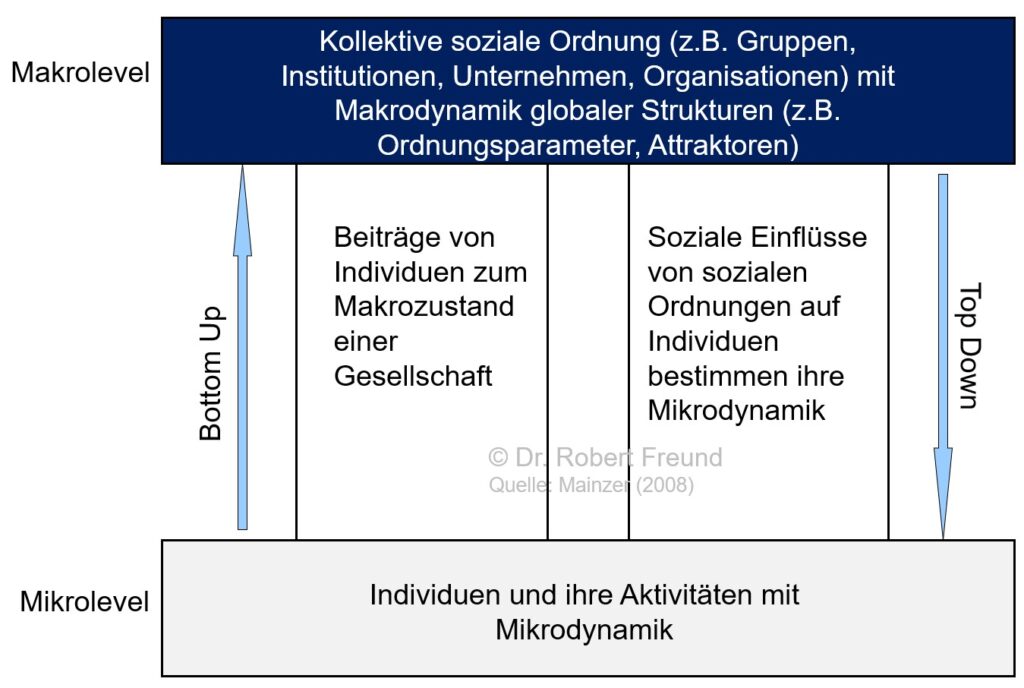
In der Abbildung (oben) wird plakativ dargestellt, dass durch zufällige Wechselwirkungen der Systemelemente einer Mikroebene zufällig neue Strukturen auf einer Makroebene entstehen, die nicht auf die einzelnen Systemelemente zurückzuführen sind (Emergenz). Siehe dazu auch Alle reden über Komplexität, doch wer kennt schon Bifurkationspunkte?

In der nächsten Abbildung ist die komplexe Situation in einer Gesellschaft zu erkennen, in der auf der Mikroebene Individuen interagieren und somit Bottom Up Einfluss auf die Makroebene nehmen. Die Makroebene wiederum hat Einfluss auf die Mikroebene (Top Down).

Eigene Darstellung nach Mainzer (2008)

Wir schauen als Bürger noch zu sehr auf die Makroebene (die da oben) und erwarten, dass das komplexe System für alle Beteiligten geregelt (gesteuert) wird. Besser wäre es, wenn mehr Raum für die Entwicklung der Mikroebene geschaffen wird (Ermöglichungsräume), um eine angemessene, selbstorganisierte Antwort auf die gesteigerte Komplexität in unserem Leben geben zu können.

Da das Denken in komplexen Zusammenhängen (komplexen Systemen) in unserer Gesellschaft leider wenig ausgeprägt ist, dominiert immer noch die falsche Annahme, dass alles regelbar und steuerbar sei. Man muss nur viele – ja sehr viele – Daten und Informationen sammeln. Künstliche Intelligenz suggeriert, dass dieser Zustand möglich sein kann – dem ist allerdings nicht so, wie es der Nobelpreisträger Simon schon in seiner eingeschränkten Rationalität erläuterte:

„Allerdings ergeben sich durch die Informationsbeschaffung selbst, Unsicherheit und Ungewissheit, da die Informationen über komplexe Systeme immer auch unvollständig sind, sodass eher von einer begrenzten oder auch eingeschränkten Rationalität auszugehen ist (vgl. Simon 1957/1982, Foss 2003)“ (Freund 2011:19).

Ein komplexes System kann zwar über geeignete Ordnungsparameter beeinflusst werden, doch ist dieser Ansatz oft nicht zu erkennen. Es müssen in einem komplexen System nicht alle Daten erfasst – was nicht möglich ist -, sondern die richtigen Ordnungsparameter gefunden werden. „Wir brauchen eben noch mehr Daten“ ist also eine Antwort, die nicht zu den heute anstehen Fragen passt.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in einem Paper ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Mein zweites Paper:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Macht es heute noch Sinn, den Begriff „Verbraucher“ zu verwenden?

Image by gonghuimin468 from Pixabay

Die verwendete Sprache, und hier speziell die verwendeten Begriffe, lassen oft Rückschlusse auf die dazugehörende Denkweise (Mindset) zu. Beispielsweise ist die Metapher „Unternehmen als Maschine“ oder „Menschen sind Zahnräder“ sinnbildlich für eine sehr mechanistische Denkweise, die heute in vielen Bereichen nicht mehr angemessen erscheint.

Der Begriff „Verbraucher“ hat eine ähnliche Wirkung. In vielen Meldungen, Statistiken usw. wird immer noch der Begriff verwendet, gerade so, als ob alle Produkte und Dienstleistungen verzehrt werden, also einer Abnutzung unterliegen.

„Verbrauch ist in der Wirtschaftstheorie der Verzehr von Gütern und Dienstleistungen zur direkten oder indirekten Bedürfnisbefriedigung. Ein Synonym für Verbrauch ist Konsum“ (Quelle: Wikipedia) Bei einem Acker ist das so, da hier die Fläche begrenzt, und nicht so einfach erweiterbar ist. Es leuchtet daher ein, dass versucht wird, das „maximale aus dem Boden herauszuholen“.

Bei digitalen Produkten ist das etwas anders. Auf das eben beschriebene Beispiel angewendet bedeutet das: „Der digitale Acker ist ein Zauberhut, aus dem sich ein Kaninchen nach dem anderen ziehen lässt, ohne dass er jemals leer würde. Die »Verbraucher« von Informationsgütern »verbrauchen« ja eben gerade nichts“ (Grassmuck 2004, Bundeszentrale für politische Bildung (bpb), 2., korrigierte Auflage).

In einer immer stärker digitalisierten Welt, werden digitale Produkte und Dienstleistungen durch deren Nutzung nicht „verbraucht“, sondern ganz im Gegenteil: Durch die Nutzung von Daten und Informationen entstehen wieder viele neue Daten, die dann oftmals von Unternehmen wertschöpfend genutzt werden. Daten sind für diese Unternehmen das neue Öl.

Im Zusammenhang mit digitalen Produkten (Daten, Informationen, Wissen) sollten wir daher nicht mehr von „Verbraucher“ sprechen, da der Begriff einfach nicht mehr passt.

Open Newswire: Professionelle Journalisten stellen Artikel frei zur Verfügung

Screenshot von der Startseite https://www.opennewswire.org/

In der heutigen Daten- und Informationsflut ist es gut zu wissen, welchen Informationen man trauen kann. Viele Quellen wollen manipulieren, aufhetzen, oder einfach nur Klicks generieren. In diesem Umfeld ist Vertrauen ein wichtiges Gut.

Professionelle Journalisten traut man zu, Inhalte zu sammeln, aufzuarbeiten und ohne Wertung an den Leser zu bringen. Wertungen können ja in separaten Kommentaren geschrieben werden. Solche Artikel stehen auf der Plattform Open Newswire „frei“ zur Verfügung.

Über die Plattform Open Newswire ist das in über 90 Sprachen möglich. Es handelt sich um ein Non Profit Projekt, das 2020 von einem australischen Journalisten gestartet wurde. Die Artikel unterliegen den hier gelisteten Creative Commons Licences.

Wissensmanagement: Schlüsselpersonen identifizieren

Wissen im Unternehmen ist in allen Prozessen einer Organisation relevant. Manchmal findet man Wissen in Form von Daten und Informationen in IT-Systemen, manchmal ist spezielles Wissen an Personen gebunden.

Solche Schlüsselpersonen werden immer wieder kontaktiert, doch gibt es oftmals keinen Überblick darüber, was solche Schlüsselpersonen ausmacht. In einer Veröffentlichung wurden nun Merkmalscluster für Schlüsselpersonen in Kleinen und mittleren Unternehmen (KMU) ermittelt, die in der genannten Quelle detaillierter dargestellt werden:

Exklusives Wissen
– Spezialisierte )Unternehmens-) Kenntnisse und Erfahrungen
– Mangelnde Bereitschaft/Möglichkeit Wissen zu teilen

Spezielle Kompetenzen
– Stark ausgeprägte soziale Kompetenzen.
– Stark ausgeprägte Fach-Kompetenzen

Vernetzung und Beziehung
– Interne fachübergreifende Beziehungen
– Starke Beziehung zu Geschäftspartner:innen

Mangelnde Ersetzbarkeit
– Mangelnde Vertretungsmöglichkeiten (intern)
– Mangelnde Ersetzungsmöglichkeiten (Arbeitsmarkt)

Kritische Auswirkungen bei Ausfall
– (Geschäfts-) Kritikalität der Arbeitsaufgabe
– (Geschäfts-) Kritikalität der Person

Quelle: Schiedermair, Ina, Kick, Elena, Baumgartner, Marco, Kopp, Tobias and Kinkel, Steffen. „Wissensmanagement in KMU: Kriterien zur Identifikation von internen Schlüsselpersonen“ Zeitschrift für wirtschaftlichen Fabrikbetrieb, vol. 118, no. 6, 2023, pp. 395-399. https://doi.org/10.1515/zwf-2023-1087

Siehe dazu auch Pyramiding für das Herausfinden von Experten nutzen .

Wissensmanagement: Datenbasierte Wissensnutzung in Projekten mit KI

Zeichen, Daten und Informationen sind stellen die Basis für jede Art von Wissen, der Wissensnutzung und der Wissenskonstruktion dar. Der Aufbau einer Wissensbasis während der Projektabwicklung hilft dabei das Projektmanagement zu verbessern, und das projektspezifische Wissen auch anderen Projekten zur Verfügung zu stellen. Gerade in Zeiten neuer Möglichkeiten wie der KI (Künstliche Intelligenz) ist das Projektmanagementwissen ein spannendes Thema. Doch worauf sollte dabei geachtet werden? Dazu habe ich folgendes gefunden:

„Wissensmanagement (WM): Die Wiederverwendung von Wissen, insbesondere Projektwissen, ist im PM essentiell. Angewandte Techniken sind vor allem Information Retrieval (IR), Natural Language Processings, und Ontologien als Wissensspeicher. Kenntnisse aus diesen Wissensgebieten sind notwendig, da sie a) aus PM-Sicht dafür sorgen, dass die richtigen Daten identifiziert werden, b) dass die Daten aus Data Analytics-Sicht richtig erfasst und untersucht werden und c), dass die Daten aus Sicht des Wissensmanagements in einer Wissensstruktur für die Nachnutzung sauber bereitgestellt werden“ (…) Die Verwendung von Ontologien als Speicher von Wissensobjekten und die integrierte Anwendung der Methode des Case-Based Reasoning eröffnet im genannten Kontext Potentiale für ein verbessertes Projektmanagement“ (Kusturica, W. Laroque, C. (2024) in Bernert et al. (2024): KI in der Projektwirtschaft).

Die Autoren haben diesen Ansatz in dem Beitrag anhand eines Fallbeispiels ausführlich dargestellt.

Solche Zusammenhänge thematisieren wir auch in dem von uns entwickelten Blended Learning Lehrgängen Projektmanager/in (IHK) und Projektmanager AGIL (IHK). Informationen dazu, und zu aktuellen Terminen, finden Sie auf unserer Lernplattform.

Aufbau einer Wissensbasis während der Projektabwicklung

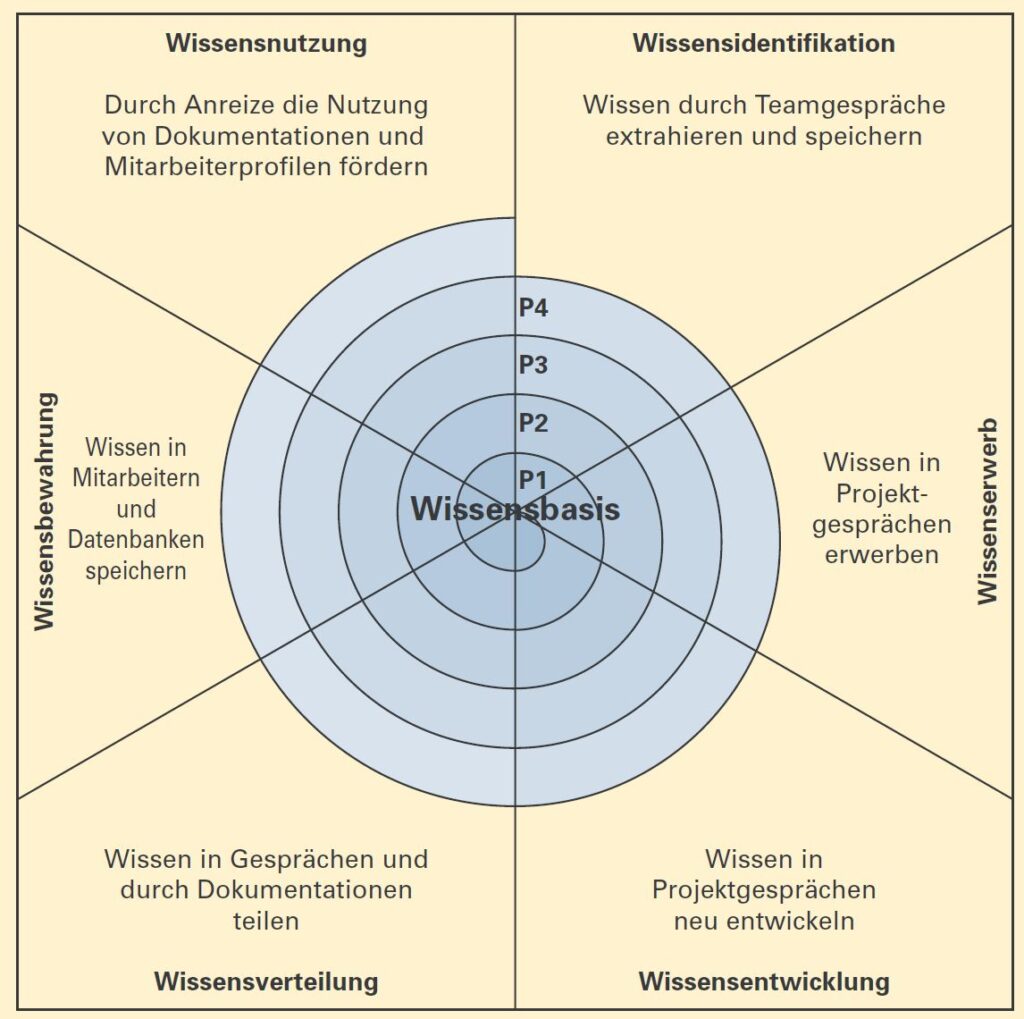
Spirale des Aufbaus einer Wissensbasis während der Projektabwicklung (Cüppers, C. (2007): Wissensmanagement in Projektorganisationen, projektmanagementaktuell 2/2007)

In Projekten werden viele Daten generiert und Informationen bearbeitet. Beides sind wichtige Bausteine einer Wissensbasis in projektorientierten Organisationen. Diese Wissensbasis baut sich zyklisch über die Projektabwicklung auf (Abbildung).

Die einzelnen Aktivitäten sind dabei die Wissensidentifikation, der Wissenserwerb, die Wissensentwicklung, die Wissensverteilung, die Wissensbewertung und die Wissensnutzung. Es ist deutlich zu erkennen, dass sich die Autorin an den Kernaktivitäten des Wissensmanagements orientiert hat (z.B. nach Probst et al.). Weiterhin zeigt die Abbildung, dass sich die jeweilige Wissensbasis über die Projekte P1 bis P4 immer weiter aufbaut.

„Ein Projekt beginnt zu einem definierten Zeitpunkt mit der Projektinitiierung. Es durchläuft verschiedene Phasen bis hin zum Projektabschluss bzw. zur Projektnachbereitung, in denen sich die in der Abbildung als Spirale dargestellte organisationale Wissensbasis stetig vergrößert. Jedes Projekt durchläuft die komplette Spirale unabhängig von den durchgeführten Projektphasen. Die Projektdauer kann von Projekt zu Projekt unterschiedlich sein, es werden jedoch immer alle Sektoren der Spirale durchlaufen. In den ersten drei Sektoren wird das für das Projekt erforderliche Wissen aus Bekanntem generiert, neu entwickelt und von außen erworben. In den folgenden drei Sektoren wird es dann selektiert, kommuniziert, dokumentiert, gespeichert und angewandt. Die Wissensbasis wächst kontinuierlich, sodass Folgeprojekte profitieren. Da in einem Unternehmen in der Regel mehrere Projekte gleichzeitig ablaufen und die Mitarbeiter zum Teil an mehreren Projekten arbeiten, ist der Übergang zwischen den einzelnen Projekten fließend“ (Cüppers 2007).

Siehe dazu auch Wissen und Erfahrungen als Input und Output von Projekten, Umgang mit Wissen in Projekten und Projektwissensmanagement – ein spannendes Thema.

Solche Zusammenhänge thematisieren wir auch in den von uns entwickelten Blended Learning Lehrgängen, die wir an verschiedenen Standorten anbieten. Informationen zu unseren Blended Learning Lehrgängen und zu aktuellen Terminen finden Sie auf unserer Lernplattform.

Ein neuer Wissensbegriff

Der Begriff „Wissen“ hat sich n der Vergangenheit immer wieder verändert, und wird dies auch in Zukunft tun. In dem Beitrag Vom Wissen als Besitz zum Wissen als Prozess wird diese Transformation deutlich. Zusammen mit den neuen Technologien, wie das WWW oder auch Künstliche Intelligenz, entsteht ein neuer Wissensbegriff.

„Wissen begründet sich in der gegenwärtigen Gesellschaft in dem Zusammenspiel vieler Wissensfragmente, die unter anderem im world wide web (www) technisch zusammengeführt werden und dort als gemeinsam verfügbares Wissen auftauchen, das durch Prozesse der Wissensbegründung in einer Erfahrungsgemeinschaft konstituiert wird. Dieser Wissensbegriff ist neu“ (vgl. Neusser 2013, zitiert in Arnold 2017:88).

Diese Entwicklung wirft zugleich Fragen zum Umgang mit diesem neuen Wissensbegriff auf. Welche Herausforderungen ergeben sich daraus für ein modernes Wissensmanagement?

Wissensarbeiter benötigen pro Woche fast einen ganzen Tag für die Informationssuche

Image by Firmbee from Pixabay

In einer aktuellen Studie von Researchscape im Auftrag von Lucid Software wurden 2.196 Wissensarbeiter aus den USA, aus UK, den Niederlanden, Deutschland und Australien befragt. Dabei kamen doch recht überraschende Ergebnisse heraus, die in der englischsprachigen Website von Lucid Software zu finden sind. ZDNET hat die wichtigsten Erkenntnisse in einem deutschsprachigen Artikel zusammengefasst.

„Demnach wenden deutsche Wissensarbeiter im Schnitt etwa 6,5 Stunden für die Suche nach Informationen auf, bevor sie mit der eigentlichen Arbeit beginnen können – was fast einem ganzen Arbeitstag pro Woche entspricht. Zudem erschwert eine schlechte Koordination im Team die produktive Arbeit“ (Quelle: ZDNET vom 01.06.2023).

Qualitativ gute Daten und Informationen sind für die Wissensarbeit elementar. Insofern ist es wichtig, diese Basis mit Hilfe digitaler Strukturen aufzubauen und die Koordination im Team zu verbessern. Technologisch kann das durch Kollaborationsplattformen geschehen, die auch eine stärkere Selbstorganisation unterstützen sollte. Kollaborationsplattformen unterscheiden sich dadurch auch von Software. Siehe dazu auch Von der Projektmanagement-Software zur Kollaborationsplattform.

Solche Zusammenhänge thematisieren wir auch in den von uns entwickelten Blended Learning Lehrgängen, die wir an verschiedenen Standorten anbieten. Weitere Informationen zu den Lehrgängen und zu Terminen finden Sie auf unserer Lernplattform.

Ein besseres Verständnis der Wissenstreppe führt zu einem besseren Umgang mit Wissen

Die einfache Wissenstreppe nach North unterscheidet Daten, Informationen und Wissen in einem Stufenmodell. Die erweiterte Wissenstreppe ergänzt diese Stufen noch mit Kompetenz, bei der diese Stufen von unten nach oben, und von oben nach unten „gegangen“ werden können. North und Maier (2018) erweiterten ihr Modell später zu einer Art Wissenstreppe 4.0, die sich an der Unterscheidung von Arbeit 1.0 bis 4.0 orientiert und eher ambidexter („beidhändig“) ist. Im angelsächsischen Raum wird die Wissenstreppe mit den Abkürzungen DIKW-Pyramide beschrieben (Data – Information – Knowledge – Wisdom).

Prof. Dr.-Ing Peter Heisig hat 2022 in einem Kommentar bei LinkedIn folgendes dazu erwähnt: „Well, I always suggest my students to read the paper by Ilkka Tuomi (1999) ´Data is more than knowledge: Implications of the Reversed Knowledge Hierarchy for Knowledge Management and Organizational Memory´ which provides a very good discussion of the D-I-K hierarchy suggesting a different approach. Also Martin Fricke points out logical errors if the DIKW hierarchy in his paper (2009) „The knowledge pyramid: a critique of the DIKW hierarchy“. Finally, for the German reading colleagues, Derboven, Dick & Wehner (1999) present a very interesting approach from a work psychology perspective. Would be useful to consider the research already undertaken in our domain (Heisig 2022).

Es kann durchaus Sinn machen, sich am Anfang mit Hilfe der Wissenstreppe in das Themenfeld einzulesen. Die erwähnten kritischen Anmerkungen führen dann zu einem immer besseren Verständnis des Konstrukts „Wissen“, was letztendlich auch zu einem besseren Umgang mit Wissen in den Organisationen führt (Wissensmanagement).