Künstliche Intelligenz: Gibt es eine Verantwortungslücke bei autonomen Systemen?

Image by Gerd Altmann from Pixabay

Immer häufiger gibt es Meldungen darüber, dass KI-Agenten Aktionen durchführen, die anderen Organisationen schaden könnten. Es scheint, dass die für KI-Agenten gesetzten Grenzen von den KI-Agenten selbst umgangen werden – immerhin ist es ja das Ziel von solchen autonomen Systemen, selbstgesteuert ein Ziel zu erreichen.

In solchen Fällen stellt sich zwangsläufig die Frage nach der Verantwortlichkeit. Den Begriff kann man aus drei Perspektiven betrachten, die miteinander in Verbindung stehen: Kausale Verantwortung, Moralische Verantwortung und Rollenverantwortung.

„The term “responsibility” can be interpreted in several ways. When we say “I am responsible,” we can mean more than one thing by it. In general, a distinction can be made between three meanings: causal responsibility, moral responsibility, and role responsibility. (…) These three types of responsibilities are related“
Lauwaert, L., Oimann, A.-K. (2025): Moral Responsibility and Autonomous Technologies. Does AI Face a Responsibility Gap?, in Smuha (Ed.) 2025).

Die genannten Autoren haben in einem Artikel dazu sehr viele Fragen aufgeworfen, von denen ich hier nur zwei wiedergeben möchte:

(1) Kann ein autonomes System für die gemachten Fehler moralisch verantwortlich sein?Ihre Antwort: „(…) the problem is that there is no one morally responsible for the errors caused by an autonomous system“.

(2) Kann in einem großen autonomen System jemand moralisch verantwortlich gemacht werden, wenn bei der Entwicklung und Ausführung so viele beteiligt sind? „The second problem that deviates from the responsibility gap is the problem of many hands“.

Es ist interessant, sich über die Verantwortung und Verantwortlichkeiten bei der Nutzung von autonomen KI-Systemen Gedanken zu machen. Dabei sollten nicht nur die Kausale Verantwortung und die Rollenverantwortung, sondern auch die Moralische Verantwortung berücksichtigt werden. Diese Dimension ist allerdings schwierig zu fassen. Daher kommen die Autoren bei der Moralischen Verantwortung zu folgendem Ergebnis:

„First, the use of autonomous AI does not necessarily involve a responsibility gap. Second, even if this were the case, we argued why that is not necessarily morally problematic“ (ebd.)..

Gefühlt nennt sich heute jeder in der Geschäftswelt KI-Experte

Image by Md Ishak Rahman from Pixabay

Es ist einfach nur interessant zu beobachten, wie sich die Muster ähneln. In den 90er Jahren waren es die Lean-Experten, dann die Experten für Agilität in den Organisationen und jetzt ist es eben das Attribut „KI-Experte“, das den Markt überschwemmt. Da sich jeder so nennen darf, wird es eben auch gemacht.

Ich stelle mir dabei oft die Frage, in welchen Teilgebieten des gesamten Feldes der Künstlichen Intelligenz will denn diese Person Experte sein, und was macht diese Person zu einem Experten?

Die eigene Zuschreibung reicht dafür nicht aus, denn richtige Experten werden von anderen dazu gemacht – es ist also eine Zuschreibung von anderen.

Experten werden von anderen gesucht und möglicherweise auch gefunden. Manche davon wissen gar nicht, dass sie in diesem Sinne Experten sind, geschweige denn nennen sie sich so.

Ein Beispiel für „richtige Experten“ kennen wir aus dem Bereich Innovationen – und hier speziell User Innovation. Diese Personen können durch ein spezielles Suchverfahren erkannt werden:

„Pyramiding search is a variant of snowballing – but with an important difference. Pyramiding requires that people having a strong interest in a given attribute or quality, for example a particular type of expertise, will tend to know of people who know more about and/or have more of that attribute than they themselves do (von Hippel et al 1999)“. zitiert von von Hippel/Franke/Prügl 2009).

Das Attribut „KI-Experte“ ist letztendlich das, was es ist: ein Marketingansatz. – nicht mehr und nicht weniger.

Lassen Sie andere darüber entscheiden, ob Sie ein KI-Experte sind.

Weitere Blogbeiträge zum Thema Expertise finden Sie hier.

Künstliche Intelligenz: Von der Antike über das Mittelalter bis zum Dartmouth College

Conceptual technology illustration of artificial intelligence. Abstract futuristic background

Wenn es um Künstliche Intelligenz geht wird fast immer davon geschrieben oder gesprochen, dass die Konferenz am Dartmouth College in den Jahren 1955 und 1956 (Konferenz) der Beginn dieser akademischen Disziplin war.

In dem Cambridge Handbuch Smuha, N. A. (Ed.) (2025): Cambridge Handbook of THE LAW, ETHICSAND POLICY OF ARTIFICIAL INTELLIGENCE weist die Autorin Nathalie A. Smuha zwar auch darauf hin, erweitert den Blick allerdings auch auf frühere Entwicklungen zum Thema.

Smuha zeigt auf, dass es schon in der griechischen Antike erste Überlegungen, zum Thema gab:

„First, it should be born in mind that the history of AI as a concept dates back at least to antiquity, where myths already existed about “automata” or self-operating machines displaying human behavior“ (ebd.).

Anschließend gibt es einen Hinweis auf die Entwicklungen im Mittelalter. Zu der Zeit lebte Ismail al Jazzi, der Vater der Robotik.

„The human drive to transgress the boundaries of the natural and the artificial and to create “intelligent” machines by no means diminished in the Middle Ages. For instance, in 1206, Ismail al-Jazari, an Arab polymath from Mesopotamia who is described as the “father of robotics,” wrote the Book of Knowledge of Ingenious Mechanical Devices, including detailed accounts of how to construct musical robot hands and drink-serving waitresses“ (ebda.).
Footnote: Shahino Mah Abdullah, “Intelligent robots and the question of their legal rights: an Islamic perspective (2018) ICR Journal, 9(3): 394–397.

Und zeitlich anschließend, natürlich der Verweis auf das Dartmouth College und der Konferenz in 1955:

„Artificial intelligence (AI) was founded as an academic discipline almost 70 years ago, when a conference took place at Dartmouth College“ (Smuha 2025).
Footnote: John McCarthy, Marvin Minsky, Nathaniel Rochester, and Claude Shannon, Proposal for the Dartmouth Summer Research Project on Artificial Intelligence, August 31, 1955 (ebd.).

Die Unterscheidung zwischen den Konzepten aus der Antike und dem Mittelalter und der nach Dartmouth entstandenen akademischen Disziplin ist sehr wertvoll. Zeigt sie doch, dass neue, umwälzende technologische Entwicklungen ihren Ursprung schon weitaus früher hatten, und zwar oft als erste Konzepte.

Künstliche Intelligenz als Konzept hat eine sehr lange Geschichte.

Diese Erkenntnis steht im Gegensatz zu der immer wieder – gerade von Big Tech – genannten Einmaligkeit von Künstlicher Intelligenz in der Geschichte der Menschheit.

Für eine Aufgabe das geeignete KI-Modell mit dem Smart Router in Langflow auswählen

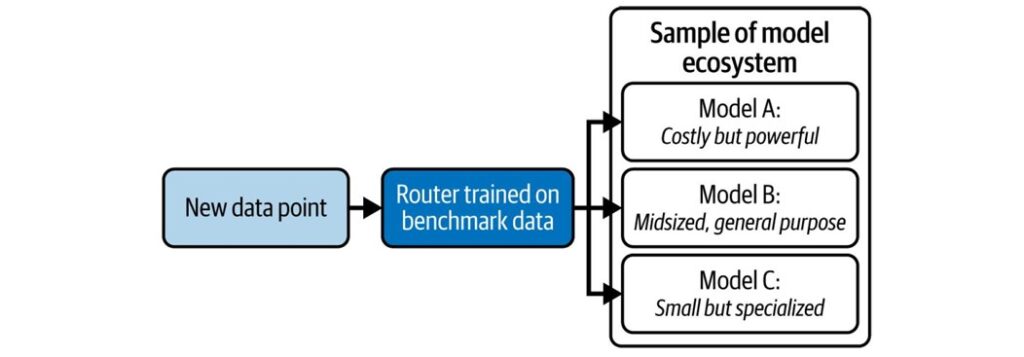
An AI router that understands the capabilities of models in its library directs
a given inference request to the best model able to perform the task at hand (Thomas et al. 2025)

Es ist in Organisationen nicht mehr zeitgemäß, alle anfallenden Aufgaben (Tasks) von einem sehr großen und Leistungsfähigen KI-Modell bearbeiten zu lassen. Dieses „One Size Fits All“ führt nur zu einem erhöhten Ressourcenverbrauch und damit zu hohen Kosten.

Besser ist es, für jede Anfrage das geeignete Modell auszuwählen. In dem Beitrag Künstliche Intelligenz: Mit einem AI Router verschiedene Modelle kombinieren hatte ich diese Vorgehensweise grob dargestellt. Die Abbildung zeigt das prinzipielle Vorgehen: Ein AI Router entscheidet auf Basis von Vorgaben, welches KI-Modell für den Task geeignet erscheint.

Da wir auf Open Source Software und Open Source AI setzen, ist es interessant, dass Langflow nun die Möglichkeit bietet, einen Smart Router zu nutzen. Basis ist dabei die schon vorhandene Wenn > Dann (If-Else) Funktion.

„The Smart Router component is an LLM-powered variation of the If-Else component. Instead of string matching, the Smart Router uses a connected Language Model component to categorize and route incoming messages“
Langflow. (o. D.). Quickstart. Langflow Documentation. Abgerufen am 16. Oktober 2026, von https://docs.langflow.org/get-started-quickstart)

Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

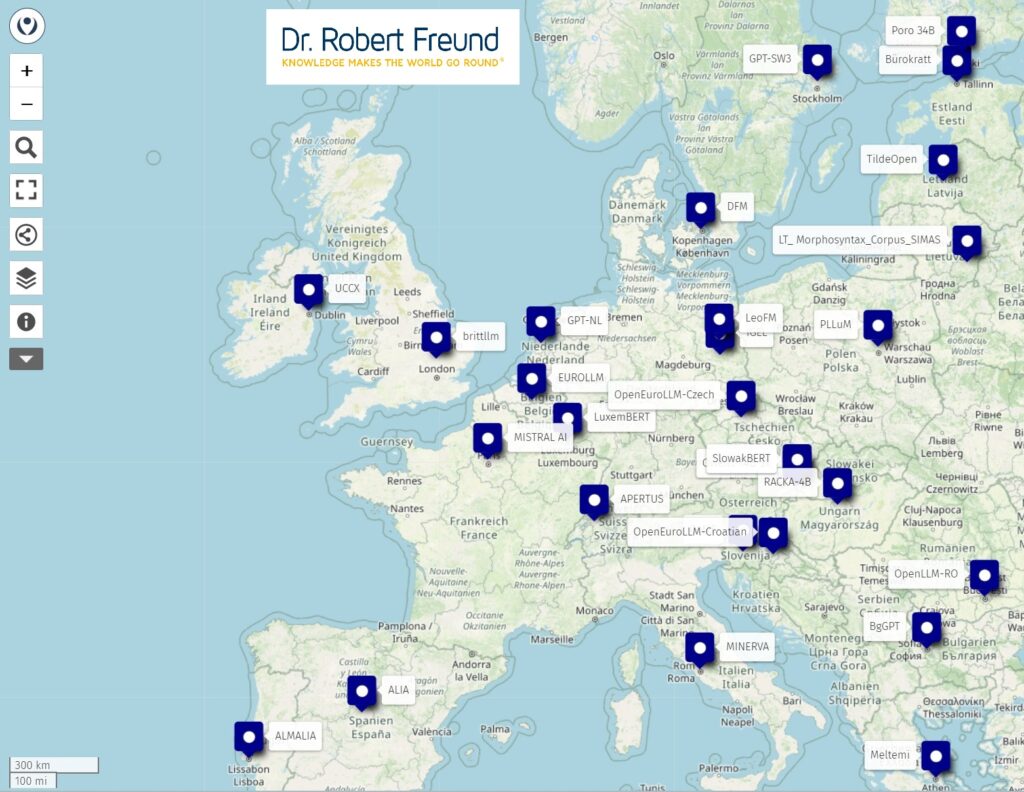
Fünf neue KI-Modelle aus Europa in unsere Open Street Map aufgenommen

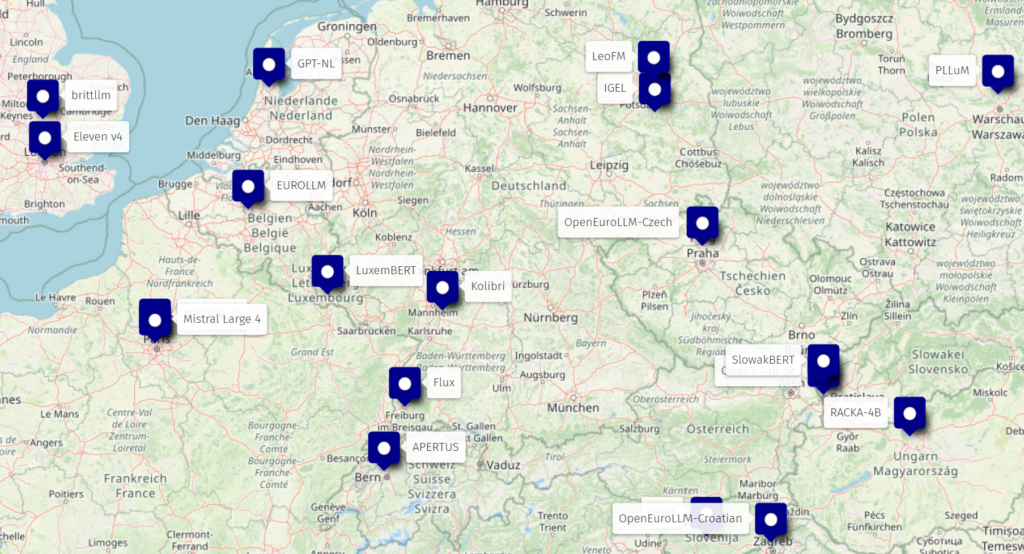
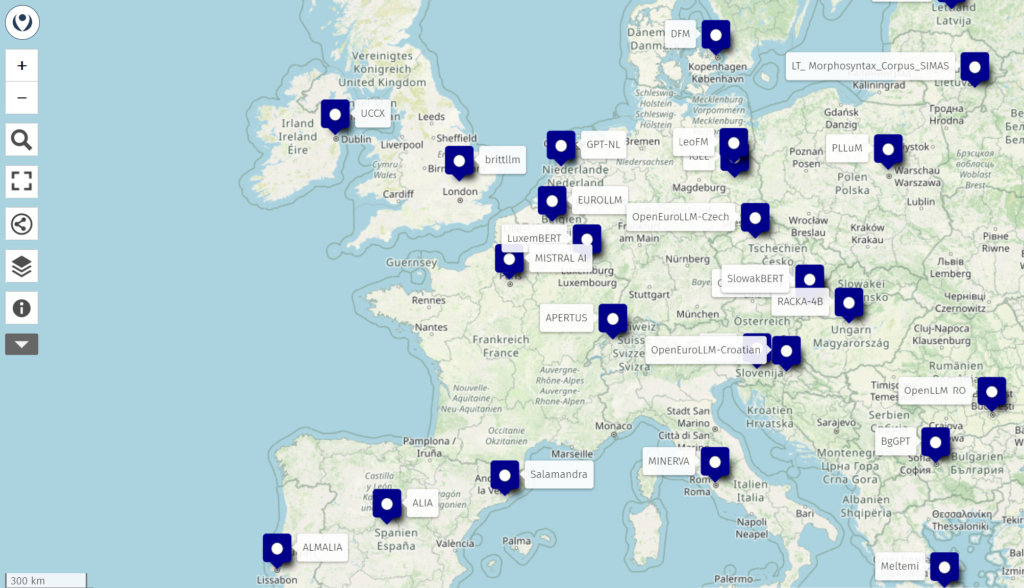
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Immer mehr KI-Modelle aus Europa kommen auf den Markt. Alleine vom 22. September bis 06.10.2026 wurden fünf neue Modelle veröffentlicht (KI-News von Thomas Ertl, 08.10.2026 auf LinkedIn).

In der folgenden Tabelle sind die Modelle, das Land und unter Bemerkungen, die Zugangsform (Open Source, Open Weight oder nur per API) angegeben. Die KI-Modelle sind direkt verlinkt.

KI-ModellLandBemerkung
KolibriAleph Alpha, Heidelberg, DeutschlandOpen Source
Flux 3 ActionBlack Forest Labs, Freiburg, DeutschlandOpen Weight
Flux 3 ImageBlack Forest Labs, Freiburg, DeutschlandAPI
Eleven v4ElevenLabs, London, UKAPI
Large 4Mistral, Paris, FrankreichOpen Weight
Europäische KI-Modelle, veröffentlicht im Zeitraum vom 22.09.-06.10.2026

Weiterhin haben wir diese Modelle in unsere Open Street Map mit aufgenommen, in der viele länderspezifische KI-Modelle zu finden sind. Die Map zeigt die dynamische Entwicklung in Europa, und den Trend zu mehr Digitaler Souveränität bei KI-Modellen.

Für die meisten Anwendungen ist es nicht erforderlich, das beste und größe Modell zu haben. Es geht vielmehr darum, ein KI-Modell zu nutzen, das vertrauenswürdig ist, in Europa gehostet wird und transparent zeigt, wie mit Daten umgegangen wird.

Ein gutes KI-System im Unternehmen schlägt dabei den Ansatz, alles im Unternehmen einem gigantischen KI-Modell wie Claude von Anthropic, Gemini von Google, ChatGPT von OpenAI etc. unterzuordnen. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz: Welcher Mensch?

Atari et al. (2023): Which Human? [PDF]

Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.

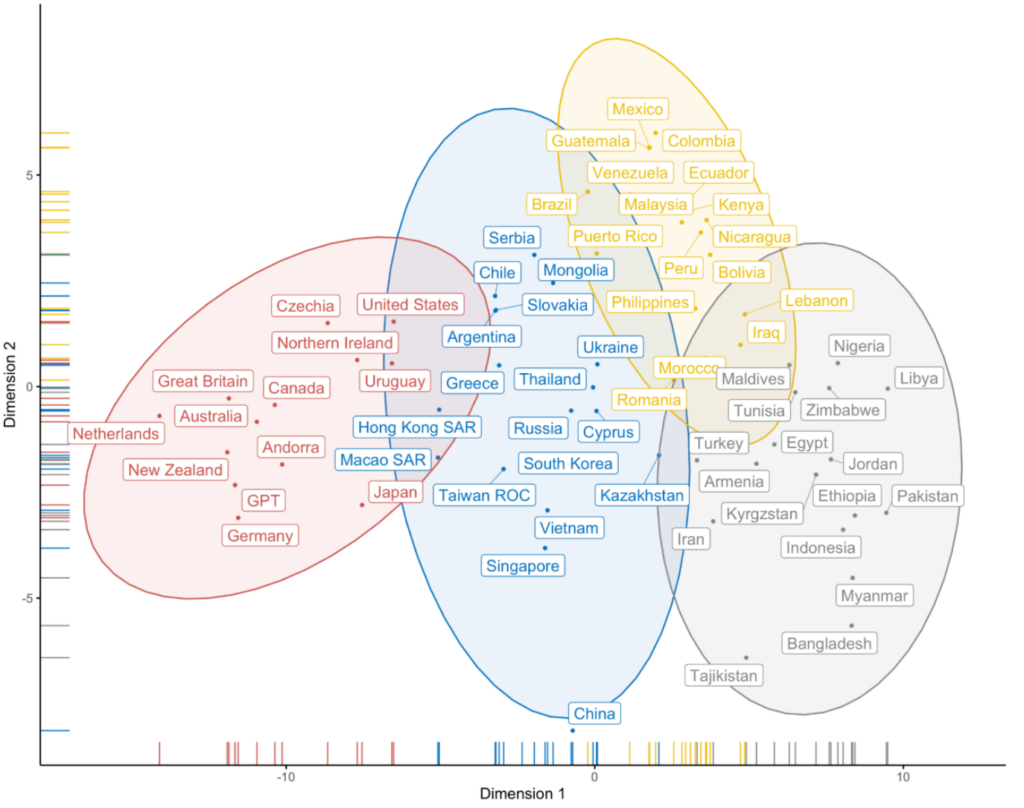
In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).

Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.

Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#5/46.052101/6.218511

Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

eTranslation: Das vertrauenswürdige Online-Übersetzungssystem der Europäischen Union

https://www.cor.europa.eu/en/etranslation

Wir haben uns in den letzten Jahren an die vielen Übersetzungsmöglichkeiten gewohnt, die die proprietären KI-Anbieter (Closed Models) anbieten. Es ist bequem, schnell und oft auch treffend in der jeweiligen Übersetzung.

Dennoch gibt es immer mehr Entwicklungen zu europäischen, nationalen oder sogar regionalen KI-Modellen, die die sprachlichen Besonderheiten und deren kulturellen Kontext besser berücksichtigen.

In einer Open Street Map habe ich viele dieser Modelle in einer Europa-Karte zusammengetragen und mit dem entsprechenden Links versehen.

Dieser Trend ist nicht alleine in Europa, sondern weltweit zu erkennen. Damit Übersetzungen in Europa vertrauenswürdig sind, hat die Europäische Union eTranslate zur Verfügung gestellt. Das System können schon sehr viele Organisationen, und auch Kleine und Mittlere Unternehmen (KMU) nutzen – Privatpersonen leider noch nicht.

„eTranslation is currently available to EU institutions, national public administrations, local and regional authorities, small and medium-sized enterprises, academia, non-governmental organisations, and Digital Europe Programme (DEP) projects, in the European Union and in countries affiliated with DEP. EPSO candidates can also use eTranslation during the recruitment process“ (eTranslation, 07.09.2026).

Ich halte das Angebot für einen wichtigen Schritt zu mehr Digitaler Souveränität in der Europäischen Union. Auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) gehe ich mit zwei Präsentationen auf solche Themen ein.

EU Score: KI-Modelle und Open Source Anwendungen aus europäischer Sicht bewerten

https://eu-score.tech/

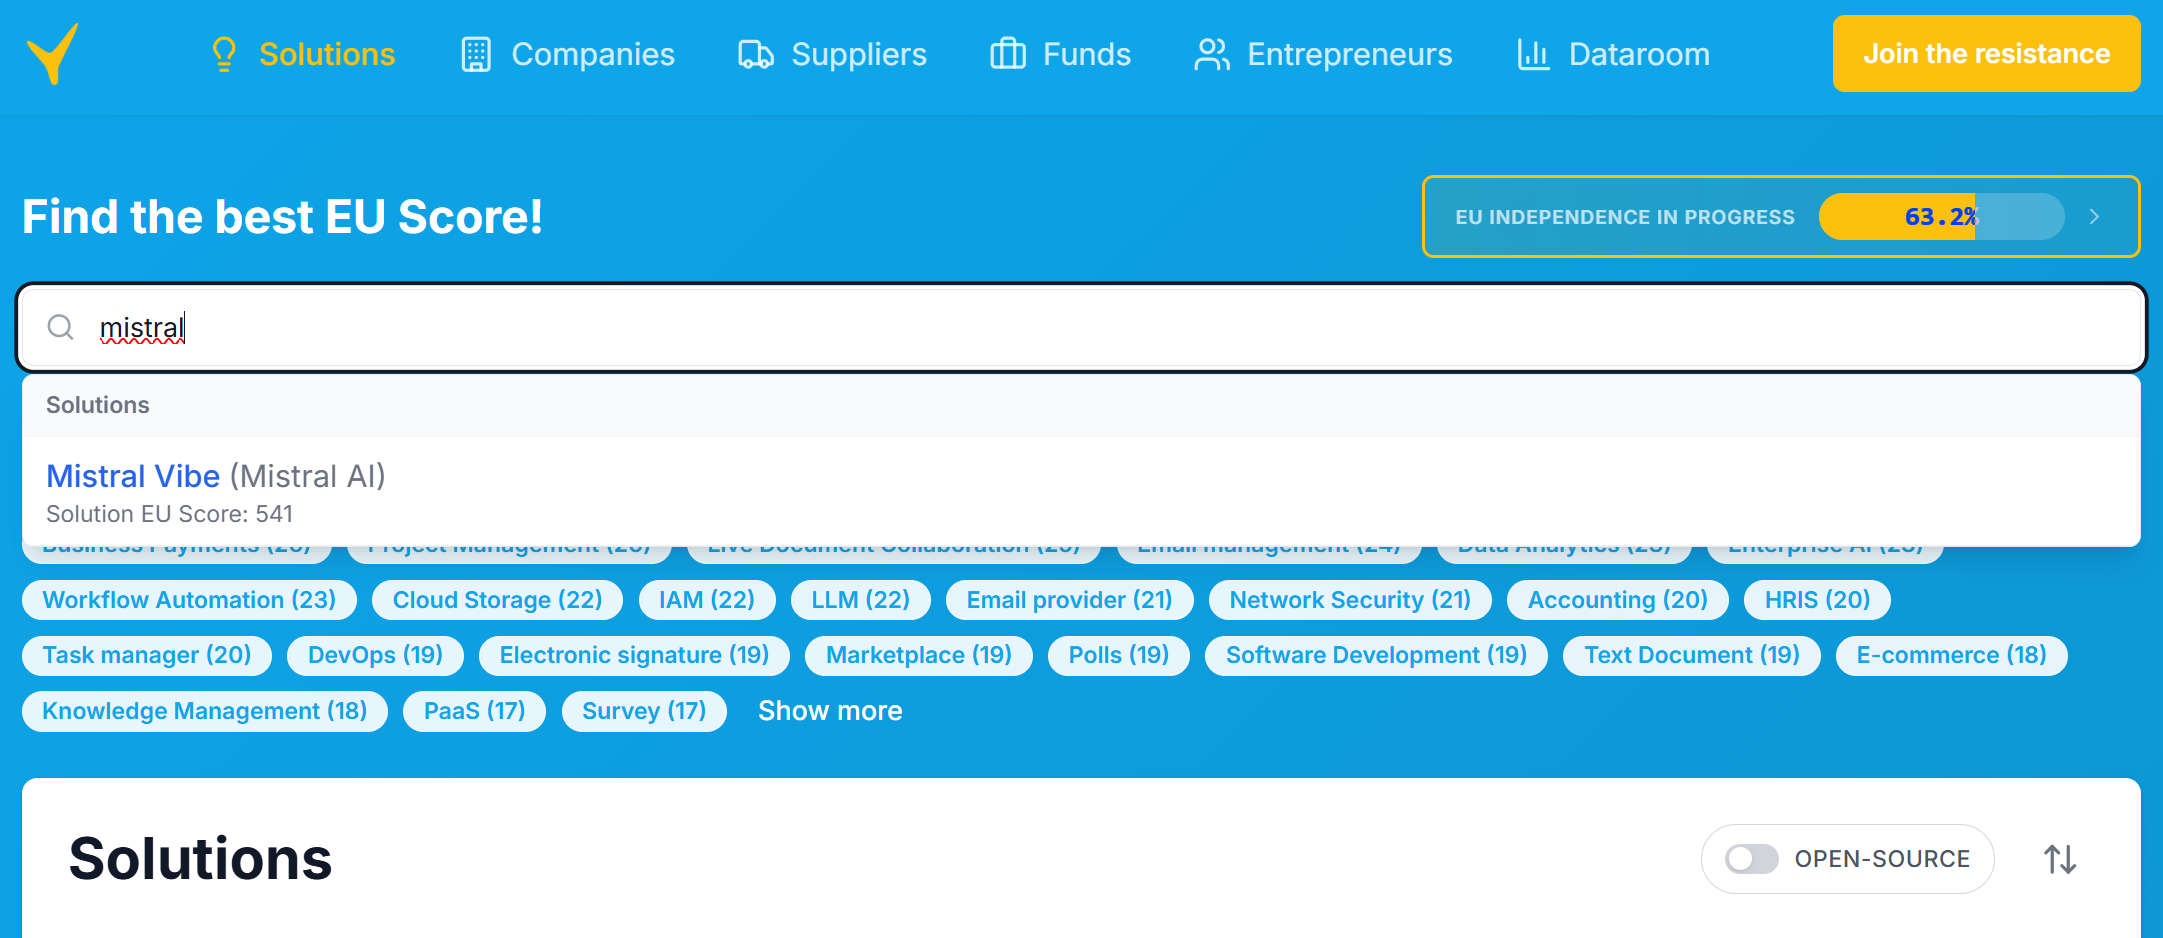
Es ist nicht ganz einfach, sich ein Bild von den ganzen KI-Möglichkeiten zu verschaffen. Es ist erforderlich, eine bestimmte Perspektive einzunehmen, um Bewertungen vorzunehmen. Die Plattform EU Score hat in 2025 damit angefangen, immer mehr Anwendungen aus dem Tech-Umfeld aus der Perspektive der Europäischen Union zu bewerten.

Die Dimensionen sind Population Sovereignty Equity Sovereignty, Supplier Sovereignty, Value Sovereignty und Webserver Sovereignty. Aus den einzelnen Zahlen wird dann ein Gesamtwert für die Souveränität der Europäischen Union ermittelt. In der Abbildung ist oben rechts ein gelb hinterlegter Wert von über 63,2% zu zu sehen.

Wenn ich in das Suchfeld „mistral“ eingebe (Abbildung), erscheint für Mistral Vibe (Mistral AI) der EU Score 541. Wenn ich in das Suchfeld „claude“ von Antropic eingebe, erhalte ich den EU Score 1. Das ist jetzt kein Schreibfehler! Die Unterschiede zwischen den beiden KI-Modellen sind aus europäischer Sicht frappierend. Ähnlich ist es auch bei dem Vergleich von Microsoft Office und Nextcloud usw.

Die Plattform ist eine interessanter Einstieg, um sich die großen Unterschiede zwischen den angebotenen Markt-Alternativen klar zu machen. In der Abbildung ist rechts unten weiterhin zu erkennen, dass man auch nur Open Source Anwendungen betrachten und analysieren kann.

Eine Paper zur Methode habe ich bisher allerdings nicht gefunden. Für Außenstehende wäre eine fundierte wissenschaftliche Begründung und Ableitung der verwendeten Methode klarer und transparenter, was wiederum mehr Vertrauen schaffen würde. It all starts with trust!

Dennoch halte ich die Plattform für ein geeignetes Instrument, für sich selbst, für Organisationen eine Diskussionsgrundlage für die eigene Digitale Souveränität zu schaffen.

IEEE P8000.1: Ein erster Standard zur Bestimmung der Vertrauenswürdigkeit von KI-Systemen

Image by Gerd Altmann from Pixabay

Wenn wir mit KI-Systemen (AI Systems) arbeiten, stellt sich immer wieder die Frage, ob man diesem oder jenem Modell vertrauen kann – immerhin geben viele Privatpersonen, oder auch Unternehmen den KI-Systemen auch persönliche, bzw. unternehmensspezifische Daten.

Was machen diese KI-Systeme mit unseren Daten?

Die allgemein bekannten und vielfach genutzten proprietäten KI-Systeme von OpenAI, Meta, Alphabet, X, Anthropic usw. sind bei dieser Frage wenig transparent. Solche geschlossenen Systeme (Closed Models) gehen davon aus, dass der Nutzer diesen Unternehmen einfach so vertraut.

Doch wenn wir uns so manche Äußerungen von den „Gesichtern der Unternehmen“ (Musk, Altman, Zuckerberg usw.) ansehen oder anhören wird deutlich, dass das möglicherweise hinter den KI-Systemen liegende Mindset nicht den eigenen Vorstellungen entspricht. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

Um auf das Vertrauen in KI-Systeme weiter eingehen zu können, müssen wir natürlich erst einmal klären, was unter Vertrauen zu verstehen ist. Hier zwei Beschreibungen mit ähnlicher Perspektive:

Vertrauen ist dabei ein Mechanismus, der es ermöglicht, auf einen Teil der Kontrolle zu verzichten, und der die Bereitschaft erhöht, ein Risiko einzugehen (Giddens 1995, 1997, Luhmann 2000).

Vertrauen als Fähigkeit, soziale Beziehungen in Situationen der Ungewissheit und Mehrdeutigkeit (temporär) zu stabilisieren (vgl. Weick, 1995).

In einer Metapher beschrieben Thomas et al. (2025) die Situation zwischen einem Nutzer und dem KI-System mit einem Glas, das eine undefinierbare trübe Flüssigkeit enthält. Würden Sie diese Flüssigkeit trinken? Wahrscheinlich eher nicht, da man ja nicht weiss, was für eine Flüssigkeit im Glas ist.

Ähnlichkeiten zu dieser Situation sehen die Forscher im Umgang mit Daten und der Nutzung von KI-Systemen (Closed Models) in den Unternehmen – immerhin sind Daten eine der wichtigsten Assets in einer Organisation.

Step 1: It All Starts with Trust
„Think about it: the glass is opaque, you can’t even see inside it! The water inside that glass could pure spring water, but it could also be cloudy and murky puddle water, or even contaminated water! If you couldn’t see inside that glass, would you still drink what’s inside it after adding tons of high-quality sugar and lemon to it? Probably not, so why would you do this with one of your company’s most previous assets—your data?“ (Thomas et al. 2025).

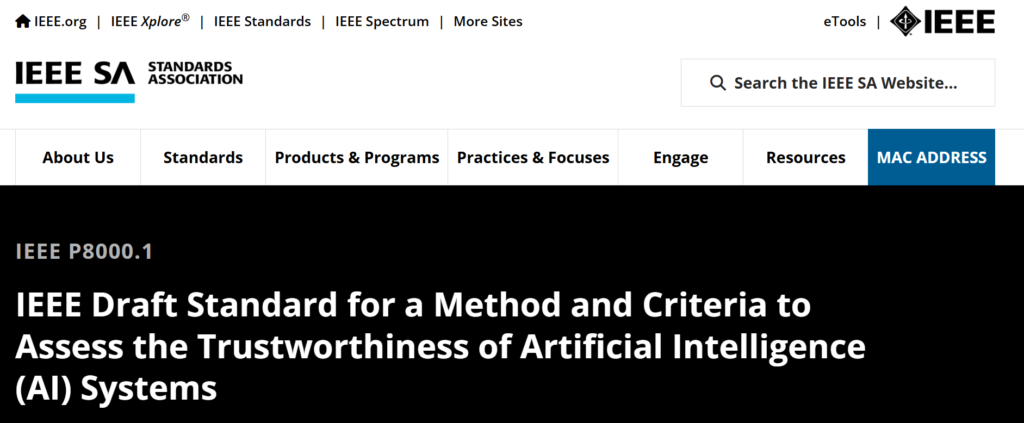
Diese Erkenntnisse führen zwangsläufig zu den Frage, wie man die Vertrauenswürdigkeit von KI-Systemen bestimmen kann, ohne den Marketingtexten der bekannten KI-Systemen glauben zu müssen? Es muss sich eine neutrale Institution mit der Frage befassen. Dazu gibt es auch schon Initiativen. Eine davon kommt von der IEEE (Institute of Electrical and Electronics Engineers), die in ihrer Standards Association (SA) einen ersten Entwurf entwickelt hat:

„IEEE P8000.1: IEEE Draft Standard for a Method and Criteria to Assess the Trustworthiness of Artificial Intelligence (AI) Systems“ (IEEE).

https://standards.ieee.org/ieee/8000.1/12593/

Ich bin gespannt, wie sich dieser internationale Standard weiterentwickelt und welche Kriterien zur Bestimmung der Vertrauenswürdigkeit von KI-Systemen am Ende herauskommen. Siehe dazu auch MISSION KI: Wie vertrauenswürdig sind KI-Modelle?

Wir sind der Meinung, dass es aktuell durchaus vertrauenswürdige KI-Systeme in Europa gibt. Vertrauen hängt sehr stark mit Transparenz zusammen. In der von uns erstellten Open Streep Map zu solchen Open Source KI-Systemen aus Europa können Sie sich ein Bild davon machen.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154