Künstliche Intelligenz ist untrennbar in die Gesellschaft eingebettet – oder umgekehrt?

Image by Gerd Altmann from Pixabay

Manchmal habe ich den Eindruck, es geht aktuell nur noch um Künstliche Intelligenz – in dem Sinne: Wir machen alles, damit es der Künstlichen Intelligenz gut geht. Wir geben unsere Daten einfach so her, damit sie in Trainingsdaten gesammelt werden können, und Big Tech daraus ein lukratives Geschäft machen kann. Wir sind damit einverstanden, dass Künstliche Intelligenz halluziniert, Fakes produziert und über Agenten Unternehmen angreift, ohne dafür programmiert zu sein. Die fehlenden Rahmenbedingungen sind durchaus im Sinne von Big Tech – egal welche gesellschaftlichen Konsequenzen das hat.

Berücksichtigt man allerdings, dass Künstliche Intelligenz untrennbar in die Gesellschaft eingebettet ist, so wirkt Künstliche Intelligenz auf die Gesellschaft je mehr die verschiedenen Möglichkeiten genutzt werden. Es gibt somit auch ein gewisses gesellschaftliches Zersetzungspotenzial, was aktuell Demokratien mit ihren freiheitlichen Ansätzen schwer zu schaffen macht.

Darüber hinaus wirkt natürlich auch die Gesellschaft mit ihrem Rechtssystem, dem sozialen System, seinen Werten, ethischen und moralischen Perspektiven usw. auf Künstliche Intelligenz. Das wird allerdings von Big Tech und den damit kooperierenden Strömungen massiv kritisiert – klar.

Die Vorstellung von Big Tech, das sich alle Gesellschaften und Kulturen einfach der Dominanz von Künstlicher Intelligenz anpassen (unterwerfen) sollen, ist allerdings nicht aufgegangen. Siehe dazu auch Bris, A. (2025): SuperEurope: The Unexpected Hero of the 21st Century.

Solche Erkenntnisse kommen spät, doch möglicherweise noch nicht zu spät. Beispielsweise sieht man es in der Entwicklung zu mehr europäischer (Digitaler) Souveränität, zu immer mehr europäischen Open Source AI Modellen oder lokal ausgeführten KI-Modellen oder auch zu Modellen, die die jeweilige Sprache besser abbilden (Siehe meinen Blogbeitrag zu agglutinierenden Sprachen).

Es sind viele kleine Aktivitäten, in allen gesellschaftlichen Bereichen, die Europa Schritt für Schritt unabhängiger machen. Das wird nach Jahrzehnten der Abhängigkeit nicht in ein paar Jahren klappen, doch ist die Tendenz eindeutig.

Das Primat der Gesellschaft über technologische Entwicklungen sollte wiederhergestellt werden – zum Wohle aller und nicht nur zum Wohle einiger.

Dazu habe ich einen passenden Text in einem Paper gefunden:

„Third, as already alluded to above, there is an important societal dimension that needs to be considered within any AI history, as it does not stand separate from its technological dimension. Like all technologies, AI is inherently embedded in society, thus affecting and being affected by the broader environment in which it is designed, developed, and deployed – for better and for worse. The societal impact of Artificial Intelligence is of course more noticeable the more it is being implemented and used in a diversity of domains, which also explains the relatively recent surge of (academic and other) interest in AI ethics, in parallel with the technology’s increased uptake. Yet AI’s uptake is also enabled and furthered by the societal condition. These enabling factors pertain, inter alia, to society’s belief in innovation as an almost absolute good, its technology-solutionist orientation, and its conception of “progress” as almost coinciding with technological advancement rather than also considering if and how these advancements translate into higher individual and societal welfare – for all. Yet if we shape technology and technology also shapes us, it is essential to ask how it can be ensured that this mutual shaping process takes place in a way that protects rather than undermines our legal, moral, and political
standards“ (Smuha 2025).

Künstliche Intelligenz: Gibt es eine Verantwortungslücke bei autonomen Systemen?

Image by Gerd Altmann from Pixabay

Immer häufiger gibt es Meldungen darüber, dass KI-Agenten Aktionen durchführen, die anderen Organisationen schaden könnten. Es scheint, dass die für KI-Agenten gesetzten Grenzen von den KI-Agenten selbst umgangen werden – immerhin ist es ja das Ziel von solchen autonomen Systemen, selbstgesteuert ein Ziel zu erreichen.

In solchen Fällen stellt sich zwangsläufig die Frage nach der Verantwortlichkeit. Den Begriff kann man aus drei Perspektiven betrachten, die miteinander in Verbindung stehen: Kausale Verantwortung, Moralische Verantwortung und Rollenverantwortung.

„The term “responsibility” can be interpreted in several ways. When we say “I am responsible,” we can mean more than one thing by it. In general, a distinction can be made between three meanings: causal responsibility, moral responsibility, and role responsibility. (…) These three types of responsibilities are related“
Lauwaert, L., Oimann, A.-K. (2025): Moral Responsibility and Autonomous Technologies. Does AI Face a Responsibility Gap?, in Smuha (Ed.) 2025).

Die genannten Autoren haben in einem Artikel dazu sehr viele Fragen aufgeworfen, von denen ich hier nur zwei wiedergeben möchte:

(1) Kann ein autonomes System für die gemachten Fehler moralisch verantwortlich sein?Ihre Antwort: „(…) the problem is that there is no one morally responsible for the errors caused by an autonomous system“.

(2) Kann in einem großen autonomen System jemand moralisch verantwortlich gemacht werden, wenn bei der Entwicklung und Ausführung so viele beteiligt sind? „The second problem that deviates from the responsibility gap is the problem of many hands“.

Es ist interessant, sich über die Verantwortung und Verantwortlichkeiten bei der Nutzung von autonomen KI-Systemen Gedanken zu machen. Dabei sollten nicht nur die Kausale Verantwortung und die Rollenverantwortung, sondern auch die Moralische Verantwortung berücksichtigt werden. Diese Dimension ist allerdings schwierig zu fassen. Daher kommen die Autoren bei der Moralischen Verantwortung zu folgendem Ergebnis:

„First, the use of autonomous AI does not necessarily involve a responsibility gap. Second, even if this were the case, we argued why that is not necessarily morally problematic“ (ebd.)..

Ist Künstliche Intelligenz magisch oder sogar mystisch?

Image by Michaela ? from Pixabay

In dem Blogbeitrag Künstliche Intelligenz: Von der Antike über das Mittelalter bis zum Dartmouth College habe ich aufgezeigt, dass es schon lange Konzepte zum Thema gibt und Künstliche Intelligenz erst seit 1956 eine akademische Disziplin wurde.

Diese Betrachtung rüttelt an der von Big Tech immer wieder verbreiteten Meinung, dass Künstliche Intelligenz in der Geschichte der Menschheit etwas Einmaliges, Unvergleichbares ist – für das es noch keine gesellschaftlichen Regeln gibt.

Dadurch, dass Big Tech ihre Modelle nicht transparent macht (Closed Source AI) umgibt sie eine Aura des Mystischen, des Magischen. Wenn sie die Modelle transparent machen würden, wie es Open Source AI Modelle vormachen, so würde man erkennen, dass da nichts dergleichen ist.

Die in den Jahrzehnten immer wieder genannte geheime Formel für die Herstellung von Coca Cola war auch so eine Vorgehensweise des Storytellings. Es ist und bleibt „nur“ geschicktes Marketing.

Auch lehrt uns die Geschichte, dass es den Menschen in ihren gesellschaftlichen Strukturen bisher immer gelungen ist, Regelungen zu finden, um neue Technologien zu nutzen, und gleichzeitig gesellschaftliche Auswirkungen zu dämpfen.

„The question is, hence, how to avoid the trap of treating AI as entirely novel, while at the same time being sufficiently mindful of the very concrete ways in which it can (adversely) affect society, and ensuring tailored governance mechanisms to counter potential harms“ (Smuha 2025).

Aktuell gibt es ein Ungleichgewicht in den Diskussionen, denn Big Tech dominiert die Debatte und möchte damit auch die gesellschaftlichen Strukturen wie gewünscht anpassen. In den USA sehen wir, wie das alles funktionieren soll.

In Europa haben wir die Chance, beide Extreme zu einem Kontinuum der Möglichkeiten für die sinnvolle gesellschaftliche Nutzung von Künstlicher Intelligenz zusammenzuführen. Es wundert nicht, dass Big Tech davon nicht begeistert ist. Doch immer mehr Menschen und Organisationen in Europa erkennen, dass eine Abhängigkeit von den Big Tech Denkmustern nicht unbedingt gut ist. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Gefühlt nennt sich heute jeder in der Geschäftswelt KI-Experte

Image by Md Ishak Rahman from Pixabay

Es ist einfach nur interessant zu beobachten, wie sich die Muster ähneln. In den 90er Jahren waren es die Lean-Experten, dann die Experten für Agilität in den Organisationen und jetzt ist es eben das Attribut „KI-Experte“, das den Markt überschwemmt. Da sich jeder so nennen darf, wird es eben auch gemacht.

Ich stelle mir dabei oft die Frage, in welchen Teilgebieten des gesamten Feldes der Künstlichen Intelligenz will denn diese Person Experte sein, und was macht diese Person zu einem Experten?

Die eigene Zuschreibung reicht dafür nicht aus, denn richtige Experten werden von anderen dazu gemacht – es ist also eine Zuschreibung von anderen.

Experten werden von anderen gesucht und möglicherweise auch gefunden. Manche davon wissen gar nicht, dass sie in diesem Sinne Experten sind, geschweige denn nennen sie sich so.

Ein Beispiel für „richtige Experten“ kennen wir aus dem Bereich Innovationen – und hier speziell User Innovation. Diese Personen können durch ein spezielles Suchverfahren erkannt werden:

„Pyramiding search is a variant of snowballing – but with an important difference. Pyramiding requires that people having a strong interest in a given attribute or quality, for example a particular type of expertise, will tend to know of people who know more about and/or have more of that attribute than they themselves do (von Hippel et al 1999)“. zitiert von von Hippel/Franke/Prügl 2009).

Das Attribut „KI-Experte“ ist letztendlich das, was es ist: ein Marketingansatz. – nicht mehr und nicht weniger.

Lassen Sie andere darüber entscheiden, ob Sie ein KI-Experte sind.

Weitere Blogbeiträge zum Thema Expertise finden Sie hier.

Personalisierung von Software: Kann bald jeder mit KI seine eigene Software erstellen? Warum eigentlich nicht?

Image by Pexels from Pixabay

Immer mehr User (Nutzer) entwickeln ihre eigenen Produkte, da die Unternehmen mit ihren begrenzten Ressourcen (fixed innovation space) und Renditeüberlegungen oftmals Ideen von Usern nicht umsetzen. In meinem Paper zur MCP 2026 habe ich das ausführlich hergeleitet und beschrieben:

Freund, R. (2026): Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework. Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 76-85 · 17. Sep. 2026

Die Konferenzreihe legt seit 2004 alle 2 Jahre den Fokus auf (Mass) Customization and Personalization. – siehe MCP-CE.org. Dabei ging es in der Vergangenheit meistens darum herauszufinden, wie Unternehmen mit neuen Technologien – und jetzt auch mit Künstlicher Intelligenz – (massenhaft) individuelle Produkte und Dienstleistungen anbieten können – zum Preis von Standardprodukten.

In meinem Paper habe ich den Ansatz Customization and Personalization aus der Perspektive eines Users dargestellt: Open User Innovation. An mehreren Beispielen konnte ich aufzeigen, wie es in den letzten Jahren einen Paradigmenwechsel gegeben hat. User sind heute immer mehr in der Lage, ihre Ideen selbst umzusetzen. Dabei helfen natürlich die niederschwelligen Technologien der Maker Bewegung und Künstliche Intelligenz, um die vielen Hürden im Prozess der persönlichen Fabrikation zu überwinden.

Über meine in dem Paper genannten Beispiele hinaus, wird nun auch deutlich, dass es in Zukunft auch möglich sein wird, seine eigene Software von Künstlicher Intelligenz „bauen“ zu lassen. Lange genug haben wir uns den etablierten Softwareanbieter angepasst, ja geradezu unterworfen.

Wenn über 97% der Codebasis von Software Open Source ist, sollte es möglich sein, aus diesen Bausteinen seine eigene Software zusammenzustellen. Künstliche Intelligenz kann hier bei den Schnittstellen und möglichen rechtlichen Fragen helfen.

„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).

Auch die aktuellen Entwicklungen beim Vibe Coding gehen in diese Richtung. Dabei wird mit Hilfe eines Prompts der Quellcode von Künstlicher Intelligenz generiert. Warum eigentlich nicht?

Ich bin gespannt, was es in diesem Bereich noch für überraschende neue Chancen für die „Herstellung“ eigener Produkte und Dienstleistungen geben wird. Ganz im Sinne einer Open User Innovation, die sich von den etablierten Unternehmensangeboten löst, und eigene Lösungen entwickelt und nutzt.

Es gibt durchaus immer mehr Forscher, die schon eine Veränderung in den ökonomischen Bereichen sehen: Von der Market Economy zur Self-organized Gift Economy.

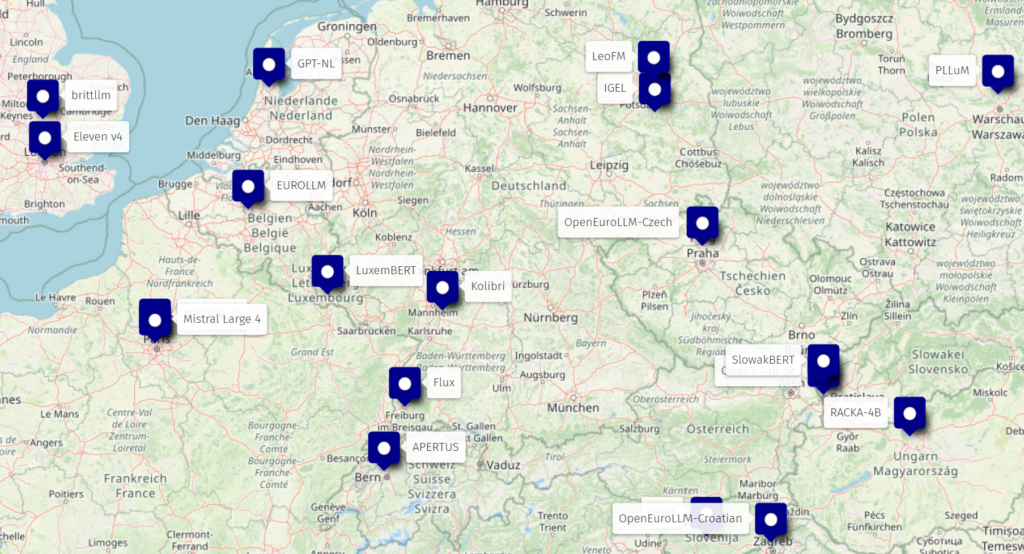
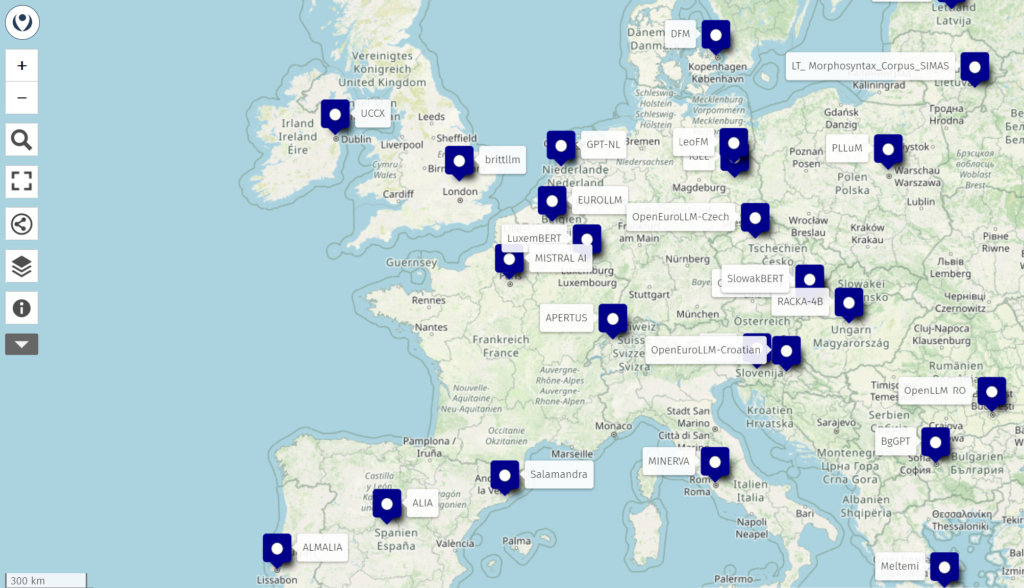
Fünf neue KI-Modelle aus Europa in unsere Open Street Map aufgenommen

Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Immer mehr KI-Modelle aus Europa kommen auf den Markt. Alleine vom 22. September bis 06.10.2026 wurden fünf neue Modelle veröffentlicht (KI-News von Thomas Ertl, 08.10.2026 auf LinkedIn).

In der folgenden Tabelle sind die Modelle, das Land und unter Bemerkungen, die Zugangsform (Open Source, Open Weight oder nur per API) angegeben. Die KI-Modelle sind direkt verlinkt.

KI-ModellLandBemerkung
KolibriAleph Alpha, Heidelberg, DeutschlandOpen Source
Flux 3 ActionBlack Forest Labs, Freiburg, DeutschlandOpen Weight
Flux 3 ImageBlack Forest Labs, Freiburg, DeutschlandAPI
Eleven v4ElevenLabs, London, UKAPI
Large 4Mistral, Paris, FrankreichOpen Weight
Europäische KI-Modelle, veröffentlicht im Zeitraum vom 22.09.-06.10.2026

Weiterhin haben wir diese Modelle in unsere Open Street Map mit aufgenommen, in der viele länderspezifische KI-Modelle zu finden sind. Die Map zeigt die dynamische Entwicklung in Europa, und den Trend zu mehr Digitaler Souveränität bei KI-Modellen.

Für die meisten Anwendungen ist es nicht erforderlich, das beste und größe Modell zu haben. Es geht vielmehr darum, ein KI-Modell zu nutzen, das vertrauenswürdig ist, in Europa gehostet wird und transparent zeigt, wie mit Daten umgegangen wird.

Ein gutes KI-System im Unternehmen schlägt dabei den Ansatz, alles im Unternehmen einem gigantischen KI-Modell wie Claude von Anthropic, Gemini von Google, ChatGPT von OpenAI etc. unterzuordnen. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz: Welcher Mensch?

Atari et al. (2023): Which Human? [PDF]

Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.

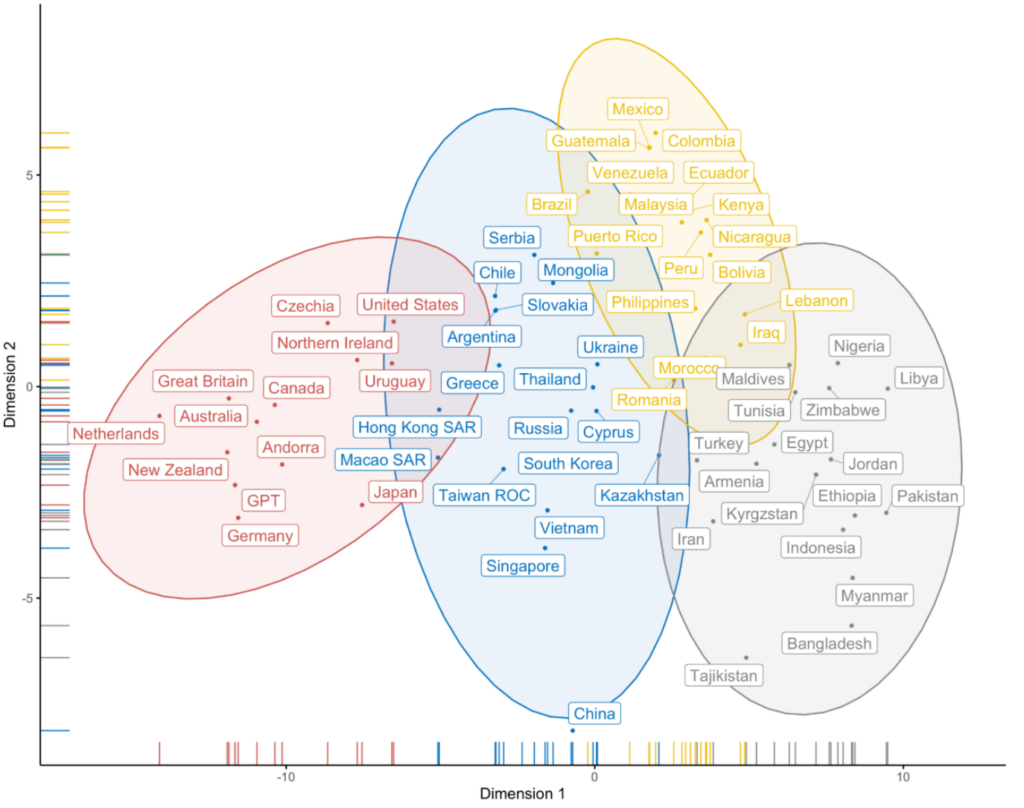
In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).

Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.

Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#5/46.052101/6.218511

Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

Künstliche Intelligenz, die Jagd nach AGI und der Intelligenz-Quotient

AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.

Es ist erstaunlich, wie viele parallelen es zwischen dem Intelligenz-Quotienten (IQ) und den Entwicklungen bei Künstlicher Intelligenz gibt. Die großen Tech-Unternehmen versprechen immer mehr, dass die von ihnen entwickelten Large Language Models (LLMs) generelle Problemlöser sind, oder bald sein werden – ganz im Sinne von „One Size Fits All“.

Mich erinnert die Diskussion um so eine generelle künstliche Intelligenz (AGI: Artificial General Intelligence) an den lange propagierten allgemeinen Faktor (g-faktor) bei der menschlichen Intelligenz. Die Messbarkeit der menschlichen generellen Intelligenz erfolgt dabei mit Hilfe des bekannten Intelligenz-Quotienten, der seit über 100 Jahren in vielen gesellschaftlichen Bereichen genutzt wird. Diese Vorgehensweise passte perfekt zu der aufkommenden Industriegesellschaft, in der alles – wirklich alles – messbar gemacht wurde, auch wenn es möglicherweise gar nicht messbar war. Dann wurde es eben messbar gemacht.

Die folgende Beschreibung von AGI der Stanford University enthält allerdings auch kritische Anmerkungen.

„AGI stands for Artificial General Intelligence, which means an AI system with general, human-level (or beyond) ability to learn, reason, and apply knowledge across a wide range of tasks and domains. AGI systems conceivably could handle novel situations, not just perform well on a single, narrow task. The term is controversial in several ways, including that different people mean different things by „human-level intelligence,“ and there’s no universally accepted test, so claims are hard to verify. There are also safety and ethical concerns debated by AI experts“ (Source: Stanford University).

Der Hinweis auf ein unterschiedliches Verständnis darüber, was unter human-Level intelligence zu verstehen ist, macht deutlich, dass sich das über 100 Jahre alte Verständnis von Intelligenz weiterentwickelt, und den Begriff entgrenzt hat. Hinweise auf eine Emotionale Intelligenz oder auch eine Soziale Intelligenz usw. zeigen, wie vielfältig Intelligenz heute interpretiert wird. Das ist auch erforderlich, da die heutige komplexe Welt mit den Kennzahlen der Industriegesellschaft nicht mehr komplett beschreibbar ist.

Die von Howard Gardner vorgestellte Multiple Intelligenzen Theorie hat demgegenüber als erste diese verschiedenen Dimensionen von Intelligenz zusammengefasst, wobei Howard Gardner von Intelligenz als bio-psychologisches Potential eines Menschen ausgeht. Diese Entgrenzung des Intelligenzbegriffs hat eine bessere Passung mit der heutigen komplexen Wissens- oder Kompetenzgesellschaft.

Der Begriff Künstliche Intelligenz ist danach eher als eine Art Kategorienfehler anzusehen. Es wundert daher nicht, dass manche vorschlagen, eher von Künstlicher Cleverness zu sprechen und zu schreiben. Auch die Konzentration von Intelligenz in einem Wert (IQ oder irgendwann AGI-Faktor) wird der heutigen Sichtweise nicht gerecht. Warum wird es trotzdem propagiert?

Bei den ganzen Begrifflichkeiten wird deutlich, dass es je nach Betrachter darum geht, die Welt auf einem einzigen (Intelligenz-) Souverän zurückzuführen (IQ oder AGI), oder die Welt als multidimensionales Konstrukt zu interpretieren. Ich tendiere eher zum zweiten Ansatz, und stehe den Heilsversprechen der Tech-Konzerne kritisch gegenüber.

eTranslation: Das vertrauenswürdige Online-Übersetzungssystem der Europäischen Union

https://www.cor.europa.eu/en/etranslation

Wir haben uns in den letzten Jahren an die vielen Übersetzungsmöglichkeiten gewohnt, die die proprietären KI-Anbieter (Closed Models) anbieten. Es ist bequem, schnell und oft auch treffend in der jeweiligen Übersetzung.

Dennoch gibt es immer mehr Entwicklungen zu europäischen, nationalen oder sogar regionalen KI-Modellen, die die sprachlichen Besonderheiten und deren kulturellen Kontext besser berücksichtigen.

In einer Open Street Map habe ich viele dieser Modelle in einer Europa-Karte zusammengetragen und mit dem entsprechenden Links versehen.

Dieser Trend ist nicht alleine in Europa, sondern weltweit zu erkennen. Damit Übersetzungen in Europa vertrauenswürdig sind, hat die Europäische Union eTranslate zur Verfügung gestellt. Das System können schon sehr viele Organisationen, und auch Kleine und Mittlere Unternehmen (KMU) nutzen – Privatpersonen leider noch nicht.

„eTranslation is currently available to EU institutions, national public administrations, local and regional authorities, small and medium-sized enterprises, academia, non-governmental organisations, and Digital Europe Programme (DEP) projects, in the European Union and in countries affiliated with DEP. EPSO candidates can also use eTranslation during the recruitment process“ (eTranslation, 07.09.2026).

Ich halte das Angebot für einen wichtigen Schritt zu mehr Digitaler Souveränität in der Europäischen Union. Auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) gehe ich mit zwei Präsentationen auf solche Themen ein.

Circular Economy, Giordano Bruno´s „alles kreist“ und Selbstorganisation

Image by Arek Socha from Pixabay

Die heutige Kreislaufwirtschaft (Circular Economy) scheint ein modernes, ressourcenschonendes Konzept zu sein, dass sich in den 1960er Jahren bis heute weit verbreitet hat.

Der Kreislauf-Gedanke ist allerdings schon viel früher entstanden. Giordano Bruno hat beispielsweise mit seinem „alles kreist“ – Gedanken schon im 16. Jahrhundert an einem Baum-Beispiel verdeutlicht, wie sich alles wie bei einem Kreis immer wieder schließt und wieder beginnt.

Giordano Bruno: Werke, Bd. 3: De la causa, principio, et uno. Über die Ursache, das Prinzip und das Eine (1584), italienisch-deutsch, übersetzt, kommentiert und herausgegeben von Thomas Leinkauf, Hamburg: Felix Meiner 2007, S. 111.

Den Hinweis habe ich in dem Beitrag von Marie-Louise Heuser gefunden: Heuser, M.-L. (2026): Autopoiese und Synergetik. Konzepte der Selbstorganisation. In: Petzer, T.; Steiner, S. (Hrsg.) (2016): Synergie. Kultur- und Wissenschaftsgeschichte einer Denkfigur.

Interessant dabei ist weiterhin, dass die Autorin eine Linie zur modernen Selbstorganisation aufzeigt: „Wie an diesem Zitat ersichtlich wird, denkt Bruno die Selbstgestaltung des Baumes als eine zirkuläre Selbstorganisation“ (ebd.).

Es ist manchmal erstaunlich, dass sich vor Jahrhunderten entstandene Gedanken in heutigen scheinbar modernen Management-Konzepten wiederfinden. Es lohnt sich, solche Trends zu hinterfragen. Manchmal sind es einfach nur Marketing-Trends mit einem entsprechenden Storytelling.

Das soll natürlich nicht bedeuten, dass die oben angesprochene Circular Economy (Kreislaufwirtschaft) unwichtig ist – im Gegenteil. Es geht mir darum, den Bezug zu schon vorhandenen Gedanken immer wieder einmal aktiv zu suchen und auch bewusst herzustellen – am besten natürlich mit Quellenangaben.