Künstliche Intelligenz ist untrennbar in die Gesellschaft eingebettet – oder umgekehrt?

Image by Gerd Altmann from Pixabay

Manchmal habe ich den Eindruck, es geht aktuell nur noch um Künstliche Intelligenz – in dem Sinne: Wir machen alles, damit es der Künstlichen Intelligenz gut geht. Wir geben unsere Daten einfach so her, damit sie in Trainingsdaten gesammelt werden können, und Big Tech daraus ein lukratives Geschäft machen kann. Wir sind damit einverstanden, dass Künstliche Intelligenz halluziniert, Fakes produziert und über Agenten Unternehmen angreift, ohne dafür programmiert zu sein. Die fehlenden Rahmenbedingungen sind durchaus im Sinne von Big Tech – egal welche gesellschaftlichen Konsequenzen das hat.

Berücksichtigt man allerdings, dass Künstliche Intelligenz untrennbar in die Gesellschaft eingebettet ist, so wirkt Künstliche Intelligenz auf die Gesellschaft je mehr die verschiedenen Möglichkeiten genutzt werden. Es gibt somit auch ein gewisses gesellschaftliches Zersetzungspotenzial, was aktuell Demokratien mit ihren freiheitlichen Ansätzen schwer zu schaffen macht.

Darüber hinaus wirkt natürlich auch die Gesellschaft mit ihrem Rechtssystem, dem sozialen System, seinen Werten, ethischen und moralischen Perspektiven usw. auf Künstliche Intelligenz. Das wird allerdings von Big Tech und den damit kooperierenden Strömungen massiv kritisiert – klar.

Die Vorstellung von Big Tech, das sich alle Gesellschaften und Kulturen einfach der Dominanz von Künstlicher Intelligenz anpassen (unterwerfen) sollen, ist allerdings nicht aufgegangen. Siehe dazu auch Bris, A. (2025): SuperEurope: The Unexpected Hero of the 21st Century.

Solche Erkenntnisse kommen spät, doch möglicherweise noch nicht zu spät. Beispielsweise sieht man es in der Entwicklung zu mehr europäischer (Digitaler) Souveränität, zu immer mehr europäischen Open Source AI Modellen oder lokal ausgeführten KI-Modellen oder auch zu Modellen, die die jeweilige Sprache besser abbilden (Siehe meinen Blogbeitrag zu agglutinierenden Sprachen).

Es sind viele kleine Aktivitäten, in allen gesellschaftlichen Bereichen, die Europa Schritt für Schritt unabhängiger machen. Das wird nach Jahrzehnten der Abhängigkeit nicht in ein paar Jahren klappen, doch ist die Tendenz eindeutig.

Das Primat der Gesellschaft über technologische Entwicklungen sollte wiederhergestellt werden – zum Wohle aller und nicht nur zum Wohle einiger.

Dazu habe ich einen passenden Text in einem Paper gefunden:

„Third, as already alluded to above, there is an important societal dimension that needs to be considered within any AI history, as it does not stand separate from its technological dimension. Like all technologies, AI is inherently embedded in society, thus affecting and being affected by the broader environment in which it is designed, developed, and deployed – for better and for worse. The societal impact of Artificial Intelligence is of course more noticeable the more it is being implemented and used in a diversity of domains, which also explains the relatively recent surge of (academic and other) interest in AI ethics, in parallel with the technology’s increased uptake. Yet AI’s uptake is also enabled and furthered by the societal condition. These enabling factors pertain, inter alia, to society’s belief in innovation as an almost absolute good, its technology-solutionist orientation, and its conception of “progress” as almost coinciding with technological advancement rather than also considering if and how these advancements translate into higher individual and societal welfare – for all. Yet if we shape technology and technology also shapes us, it is essential to ask how it can be ensured that this mutual shaping process takes place in a way that protects rather than undermines our legal, moral, and political
standards“ (Smuha 2025).

Ist Künstliche Intelligenz magisch oder sogar mystisch?

Image by Michaela ? from Pixabay

In dem Blogbeitrag Künstliche Intelligenz: Von der Antike über das Mittelalter bis zum Dartmouth College habe ich aufgezeigt, dass es schon lange Konzepte zum Thema gibt und Künstliche Intelligenz erst seit 1956 eine akademische Disziplin wurde.

Diese Betrachtung rüttelt an der von Big Tech immer wieder verbreiteten Meinung, dass Künstliche Intelligenz in der Geschichte der Menschheit etwas Einmaliges, Unvergleichbares ist – für das es noch keine gesellschaftlichen Regeln gibt.

Dadurch, dass Big Tech ihre Modelle nicht transparent macht (Closed Source AI) umgibt sie eine Aura des Mystischen, des Magischen. Wenn sie die Modelle transparent machen würden, wie es Open Source AI Modelle vormachen, so würde man erkennen, dass da nichts dergleichen ist.

Die in den Jahrzehnten immer wieder genannte geheime Formel für die Herstellung von Coca Cola war auch so eine Vorgehensweise des Storytellings. Es ist und bleibt „nur“ geschicktes Marketing.

Auch lehrt uns die Geschichte, dass es den Menschen in ihren gesellschaftlichen Strukturen bisher immer gelungen ist, Regelungen zu finden, um neue Technologien zu nutzen, und gleichzeitig gesellschaftliche Auswirkungen zu dämpfen.

„The question is, hence, how to avoid the trap of treating AI as entirely novel, while at the same time being sufficiently mindful of the very concrete ways in which it can (adversely) affect society, and ensuring tailored governance mechanisms to counter potential harms“ (Smuha 2025).

Aktuell gibt es ein Ungleichgewicht in den Diskussionen, denn Big Tech dominiert die Debatte und möchte damit auch die gesellschaftlichen Strukturen wie gewünscht anpassen. In den USA sehen wir, wie das alles funktionieren soll.

In Europa haben wir die Chance, beide Extreme zu einem Kontinuum der Möglichkeiten für die sinnvolle gesellschaftliche Nutzung von Künstlicher Intelligenz zusammenzuführen. Es wundert nicht, dass Big Tech davon nicht begeistert ist. Doch immer mehr Menschen und Organisationen in Europa erkennen, dass eine Abhängigkeit von den Big Tech Denkmustern nicht unbedingt gut ist. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz: Welcher Mensch?

Atari et al. (2023): Which Human? [PDF]

Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.

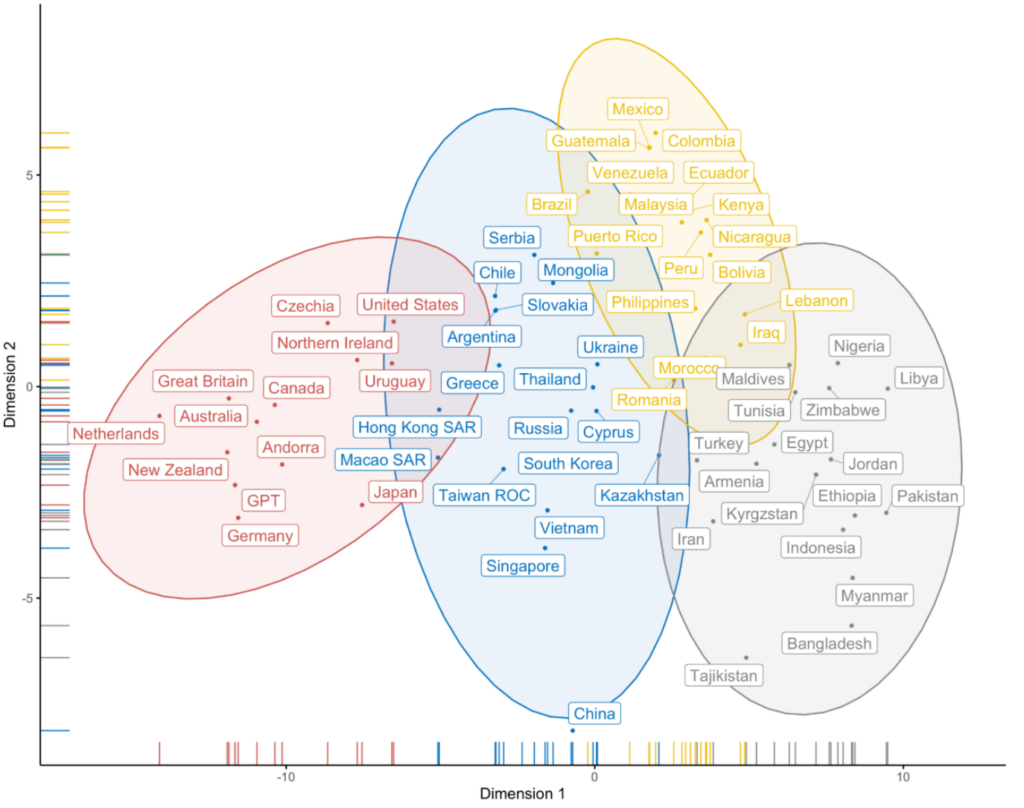
In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).

Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.

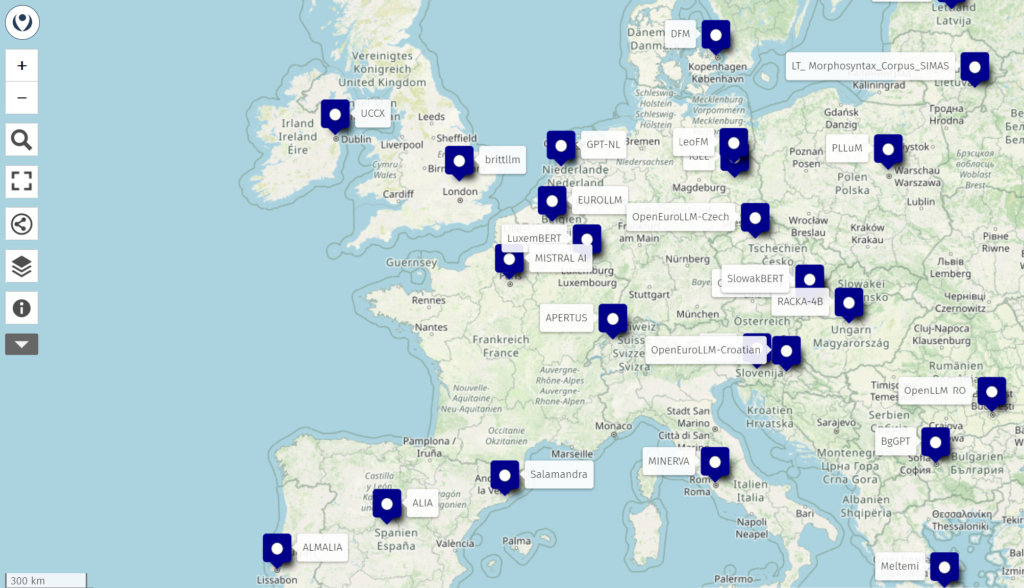
Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#5/46.052101/6.218511

Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

Digitale Abhängigkeit in den Verwaltungen von Bund und Ländern: Warum eigentlich?

Image by Robin Higgins from Pixabay

Es ist unstrittig, dass die Verwaltungen in Bund und Ländern modernisiert, und damit auch digitalisiert werden müssen. Dabei haben deutsche Verwaltungen in der Vergangenheit gerne Software amerikanischer Tech-Konzerne genutzt.

„Die deutsche Verwaltung ist in hohem Maße abhängig von proprietären, US amerikanischen IT-Lösungen. 96% der Verwaltungsangestellten arbeiten täglich mit Microsoft-Produkten. 80% der Verwaltungsdaten werden in Datenbanken des US-Anbieters Oracle gespeichert und 75% der Virtualisierungslösungen kommen von VMWare“ (ZenDis 02/2025: Digitale Souveränität als Staatsaufgabe).

Die Abhängigkeiten sind für den deutschen Steuerzahlen teuer: „Laufende Rahmenverträge mit großen IT-Firmen wie Microsoft und Oracle belaufen sich auf 13,6 Milliarden Euro“ (Netzpolitik.org vom 04.12.2024). Je abhängiger die Verwaltungen hier sind, um so rigoroser können (und werden) Preissteigerungen durchgesetzt – zur Gewinnsteigerung bei den Tech-Konzernen und zum Nachteil der Gesellschaft.

Weiterhin wird deutlich, dass die Trump-Administration einen starken Einfluss auf die amerikanischen Tech-Konzerne hat – ganz im Sinne von „America first“. Was mit den europäischen oder deutschen Befindlichkeiten und Interessen ist, ist nicht wirklich relevant. Das ist aus der Sicht amerikanischer Konzerne und amerikanischer Administrationen verständlich, sollte uns in Europa allerdings nachdenklich stimmen -gerade auch wenn es um den nächsten Schritt geht: Dem Einsatz von Künstlicher Intelligenz.

Da es seit vielen Jahren schon verstärkt Hinweise dazu gibt, dass ohne Open Source keine moderne und souveräne Digitalisierung in Deutschland erreichbar ist, muss man sich als Bürger wundern, dass sich die Politik von den amerikanischen Tech-Konzernen immer weiter abhängig macht. Das ganze Ausmaß dieser Fehlentwicklung wird in dem folgenden Artikel zusammengefasst:

Mischler, G. (2025): Open Source hat im Bund keine Lobby, golem vom 04.07.2025.

Auch Unternehmen, NGOs und Privatpersonen sollten sich die Frage stellen, ob sie nicht die verfügbaren Open-Source-Alternativen für ihre eigene digitale Souveränität nutzen sollten.

Wir haben schon vor mehreren Jahren mit diesen Schritten angefangen. Wir nutzen NEXCLOUD statt Microsoft Cloud, OpenProject statt MS Project, NEXCLOUD TALK statt Teams, Nextcloud Office statt Microsoft Office, etc. Darüber hinaus verwenden wir auch Open Source AI (LocalAI). Damit bleiben alle Daten auf unseren Servern.

Sprechen Sie mich bei Fragen gerne an.