Für eine Aufgabe das geeignete KI-Modell mit dem Smart Router in Langflow auswählen

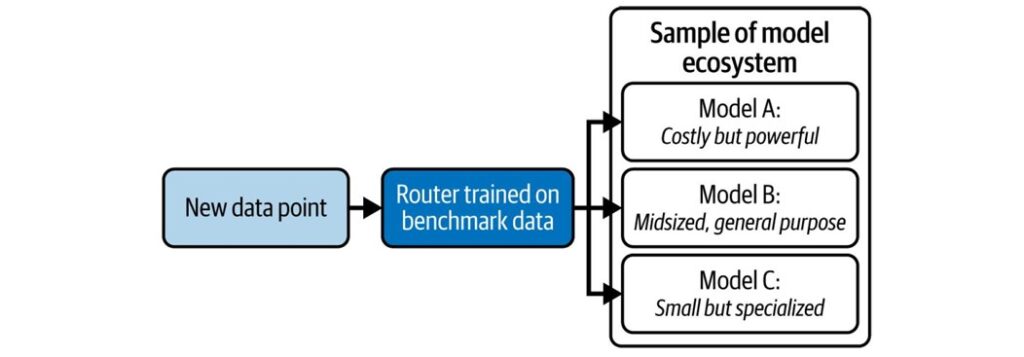
An AI router that understands the capabilities of models in its library directs
a given inference request to the best model able to perform the task at hand (Thomas et al. 2025)

Es ist in Organisationen nicht mehr zeitgemäß, alle anfallenden Aufgaben (Tasks) von einem sehr großen und Leistungsfähigen KI-Modell bearbeiten zu lassen. Dieses „One Size Fits All“ führt nur zu einem erhöhten Ressourcenverbrauch und damit zu hohen Kosten.

Besser ist es, für jede Anfrage das geeignete Modell auszuwählen. In dem Beitrag Künstliche Intelligenz: Mit einem AI Router verschiedene Modelle kombinieren hatte ich diese Vorgehensweise grob dargestellt. Die Abbildung zeigt das prinzipielle Vorgehen: Ein AI Router entscheidet auf Basis von Vorgaben, welches KI-Modell für den Task geeignet erscheint.

Da wir auf Open Source Software und Open Source AI setzen, ist es interessant, dass Langflow nun die Möglichkeit bietet, einen Smart Router zu nutzen. Basis ist dabei die schon vorhandene Wenn > Dann (If-Else) Funktion.

„The Smart Router component is an LLM-powered variation of the If-Else component. Instead of string matching, the Smart Router uses a connected Language Model component to categorize and route incoming messages“
Langflow. (o. D.). Quickstart. Langflow Documentation. Abgerufen am 16. Oktober 2026, von https://docs.langflow.org/get-started-quickstart)

Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

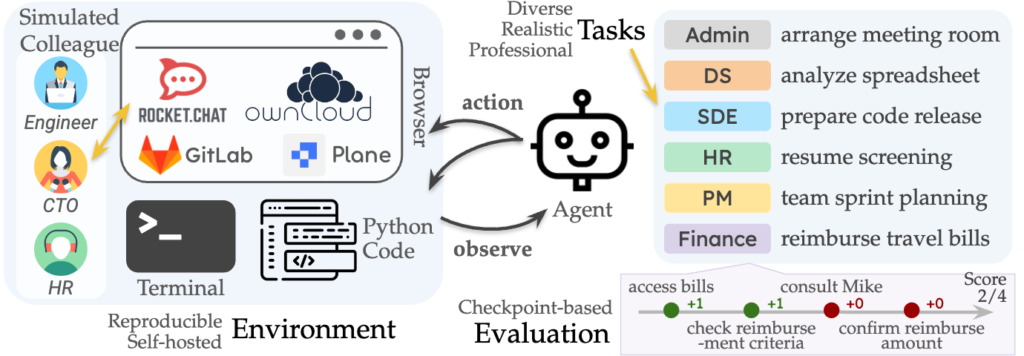
The Agent Company: KI-Agenten können bis zu 30% der realen Aufgaben eines Unternehmens autonom übernehmen

Quelle: Xu et al. (2025): The Agent Company | https://the-agent-company.com/

Es ist mehr als eine interessante Spielerei von KI-Enthusiasten: KI-Agenten (AI-Agents) können immer mehr Aufgaben in einem Unternehmen autonom übernehmen. Um das genauer zu untersuchen, haben Wissenschaftler in dem Paper

Xu et al. (2025): TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks

wichtige Grundlagen dargestellt, und auch untersucht, welche Tasks in einem Unternehmen von KI-Agenten autonom übernommen werden können.

Wie in der Abbildung zu erkennen ist, wurden Mitarbeiterrollen simuliert (Engineer, CTO, HR) und verschiedene Tasks angenommen. Bei dem Admin beispielsweise „arrange meeting room“ und bei dem Projektmanager (PM) „teams sprint planning“, was auf das Scrum Framework hinweist. Als Modelle für Trainingsdaten wurden Large Language Models (LLMs) genutzt – closed source und open weight models:

„We test baseline agents powered by both closed API-based and open-weights language models (LMs), and find that the most competitive agent can complete 30% of tasks autonomously“ (Xu et al (2025).

Es wird zwar ausdrücklich auf die Beschränkungen (Limitations) hingewiesen, doch gibt diese Untersuchung konkrete Hinweise darauf, welche Aufgaben (Tasks) in Zukunft möglicherweise von KI-Agenten in Unternehmen übernommen werden können.

Interessant bei dem Paper ist, dass dazu auch eine ausführliche Website https://the-agent-company.com/ aufgebaut wurde, auf der Videos, inkl. der verschiedenen KI-Agenten zu finden sind. Interessiert Sie das? Wenn ja, nutzen Sie einfach den Quick Start Guide und legen Sie los!

Natürlich sollte jedes Unternehmen für sich herausfinden, welche Tasks von KI-Agenten sinnvoll übernommen werden sollten. Dabei wird schon deutlich, dass es hier nicht darum geht, ganze Berufe zu ersetzen, sondern ein Sammelsurium von unterschiedlichen Tasks (Ausgaben) autonom durchführen zu lassen.

Hervorzuheben ist aus meiner Sicht natürlich, dass die Autoren mit dem letzten Satz in ihrem Paper darauf hinweisen, dass die Nutzung von Open Source AI in Zukunft ein sehr vielversprechender Ansatz sein kann – aus meiner Sicht: sein wird!

„We hope that TheAgentCompany provides a first step, but not the only step, towards these goals, and that we or others may build upon the open source release of TheAgentCompany to further expand in these promising directions“ (Xu et al 2025).

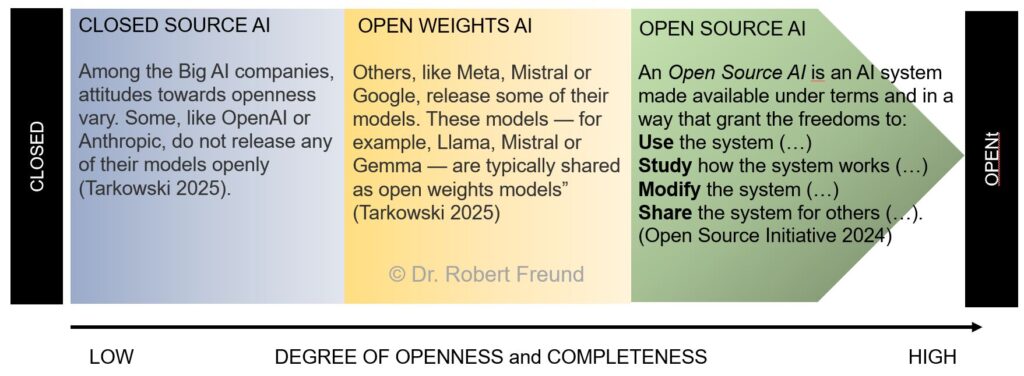
Das Kontinuum zwischen Closed Source AI und Open Source AI

In dem Beitrag AI: Was ist der Unterschied zwischen Open Source und Open Weights Models? hatte ich schon einmal darauf hingewiesen, dass es zwischen den Polen Closed Source AI und Open Source AI ein Kontinuum weiterer Möglichkeiten gibt.

Die Grafik illustriert den Zusammenhang noch einmal anhand der zwei Dimensionen Degree of Openness und Completeness. Man sieht hier deutlich, dass der Firmenname OpenAI dazu führen kann, z.B. ChatGPT von OpenAI als Open Source AI zu sehen, obwohl es komplett intransparent ist und somit in die Kategorie Closed Source AI gehört. Die Open Weights Models liegen irgendwo zwischen den beiden Polen und machen es nicht einfacher, wirkliche Open Source AI zu bestimmen.

Eine erste Entscheidungshilfe kann die Definition zu Open Source AI sein, die seit 2024 vorliegt. Anhand der (recht wenigen) Kriterien kann man schon eine erste Bewertung der Modelle vornehmen.

In der Zwischenzeit hat sich auch die Wissenschaft dem Problem angenommen und erste Frameworks veröffentlicht. Ein erstes Beispiel dafür ist hier zu finden:

White et al. (2024): The Model Openness Framework: Promoting Completeness and Openness for Reproducibility, Transparency, and Usability in Artificial Intelligence | Quelle).

Künstliche Intelligenz: Wie hängen Modelle, Agenten und Tools zusammen?

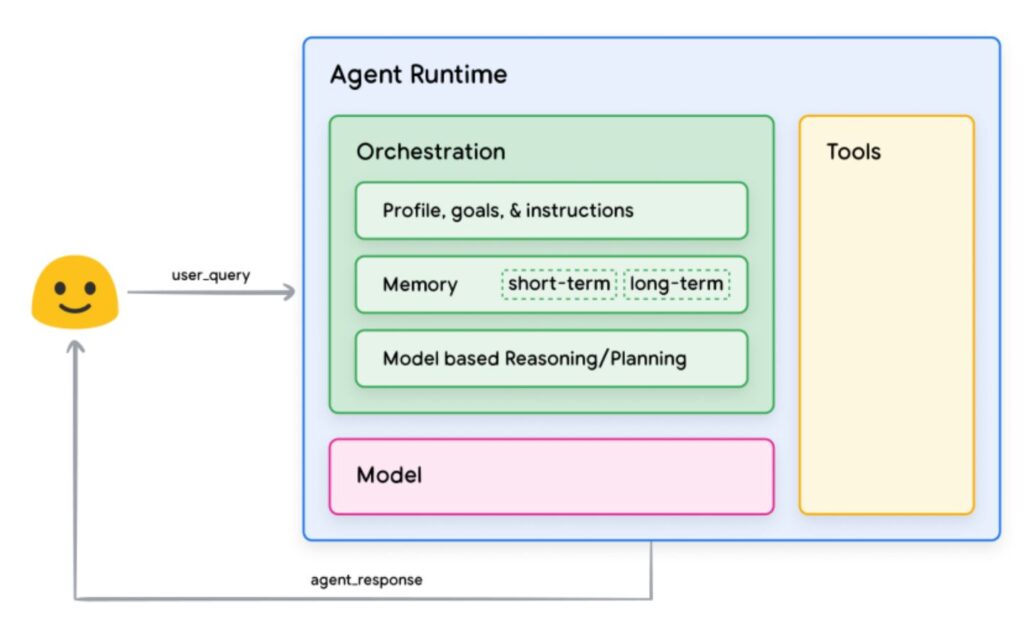
General agent architecture and components (Wiesinger et al. (2024): Agents)

In der letzten Zeit kommt immer mehr der Begriff AI Agent – oder auch Gen AI Agent – auf. Mit Hilfe der Abbildung möchte ich die Zusammenhänge der verschiedenen Komponenten erläutern.

Die Modelle (Model), oft als Language Models, Small Language Models oder Large Language Models (LLM) bezeichnet, enthalten eine sehr große Menge an Trainingsdaten. Dabei können Open Source AI Models, Open Weights Models und Closed AI Models unterschieden werden. An dieser Stelle merkt man schon, wie wichtig die Auswahl eines geeigneten Modells ist. Diese Modelle sind üblicherweise nicht auf typische Tools oder Kombinationen von Tools trainiert. Oftmals wird dieser Teil dann mit Hilfe von immer detaillierteren Eingaben (Prompts, Dateien etc.) des Users spezifiziert.

Die Beschränkungen von Modellen bei der Interaktion mit der „äußeren Welt“ kann durch geeignete Tools erweitert werden. Dazu können spezielle Datenbanken, API-Schnittstellen usw. genutzt werden. Siehe dazu auch RAG: KI-Basismodelle mit eigener Wissensbasis verknüpfen.

Der AI Agent orchestriert nun alle Komponenten, wie die Eingabe des Users, das jeweilige Modell (oder sogar mehrere), die Tools und gibt das Ergebnis (Output) für den User in der gewünschten Form aus.

Die Möglichkeit, AI Agenten zu erstellen, bieten in der Zwischenzeit viele kommerzielle KI-Anbieter an. Wir gehen demgegenüber den Weg, Open Source AI auf unserem Server zu installieren und zu nutzen:

AI Agenten konfigurieren wir mit Langflow (Open Source). Dabei können wir in Langflow auf sehr viele Open Source AI Modelle über Ollama (Open Source) zugreifen, und vielfältige Tools integrieren. Alle Daten bleiben dabei auf unserem Server.

Open Source AI-Models for Europe: Teuken 7B – Training on >50% non English Data

Immer mehr Privatpersonen und Organisationen realisieren, dass die populären Trainingsdaten (LLM: Large Language Models) für ChatGPT von OpanAI, oder auch Gemini von Google usw., so ihre Tücken haben können, wenn es beispielsweise im andere oder um die eigenen Urheberrechte geht. In diesem Punkt unterscheiden wir uns in Europa durchaus von den US-amerikanischen und chinesischen Ansätzen. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich. Darüber hinaus liegen die Daten der bekannten (closed source) LLMs zu einem überwiegenden Teil in englischer oder chinesischer Sprache vor.

Die Alternativen waren bisher entweder nicht leistungsstark genug, oder einfach nicht für die Allgemeinheit als Open Source Model verfügbar. Siehe dazu Open Source AI Definition – 1.0: Release Candidate 2 am 21.10.2024 veröffentlicht. Das hat sich in der Zwischenzeit geändert. Beispielsweise wurde Open Source AI: Common Corpus als größte offene Trainingsdatenbank veröffentlicht, die gerade Daten für KI-Anwendungen enthält, die urheberrechtlich freigegeben wurden. Weiterhin gibt es das geförderte Projekt OpenGPT-X, das nun Teuken 7B-v0.4 veröffentlicht hat.

Quelle: https://opengpt-x.de/en/models/teuken-7b/

„Multilingual, open source models for Europe – instruction-tuned and trained in all 24 EU languages…. Training on >50% non English Data. (…) This led to the creation of a custom multilingual tokenizer“ (ebd.).

Neben der freien Verfügbarkeit (Open Source AI) (via Hugging Face) ist somit ein großer Pluspunkt, dass eine große Menge an Daten, nicht englischsprachig sind. Das unterscheidet dieses Large Language Model (LLM) sehr deutlich von den vielen englisch oder chinesisch dominierten (Closed Source) Large Language Models.

Insgesamt halte ich das alles für eine tolle Entwicklung, die ich in der Geschwindigkeit nicht erwartet hatte!

Ein Reifegradmodell für Industrie 4.0

industrie-40-maturity-model

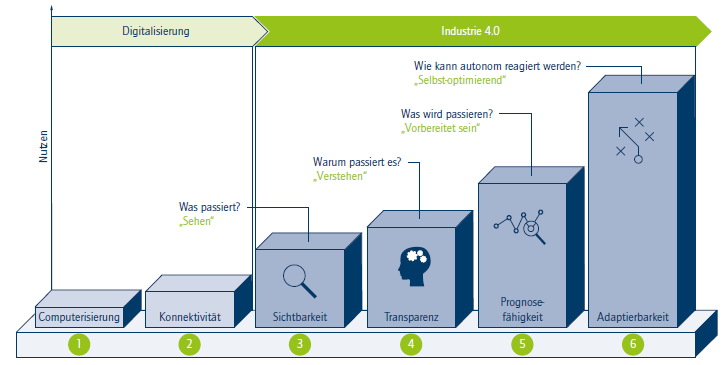
Alle reden von Industrie 4.0, doch ist vielen nicht klar, welche Schritte erforderlich sind. In der acatech-Studie Schuh et al. (2017): Industrie 4.0. Maturity Index. Die digitale Transformation von Unternehmen gestalten (PDF) wird das stufenförmige Vorgehen ausführlich dargestellt und erläutert (S. 15):

Unternehmen stehen heute vor der Aufgabe, die Voraussetzungen für Industrie 4.0 zu schaffen. Daher startet der Entwicklungspfad mit der Digitalisierung, die noch kein Bestandteil von Industrie 4.0 ist, aber durch Computerisierung und Konnektivität die Grundlagen schafft. Hierauf folgt in vier Stufen der Aufbau von Industrie 4.0-Fähigkeiten.

In dem von uns entwickelten Blended Learning Lehrgang Innovationsmanager (IHK) gehen wir auch darauf ein. Der nächste Lehrgang wird im November/Dezember bei der IHK Rhein-Neckar angeboten. Weitere Informationen zu unseren IHK-Zertifikatslehrgängen finden Sie auf unserer Lernplattform.