KI-Modelle: Mistral Large 4 veröffentlicht

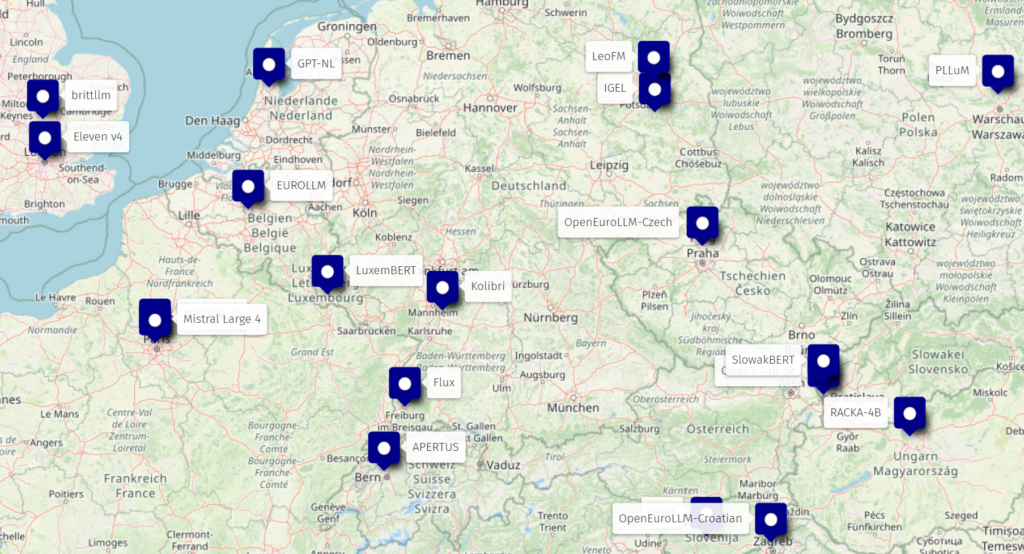
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

In den letzten Jahren wird immer deutlicher, dass es bei großen KI-Modellen (LLMs: Large Language Models) nicht alleine darum geht, in spezifischen technischen Tests (Benchmarks) ganz vorne zu sein. Es geht vielmehr immer mehr darum, dass das KI-Modell die europäischen Werte mit den europäischen Rechten, ethischen und moralischen Grundsätzen respektiert, und dass die generierten Daten in Europa bleiben. Die Bewertungskriterien für leistungsfähige KI-Modelle verschieben sich – nicht nur in Europa sondern weltweit – zu einer eher ganzheitlichen Bewertung.

In Europa spielt dabei – unter anderem – Mistral AI eine wichtige Rolle. Das französische Unternehmen hat von Anfang an auf Open Source AI und Open Weight Modelle gesetzt. Die ganze Modellfamilie wurde nun an der Spitze durch Mistral Large 4 ergänzt. In meiner OpenStreetMap zu europäischen Open Source und Open Weight Modellen, habe ich das Modell ergänzt (Abbildung).

Wie der Name es schon vermuten lässt, ist es ein sehr großes Modell, das für große Organisationen interessant ist, die sicherheitsrelevante Daten verarbeiten möchten. Auch ist das Coding in dem Modell eine Stärke, die sich gegenüber den proprietären KI-Modellen aus den USA nicht verstecken muss. Große Organisationen mit entsprechender Hardware-Infrastruktur können sich Mistral Large 4 herunterladen – ganz im Sinne der eigenen KI-souveränität.

Natürlich gibt es bei Mistral AI auch kleinere KI-Modelle, die es auch KMU ermöglicht, ein digital souveränes eigenes KI-System zu nutzen. Wie man so ein europäisches KI-System, das Mistral AI nutzt, für innovative KMU entwickeln kann, habe ich in meinem Paper auf der MCP-CE 2026 in Ungarn beschrieben.

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

Künstliche Intelligenz ist kein neutraler Interaktionspartner

Speech bubbles, blank boards and signs held by voters with freedom of democracy and opinion. The review, say and voice of people in public news adds good comments to a diverse group.

In meinem Blogbeitrag vom 24.10.2026 ging es um Cyberself und Personalisierung. Dabei wurde herausgestellt, dass Menschen und KI-Systeme durchaus mehrere „Persönlichkeiten“ haben können, wobei der Begriff bei Menschen und KI-Modellen unterschiedlich ist.

Wenn Menschen also KI-Modelle als Interaktionspartner nutzen, passen sich die KI-Systeme dem Nutzer an, wodurch eine Art Zuschreibung einer „Persönlichkeit“ durch den Nutzer entsteht. Manche Nutzer schreiben das KI-Modell auch in damit verbundenen Texten (Prompts) an.

Dadurch entsteht eine Interaktion der Bestätigung, die kritische oder konfliktträchtige, emotionale – eben menschliche – Interaktionen verkümmern lässt. Treffen die Personen, die ihre KI-Modelle und -Agenten als Partner sehen, auf die reale menschliche Welt, kann es zu antisozialen Reaktionen kommen.

„Zusammengefasst ist KI kein neutraler Interaktionspartner, sondern ein sozial wirksamer Akteur, dessen Effekte maßgeblich durch seine Funktionslogik, sein Trainingsziel und sein Interaktionsdesign bestimmt werden. Anwendungen, die primär auf Zustimmung und Konfliktvermeidung ausgelegt sind, riskieren langfristig eine Schwächung der Selbstreflexion, Perspektivenvielfalt und sozialen Konfliktfähigkeit sowie eine Verschiebung sozialer Bindungen weg von menschlichen Beziehungen. Aufklärung über Konsequenzen und die Stärkung individueller Kompetenzen sind zentral“ (Glöckner et al., 2026).

Es kommt daher bei der Nutzung von Künstlicher Intelligenz auch darauf an, Modelle zu nutzen, die transparent und frei verfügbar sind – eben den Anforderungen von Open Source AI (Definition) entsprechen. Siehe dazu auch Mit proprietärer Künstlicher Intelligenz (KI) kauft man sich auch die Denkwelt der Eigentümer ein.

Es bieten sich daher verschiedene europäischen KI-Modelle an (Open Weight und Open Source), die ich auf einer Open Street Map zusammengetragen habe:

Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Google Maps schränkt Funktionsumfang ein – Wechsel zu OpenStreetMap?

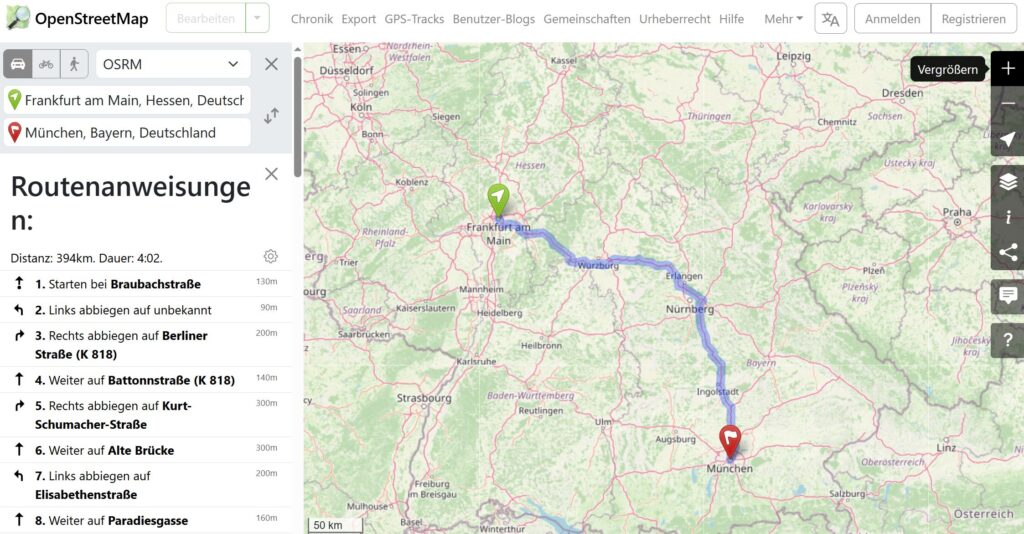
Screenshot: OpenStreetMap – Route: Frankfurt-München

Wir haben uns alle mehr oder weniger daran gewöhnt, die verschiedenen Apps von Google zu nutzen. Ob es der Browser Chrome ist, Google Drive, etc. oder auch Google Maps . Wie ich schon in mehreren Beiträgen geschrieben habe, kommt es bei den scheinbar kostenlosen Apps (wir zahlen mit unseren Daten) von Google, Microsoft und Co. nach einer Phase der Gewöhnung zu einem Lock-in. Diese Pfadabhängigkeit wird dann genutzt, um die bisherigen Gewohnheiten einzuschränken oder kostenpflichtig zu stellen.

Google Maps sieht die Zeit gekommen, bisher verfügbare Informationen auf den gewohnten Karten zu reduzieren, wenn man sich nicht mit dem Google Konto angemeldet hat. Der Hintergrund wird in dem Artikel Google Maps ohne Anmeldung nur noch eingeschränkt nutzbar (Pakolski 2026, auf Golem.de) ausführlicher dargestellt.

„Google schränkt den vollen Funktionsumfang von Google Maps weiter ein, wenn Anwender sich nicht mit einem Google-Konto anmelden. Wird Google Maps etwa im Browser ohne Anmeldung genutzt, fehlen alle Rezensionen und Bilder zu Restaurants, Geschäften oder Touristenattraktionen“ (ebd.).

Was kann man machen? Sich ärgern, und sich in Zukunft immer mit dem Google Konto anmelden? Das ist der bequeme Weg, den man mit seinen Daten „bezahlt“. Alles andere bedeutet einen Aufwand (Switching Costs), ja. Genau das ist das Kalkül von Google (und anderen).

Es gibt allerdings auch die Möglichkeit, sich von solchen Anwendungen nach und nach zu emanzipieren, und digital souveräner zu werden. Bei dem Beispiel Google Maps gibt es die Open Source Alternative OpenStreetMap (OSM). Folgende Informationen sind bei OSM-About zu finden:

OpenStreetMap stellt Kartendaten für tausende von Webseiten, Apps und andere Geräte zur Verfügung.

OpenStreetMap legt Wert auf lokales Wissen. Autoren benutzen Luftbilder, GPS-Geräte und Feldkarten zur Verifizierung, sodass OSM korrekt und aktuell ist.

Ja, OpenStreetMap ist gewöhnungsbedürftig, doch sollte jeder abwägen, ob er aus Bequemlichkeit kurzfristig eine digitale Abhängigkeit, oder eher mittelfristig eine Digitale Souveränität möchte.

Siehe dazu auch Digitale Souveränität: Welche Open Source Alternativen gibt es?

OpenStreetMap und Open Innovation

openstreetmap.pngDER SPIEGEL berichtet in seiner Ausgabe 22/2008 vom 26.05.2008 unter dem Titel „Wikipedia der Navigation“ über das Projekt OpenStreetMap. Es ist erstaunlich, dass DER SPIEGEL ausführlich (S. 144-146) über ein Projekt berichtet, das von den Daten der vielen Freiwilligen gespeist wird: „OpenStreetMap is a free editable map of the whole world. It is made by people like you. OpenStreetMap allows you to view, edit and use geographical data in a collaborative way from anywhere on Earth.“ Die frei verfügbaren Daten können und werden genutzt, z.B. von Openrouteservice, einem (kostenlosen)Routenplaner für Fußgänger: „Routing with user-generated, collaboratively collected free geodata. This service is based on open standards by the Open Geospatial Consortium (OGC). Thanks to OpenStreetMap.org„. Diese Entwicklungen sind Gegenentwürfe zu den Unternehmensangeboten von TomTom und TeleAtlas, Nokia und Navteq, und GoogleMaps, die eben nicht alle Daten einstellen, sondern zunächst die, die für das Geschäft interessant sind. Es bleiben also viele Lücken, die allerdings für Bewohner (User) dieser Gegendenden sehr interessant sind – und damit meine ich nicht nur Gegenden in Afrika, sondern auch bei uns in Deutschland. Die Unternehmen versuchen jetzt zwar, User einzubinden (TomTom), dennoch ist es bei weitem nicht die user-centered innovation von der Eric von Hippel schon in den 80er Jahren gesprochen hat. Das Erschließen der „sticky information“ (von Hippel) ist schwierig und teuer. Einerseits sind die Anwenderinformationen nicht so einfach von einem Kontext (Kunde) in den anderen Kontext (Unternehmen) zu übertragen und andererseits gibt es auch bei den Unternehmen eine Art der Blockade gegenüber den Informationen, die nicht dem Unternehmenswissen entsprechen. In seinem Buch von Hippel, E. (2005): Democratizing Innovation weist der Autor auf die vielfältigen Möglichkeiten von Lead User Konzepten und Open Innovation hin. Open Innovation ist eine Chance für Unternehmen, die sie nutzen sollten …. oder die User machen es eben selbst. Siehe dazuauch Reichwald/Piller (2006): Interaktive Wertschöpfung.