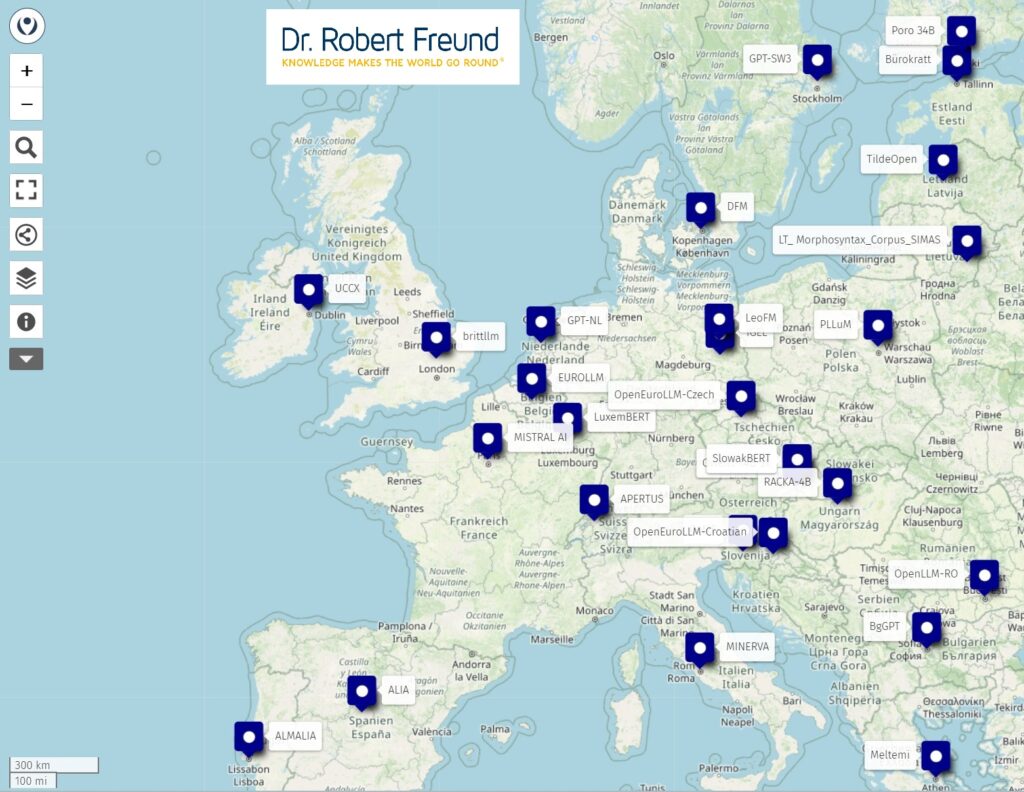
Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen

Eigene Open Street Map: https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154

In den letzten Monaten habe ich über viele Open Source KI-Modelle in Europa geschrieben, die in der (oder den) spezifischen Landessprachen trainiert wurden. Die Links zu den jeweiligen Modellen habe ich nun zusammen mit dem Hinweis auf meinen dazugehörenden Blogbeitrag in Open Street Map (bewusst nicht in Google Maps) in einer eigenen Karte eingetragen (Abbildung).

Den Marker für ein Modell ist der Landeshauptstadt zugeordnet. Modelle, die alle europäischen Sprachen berücksichtigen, sind mit einem Marker auf Brüssel versehen.

Klicken Sie auf das Bild und Sie kommen direkt zu meiner angelegten Open Street Map.

Die erste Übersicht zeigt deutlich, wie vielfältig die Landschaft für Open Source KI-Modelle in Europa geworden ist. Ich bin sicher, die Modelle werden in Zukunft immer mehr von Privatpersonen, Kleinen und Mittleren Unternehmen (KMU), oder Öffentlichen Verwaltungen genutzt, da Transparenz (Offene Modelle), kulturelle Bezug (Landestypische Sprache) und die geringen Kosten (frei verfügbar) starke Argumente sind.

Wenn bei der Auswahl der KI-Modelle noch hinzukommt, dass Digitale Souveränität und Resilienz immer wichtiger werden, geht kein Weg an europäischen Open source KI-Modellen vorbei.
Auf der internationalen Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

KI-Modelle berücksichtigen nur wenige der weltweit über 7000 Sprachgemeinschaften

Image by Tumisu from Pixabay

Die Übersetzungen der bekannten closed source KI-Modelle sind schon richtig gut und können beispielsweise für Touristen sehr hilfreich sein. Bei unserer Reise nach Taiwan, Japan und Singapur 2025 haben wir das selbst erlebt.

Wenn es allerdings um sensible Bereiche wie Gesundheit, Recht usw. geht, kommt es oftmals auf sprachliche Nuancen an. Diese Texte/Situationen können die gängigen KI-Modelle recht gut, aber nicht immer sehr gut bewältigen. Für agglutinierende Sprachen, wie Ungarisch, Baskisch, etc. reichen die üblichen KI-Modelle beispielsweise nicht aus

So kann es in Regionen der Welt im Gesundheitsbereich zu lebensbedrohlichen Situationen kommen, da der Input und die Ergebnisse der KI-Modelle geographisch und linguistisch sehr unterschiedlich sind. Genau das haben die United Nations (UN) in einer aktuellen Veröffentlichung noch einmal bestätigt.

„The inputs and outcomes of artificial intelligence are geographically and linguistically uneven
Most of the world’s languages and cultures remain underserved. More than 7,000 languages are spoken worldwide, yet AI model development and evaluation infrastructure reflects only a small fraction of them“
UN (2026): Preliminary Report of the Independent International Scientific Panel on AI

Es wundert daher nicht, dass es immer mehr Länder und Regionen in der Welt gibt, die ihre eigenen KI-Modelle entwickeln und veröffentlichen – natürlich als Open Source Modelle. Für Europa habe ich in unserem Blog schon auf einige interessante Open Source KI-Modelle hingewiesen: TEUKEN 7B (Alle europäischen Sprachen), EURO LLM (Alle europäischen Sprachen), MINERVA AI LLM (Italienisch), PLLuM (Polnisch), RAKA 4B (Ungarisch), GPT-SW3 (Schwedisch), ALIA (Spanisch), AMALIA (Agente Multimodal Automático de Linguagem com IA).

Ich halte solche Modelle auch für innovative Kleine und Mittlere Unternehmen (KMU) spannend, da sie sich dadurch von dem was alle anderen machen (Ein KI-Modell für alles – One size fits all), unterscheiden können. Dazu habe ich ein Paper für die internationale Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) geschrieben:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Siehe dazu auch:

KI-Modelle: Von „One Size Fits All“ über Variantenvielfalt in die Komplexitätsfalle?

Künstliche Intelligenz im Innovationsprozess von Organisationen

Künstliche Intelligenz: Was ist unter einer Mixture of Experts (MoE) Architektur zu verstehen?

KIMI 3: Open Source AI – sehr leistungsfähig, allerdings mit regulativen chinesischen Einschränkungen

Das bild ist mit Mistral AI generiert

Am 12. November 2025 habe ich in einem Blogbeitrag auf KMI 2 Thinking hingewiesen. Nach DeepSeek R1 war KIMI 2 ein weiteres chinesisches Modell das aufgezeigt hatte, dass es möglich ist ein leistungsfähiges Open Source KI-Modell zu entwickeln, das viel weniger Ressourcen – und damit Kosten – erfordert. Der Schwerpunkt des von KIMI 2 Thinking liegt dabei auf „Coding“.

Nun ist mit KIMI 3 ein weiteres Open Source KI-Modell für den 27.07.2026 angekündigt. Wenn man es genau nimmt, ist es ein Open Weight Modell, da die Trainingsdaten nicht frei verfügbar sind. Der Schwerpunkt liegt bei dem Modell wieder auf Coding, allerdings auch auf Knowledge Work (Wissensarbeit).

„Kimi K3 is the first open-source model to reach 2.8 trillion parameters.“ Source: KIMI Platform, accessed 19.07.2026).

In dem Beitrag Moonshot AI zeigt Kimi K3: Open- Source-KI aus China (IT Business vom 17.07.2026 wird auf die Leistungsfähigkeit des Modells hingewiesen („Vorsprung der USA auf chinesische KI-Labore mittlerweile auf nur noch sechs bis neun Monate geschmolzen“).

Weiterhin musss allerdings auch kritisch angemerkt werden, dass chinesische KI Modell (Open Source AI oder nicht) den Vorgaben der chinesischen (und amerikanischen ) Administration unterliegen. In China sind beispielsweise Beiträge zu Taiwan oder zum Tiananmen-Platz usw. reglementiert. Solche Restriktionen schränken die Qualität der generierten Antworten deutlich ein.

Die Chance von Europa ist, Open Source KI-Modelle zu entwickeln, die auch einen niedrigen Ressourcenbedarf haben, ein ähnliches oder bessres Leistungsniveau wie die chinesischen open source Modelle haben, und letztendlich den europäischen Werten entsprechen.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Der Nutzen von Open Source Software übersteigt die Kosten deutlich

Image by Gerd Altmann from Pixabay

Wenn es um Open Source Software geht (OSS) geht, muss natürlich auch über die anfallenden Kosten gesprochen werden. Dazu zählen beispielsweise Installations- und Supportkosten, Anforderungen an die Lizenzkonformität und um potenzielle Sicherheitslücken. Neben den anfallenden Kosten stellt sich natürlich auch die Frage, wie es mit dem Nutzen von Open Source Software aussieht. In einer Studie von Henry Chesbrough aus dem Jahr 2023 konnte nachgewiesen werden, dass der Nutzen diese Kosten deutlich übersteigt.

„However, the results of this survey are quite consistent with earlier survey research (Nagle, 2019; European Commission, 2021), which shows that the perceived benefits of utilizing OSS significantly exceed these costs for the large majority of organizations that use OSS“ (Chesbrough, H. (2023), Measuring the Economic Value of Open Source: A Survey and a Preliminary Analysi, The Linux Foundation | PDF).

Die wirtschaftlichen Vorteile gehen einher mit einer stärkeren Unabhängigkeit (Digitale Souveränität) und damit verbunden mit einer besseren Widerstandsfähigkeit (Resilienz) der Organisation.

Die in der Zwischenzeit eingetretene Unmündigkeit (Digitale Abhängigkeit) von US amerikanischen digitalen Angeboten, hat einzelne Personen, Organisationen und ganze Öffentliche Verwaltungen in eine Pfadabhängigkeit geführt, aus der viele einfach nicht mehr herauskommen. Denn es ist ja so bequem, unmündig zu sein.

Immanuel Kant schrieb schon 1784 in seiner Streitschrift: „Beantwortung der Frage: Was ist Aufklärung?“: „Unmündigkeit ist das Unvermögen, sich seines Verstandes ohne Leitung eines anderen zu bedienen. Faulheit und Feigheit sind die Ursachen, warum ein so großer Teil erwachsener Menschen, nachdem sie die Natur längst von fremder Leitung freigesprochen hat, dennoch gerne zeitlebens unmündig bleiben, und warum es anderen so leicht wird, sich zu deren Vormündern aufzuwerfen. Es ist so bequem, unmündig zu sein!“ (Fuchs, J.; Stolorz, C. (2001): Produktionsfaktor Intelligenz. Wiesbaden).

Die Zeit ist reif, sich auf seinen eigenen Verstand zu besinnen, und sich von den aufgebauten digitalen Abhängigkeiten zu lösen. Ganz im Sinne des Wahlspruchs der Aufklärung: „Habe Mut, Dich Deines eigenen Verstandes zu bedienen!“

Siehe dazu auch Die erfolgreiche Geschichte von Open Source KI zeigt, wie dieser Weg aussehen kann. Digitale Souveränität: Europa, USA und China im Vergleich.

SOOFI S: Das erste Modell für industrielle KI in Europa – Open Source

Quelle::.https://www.soofi.info/

Auf das Projekt SOOFI (Sovereign Open Source Foundation Models) hatte ich schon am 26.11.2025 hingewiesen. Zu der Zeit wurde das Projekt in einer Pressemitteilung erst angekündigt. In der Zwischenzeit ist mit SOOFI S das erste Modell für industrielle KI in Europa veröffentlicht worden.

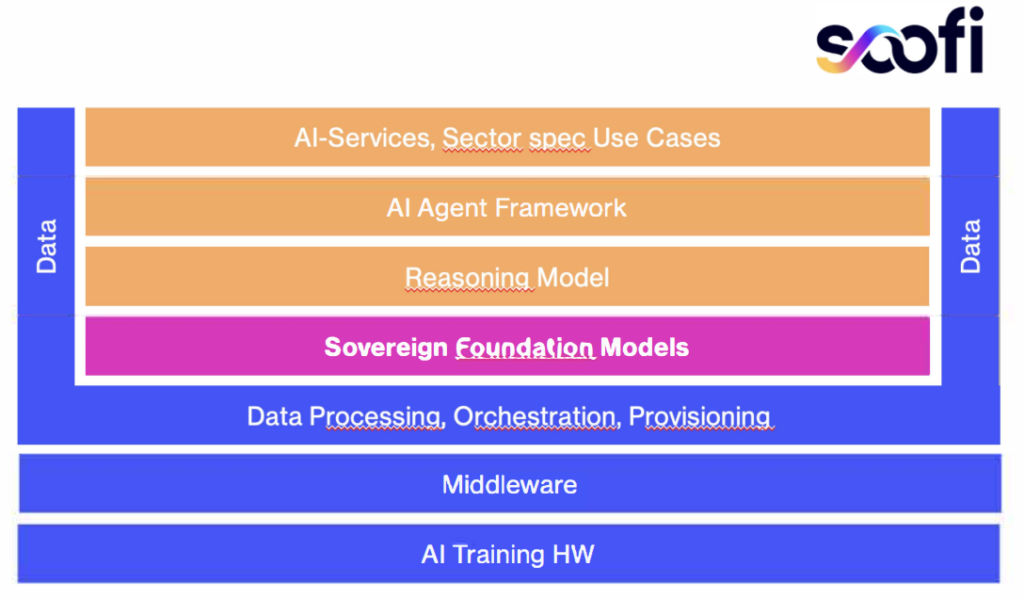
Das Modell ist auf englische und deutsche Texte ausgelegt und ein 30B Mixture-of-Experts-Modell. Dabei wird für den jeweiligen Input das geeignete Experten-Modell ausgewählt, um einen qualitativ hochwertigen Output zu generieren. Die folgende Abbildung zeigt die Intergration des Souvereign Foundation Models in das Gesamtkonzept.

Quelle: https://www.soofi.info/

Aktuell wird das SOOFI S Modell in industriellen Anwendungen getestet. Die dabei gemachten Erfahrungen fließen in das Modell ein. Eine Veröffentlichung zur allgemeinen Nutzung ist daher noch nicht erfolgt.

SOOFI S ist ein weiteres positives Beispiel für ein europäisches Open Source Foundation Model, das es Unternehmen in der Zukunft ermöglichen wird, ihre Abhängigkeiten von US amerikanischen oder chinesischen Modellen zu reduzieren. Dadurch werden die Organisationen digital souveräner und letztendlich auch resilienter.

Siehe dazu auch Die erfolgreiche Geschichte von Open Source KI zeigt, wie dieser Weg aussehen kann. Digitale Souveränität: Europa, USA und China im Vergleich.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auch auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Skill shortage: Es fehlen Kompetenzen zu Open Source Software und Open Source Hardware

Das Bild ist mit Mistral AI generiert

Aktuell wird oft darüber gesprochen und geschrieben, dass alle Kompetenzen in der Nutzung von Künstlicher Intelligenz benötigen. Dabei setzen die Marktführer auf kostenlose Online-Kurse, die die Nutzer an die jeweiligen KI-Modelle adaptieren sollen. Die Nutzer passen sich dabei an die Logik des KI-Modells an, und entwickeln angepasste Kompetenzen.

Im nächsten Schritt wird diese Abhängigkeit (Pfadabhängigkeit) Schritt für Schritt monetarisiert – immerhin müssen ja die hohen Investitionen refinanziert werden. Wenn einzelne Personen oder Organisationen diesen Weg in den letzten Jahren eingeschlagen haben, sprechen sie nur noch von solchen, angepassten Kompetenzen. Siehe dazu auch Künstliche Intelligenz (KI): Lock-in und Switching Costs.

Kompetenzen zur Nutzung von Open Source Software oder Open Source Hardware sind damit weniger gemeint – überspitzt formuliert könnte man auch sagen, dass fast niemand daran denkt.

Wenn es Europa mit der Digitalen Souveränität ernst meint, sollten wir allerdings gerade diese Kompetenzen fördern und entwickeln, da gerade Open Source zu mehr Resilienz auf den verschiedenen Ebenen führt. Aktuell gibt es allerdings nicht so viele Personen, die sich mit den Möglichkeiten von Open Source Software und Open Source Hardware auskennen (digital skill shortage).

„By aligning open source projects with structured upskilling programs, Europe can address its digital skills shortage and build a competitive workforce that supports its ambition for technological sovereignty. By fostering collaboration, investing in education, and ensuring sustainable funding, we can secure the future of open source as a driver of technological and scientific progress. With initiatives like Software Heritage and national policies advocating for open science, the foundation is set for a more inclusive and resilient open source ecosystem“ (Di Cosmo, 2026 Open Source and the Skill Shortage, in Eclipse Foundation, 2026).

Es liegt an uns die bestehenden Abhängigkeiten nach und nach zu reduzieren, um unseren eigenen, europäischen Weg bei der Nutzung von Technologie, speziell auch Künstlicher Intelligenz, zu entwickeln. Die erfolgreiche Geschichte von Open Source KI zeigt, wie dieser Weg aussehen kann. Digitale Souveränität: Europa, USA und China im Vergleich.

Mit Open Source zu einer vernetzten Gesellschaft – der 4. Sektor

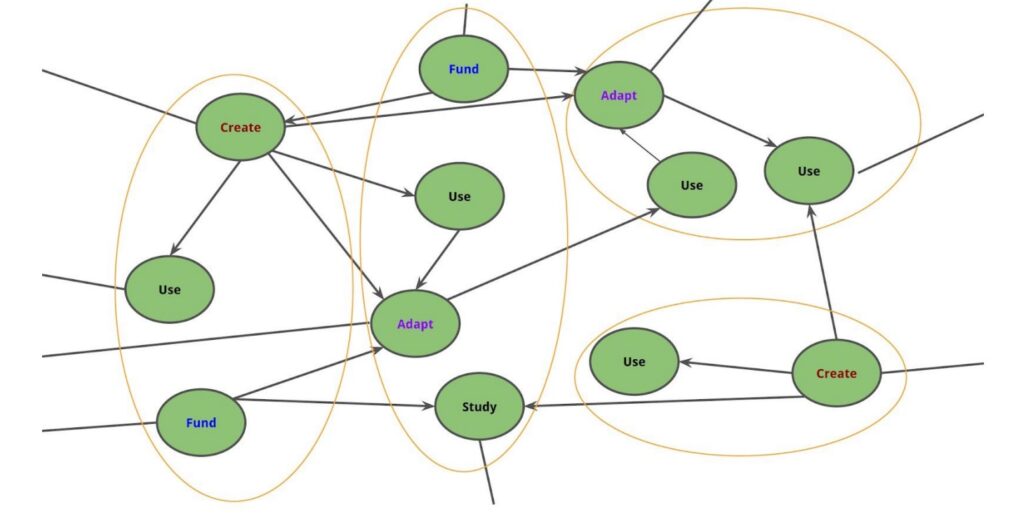
The meshed society model (Phillips 2026)

Unsere Gesellschaft ist traditionell in drei Bereiche gegliedert. Da ist zunächst der Öffentliche Sektor mit seinen verschiedenen Dienstleistungen. Der Private Sektor wiederum umschreibt alle geschäftlichen Aktivitäten in einer Gesellschaft. Scheinbar abschließend kommt noch der Nonprofit Sektor hinzu, der soziale Güter ohne Profitinteressen beschreibt.

Auf diese drei Sektoren sind auch alle regulatorischen Rahmenbedingungen ausgerichtet. Es wird davon ausgegangen, dass die Produktion von Gütern und Dienstleistungen zentral erfolgt und Bürger diese erwerben und nutzen, wobei diese Leistungen mit Geld bezahlt werden. Dieses Geld erhalten die Erwerbstätigen, indem sie für die Organisationen in den Sektoren arbeiten.

Interessant ist, dass sich in den letzten ca. 40 Jahren, seit dem es Open Source Software gibt, ein neuer Sektor mit Open Source Communities gebildet hat, der als Vierter Sektor – oder auch Meshed Society (Vernetzte Gesellschaft) – beschrieben wird. Die Abbildung zeigt deutlich, wie sich so eine Gesellschaft von der eher zentral ausgerichteten Gesellschaft unterscheidet.

„However, open source communities operate within a Fourth Sector or meshed society, distinct from these traditional models. The Fourth Sector consists of decentralised, community-driven initiatives where individuals and organisations collaborate to develop, maintain, and improve non-rivalrous digital goods. These initiatives do not conform to the conventional corporate structure assumed by regulatory frameworks“ (Philipps, S. (2026): Open Source and the Emerging Fourth Sector, in Eclips Foundation (2026): The Vital Role of Open Source in Europe, Whitepaper).

Diese Entwicklung hat sich von den Bürgern aus Bottom-Up entwickelt und sollte in den gesellschaftlichen Strukturen stärker berücksichtigt werden. Aktuell dominieren immer noch die Organisationen aus den ersten drei Sektoren, doch wird der Einfluss des 4. Sektors in Zukunft immer größer. Der Grund ist: Open Source bietet Möglichkeiten, sich aus den vielfältigen Abhängigkeiten zu lösen und dadurch z.B. eine Digitale Souveränität zu erreichen und als Gesellschaft resilienter zu werden. Wie das aussehen kann, skizziere auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn.

Die Titel meiner beiden Paper:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Künstliche Intelligenz: Der Kill Switch und Digitale Souveränität

Image by Gerd Altmann from Pixabay

Die Abhängigkeiten von US amerikanischen KI-Systemen führt zwangsläufig zu der berechtigten und aktuellen Frage: Was passiert, wenn der Zugang zu wichtigen und modernen KI-Systemen reduziert, oder gar verwehrt wird. Dass dieses Szenario nicht nur theoretisch, sondern praktisch besteht, hat die Anweisung der US Regierung den Zugang zu zu Fable 5 und Mythos 5 auszusetzen gezeigt.

„In der öffentlichen Diskussion ist der „Kill Switch“, also die Einschränkung oder Abschaltung digitaler Dienste für einzelne Personen, Organisationen oder sogar ganze Staaten, ein viel beachtetes Thema. Eine zentrale Rolle spielt dabei US-Präsident Donald Trump, der öffentlich damit gedroht hat, den Zugang zu US-Digitaldiensten, wie denen der Hyperscaler, einzuschränken oder vollständig zu sperren“ (Lünendonk-Studie 2026).

Wenn andere entscheiden, was wir tun dürfen ist das Fremdbestimmung, mit allen Konsequenzen. Wenn wir alles selbst machen könnten, wären wir autark. Zwischen beiden Polen ist die Souveränität (hier: Digitale Souveränität) anzusiedeln:

„Wir sind handlungsfähig und entscheiden selbst, was wir tun“ (ebd.).

Der oben erwähnte Kill Switch, oder auch die Möglichkeit eines Kill Switchs, sollten Treiber für einen selbstbestimmten, an europäischen Werten ausgerichteten offenen Zugang zu digitalen Systemen sein. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred, Ungarn, vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Kosten der Künstlichen Intelligenz: Anteil US amerikanischer KI-Modelle geht weltweit zugunsten von Open Source AI zurück

Image by chris s from Pixabay

Wir haben uns daran gewöhnt, dass die amerikanischen Tech-Konzerne mit ihren KI-Modellen den Ton angeben, doch in den letzten 12 Monaten hat sich weltweit erstaunliches getan. Nach Howard Yu (auf LinkedIn) ist der Anteil amerikanischer KI-Modelle in diesem Zeitraum von 70% auf 30% gefallen (routed traffic).

Der Grund ist, dass immer mehr Nutzer – auch aus Kostengründen – Open Source AI nutzen. Dazu haben beispielsweise chinesische Anbieter neben DeepSeek auch Qwen als erfolgreichstes Open Source AI Modell weltweit etabliert.

„The cause is, of course, price. Anthropic’s Claude costs $4,811 for a standard evaluation suite. OpenAI costs $3,357. DeepSeek costs $1,071. Zhipu’s GLM costs $544. The premium American model runs nearly 9 times the cheapest Chinese one for equivalent work. When AI shifted from chat to agents, that gap became impossible to ignore. An overnight coding run calls a model thousands of times“ (Yu, W. via LinkedIn, 08.07.2026).

Natürlich kommen zu so einer Meldung gleich (mindestens) zwei Einwände:

(1) Open Source AI Modelle sind nicht so Leistungsstark wie die proprietären, kommerziellen AI Modelle der amerikanischen Tech-Konzerne.
Das stimmt in der Zwischenzeit nicht mehr. Ausführlich hat das der AI Report 2026 von der Stanford University analysiert und dargestellt. Siehe dazu Die erfolgreiche Open Source KI Geschichte.

(2) Chinesische Modelle sind mit Vorsicht zu genießen, da sie auch den Vorgaben der chinesischen Regierung entsprechen müssen.
Ja, das ist der Fall. Ähnlich sieht es allerdings auch mit den amerikanischen Modellen aus, die den Mindsets der Tech-Konzerne entsprechen. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

Was also tun? Es bietet sich an, Open Source AI aus und für Europa zu nutzen. In der Zwischenzeit gibt es neben Mistral AI noch viele weitere Modelle, die schon genutzt werden können. Open Source AI mit europäischen Werten zu nutzen ist ein Weg zu mehr Digitaler Souveränität und sogar zur Kostenreduzierung.

Siehe dazu auch Wirtschaftlichkeit von KI-Agenten: Warum kommt es bei den Token-Kosten oft zu regelrechten Abrechnungsschocks?

Künstliche Intelligenz lässt die meisten Sprachen und kulturellen Besonderheiten außen vor

Image by Sunrise from Pixabay

Die bekannten proprietäten KI-Modelle funktionieren hauptsächlich in Englisch, oder in einer Handvoll anderer Sprachen. Am Beispiel agglutinierender Sprachen wie Ungarisch, Baskisch, etc. kann aufgezeigt werden, dass die üblichen KI-Modelle nicht ausreichen.

Es wundert daher nicht, dass in den letzten Jahren immer mehr KI-Modelle entwickelt wurden, die in europäischen Sprachen trainiert wurden. Beispiele dazu sind Teuken 7B und Open EuroLLM. Darüber hinaus gibt es in Europa auch schon viele KI-Modelle, die in der jeweiligen Landessprache trainiert wurden. Beispiele dazu sind das Ungarisches Modell, das Schwedisches Modell, das Italienische Modell usw.

Dass es in kritischen Bereichen wie dem Gesundheitswesen wichtig ist, bei KI-Modellen den sprachlichen und kulturellen Kontext zu beachten, wurde in einer Veröffentlichung der United Nations (UN) noch einmal beispielhaft hervorgehoben:

„In Tigrinya, spoken by 7 to 9 million people in Eritrea and northern Ethiopia, machine translation has rendered smallpox as syphilis, gonorrhoea as diabetes and “You have been given intravenous antibiotics” as “You have been given intravenous insecticides”. These mistranslations can be life-threatening. A recent review of natural language processing for African languages in healthcare found that, despite advances in multilingual AI tools, major challenges remain. These include cultural and linguistic bias, poor adaptation to medical contexts, limited explainability and translation errors that can affect diagnosis and treatment decisions. The evidence suggests that AI systems are not ready for use in high-stakes settings unless they have been properly adapted, constrained and tested for the relevant linguistic and cultural contexts“ (UN 2026).

Mit Hilfe von Small Language Models (SLM) und der Berücksichtigung sprachlicher und kultureller Besonderheiten einzelner Regionen in Europa können gerade Kleine und Mittlere Unternehmen (KMU) innovative Produkte und Dienstleistungen entwickeln, die einen Mehrwert für die Nutzer bieten.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in einem Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Mein zweites Paper:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework