Fünf neue KI-Modelle aus Europa in unsere Open Street Map aufgenommen

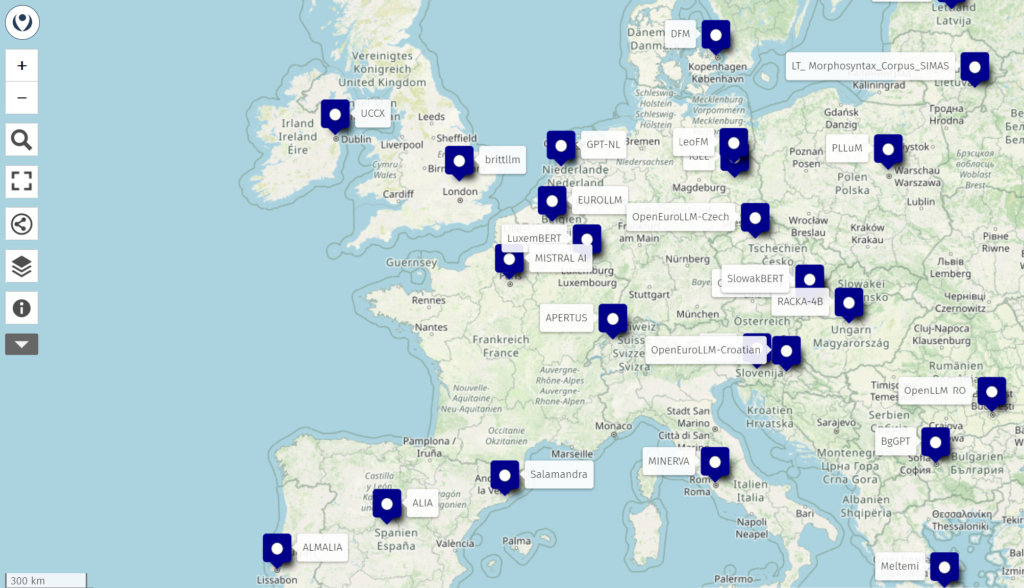
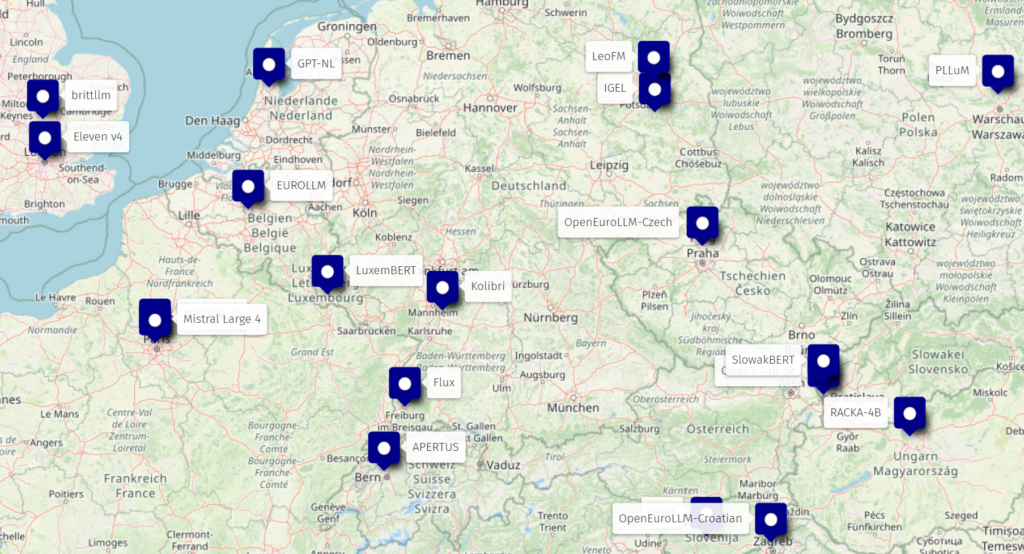
Ausschnitt aus der Open Street Map zu europäischen KI-Modellen
https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#6/49.952292/9.706089

Immer mehr KI-Modelle aus Europa kommen auf den Markt. Alleine vom 22. September bis 06.10.2026 wurden fünf neue Modelle veröffentlicht (KI-News von Thomas Ertl, 08.10.2026 auf LinkedIn).

In der folgenden Tabelle sind die Modelle, das Land und unter Bemerkungen, die Zugangsform (Open Source, Open Weight oder nur per API) angegeben. Die KI-Modelle sind direkt verlinkt.

KI-ModellLandBemerkung
KolibriAleph Alpha, Heidelberg, DeutschlandOpen Source
Flux 3 ActionBlack Forest Labs, Freiburg, DeutschlandOpen Weight
Flux 3 ImageBlack Forest Labs, Freiburg, DeutschlandAPI
Eleven v4ElevenLabs, London, UKAPI
Large 4Mistral, Paris, FrankreichOpen Weight
Europäische KI-Modelle, veröffentlicht im Zeitraum vom 22.09.-06.10.2026

Weiterhin haben wir diese Modelle in unsere Open Street Map mit aufgenommen, in der viele länderspezifische KI-Modelle zu finden sind. Die Map zeigt die dynamische Entwicklung in Europa, und den Trend zu mehr Digitaler Souveränität bei KI-Modellen.

Für die meisten Anwendungen ist es nicht erforderlich, das beste und größe Modell zu haben. Es geht vielmehr darum, ein KI-Modell zu nutzen, das vertrauenswürdig ist, in Europa gehostet wird und transparent zeigt, wie mit Daten umgegangen wird.

Ein gutes KI-System im Unternehmen schlägt dabei den Ansatz, alles im Unternehmen einem gigantischen KI-Modell wie Claude von Anthropic, Gemini von Google, ChatGPT von OpenAI etc. unterzuordnen. Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs. International Conference MCP 2026, 16.-19.09.2026, Balatonfüred, Hungary.

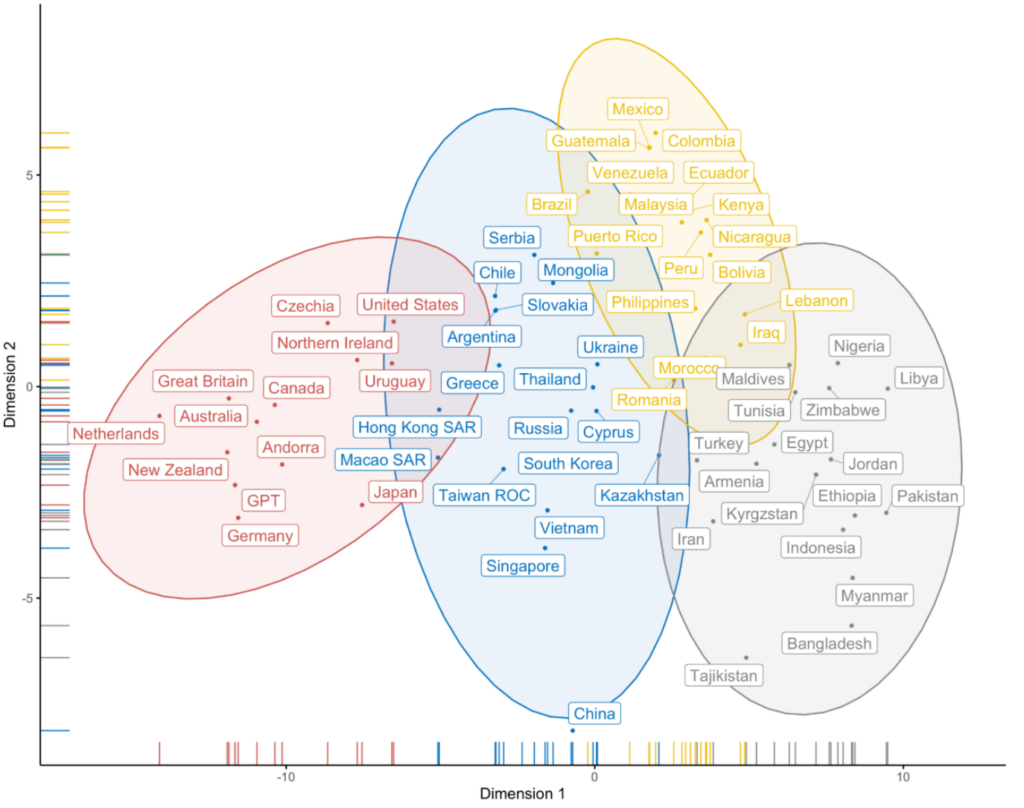
Künstliche Intelligenz: Welcher Mensch?

Atari et al. (2023): Which Human? [PDF]

Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.

In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).

Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.

Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.

https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154#5/46.052101/6.218511

Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

Der Perspektivenwechsel von Closed AI zu Local AI hat auch eine gesellschaftliche Komponente

Image by Ichigo121212 from Pixabay

Die großen Technologie-Konzerne bestimmen aktuell noch, wann welche Modelle verbessert werden, bzw. wann welche neuen Modelle auf den Markt kommen. Dabei haben wir am Beispiel Anthropic im April 2026 gesehen, dass auch mal Modelle nicht veröffentlicht werden – in dem Fall ging es um unkontrollierte KI-Agenten, die in Organisationen eingedrungen waren.

Big Tech entscheidet also, was wir als Nutzer zu sehen bekommen, und was nicht. Diese Asymmetrie zwischen den Nutzern und den Inhabern von großen Datenmengen führt zu einer sehr großen Macht der Big Tech, die diese natürlich auch über Lobbystrukturen auf politischer und gesellschaftlicher Ebene nutzen.

Manche Regionen der Welt haben verstanden, dass es erforderlich ist, im Sinne einer gesamtgesellschaftlichen positiven Nutzung der Möglichkeiten von Künstlicher Intelligenz, Grenzen zu setzen. Die Europäische Union hat das mit dem EU AI Act gemacht, und dafür ziemlich viel Kritik und Häme von Big Tech und der amerikanischen Administration erhalten. Dennoch ist festzustellen, dass eine Selbstregulierung der großen Tech-Unternehmen wohl nicht ausreichen wird, um negative gesellschaftliche Folgen der KI-Entwicklung abzumildern.

Neben der staatlichen/regionalen Eindämmung der negativen Auswüchse von Künstlicher Intelligenz, gibt es auch noch eine andere Möglichkeit, die Asymmetrie der Informationsbereitstellung und -Nutzung zu reduzieren: durch lokale Künstliche Intelligenz – Local AI.

At a fundamental level, local AI disrupts what has been called “algorithmic governance,” a phrase that describes how major technology companies (“Big Tech”) use their rmarket dominance to shape how information is accessed and how people connect in ways that influence the broader social order” (Just et al. 2017).

Just et al. (2017) sind somit der Auffassung, dass durch die Algorithmen der großen KI-Anbieter (Big Tech) Informationen nach deren Vorstellungen selektiert werden wodurch soziale Strukturen beeinflusst werden – die Autoren nennen das “algorithmic governance,” Demgegenüber kann Local AI auf gesellschaftlicher Ebene die Asymmetrie zwischen Big Tech und Governement überwinden.

Darüber hinaus ist die Verbindung von Local AI, Open Data und Open Source AI Modellen eine bemerkenswerte Chance, ein Stück Digitale Souveränität zurückzubekommen. Der AI Report 2026 der Stanford University zeigt hier deutlich auf, dass es weltweit einen Trend zu immer mehr Open Weight / Open Source KI-Modellen, und zu kleinen aber leistungsfähigen Modellen gibt, die sogar in der Zwischenzeit auf dem eigenen Laptop genutzt werden können (Edge Computing). Siehe dazu auch

Freund, R., Anisic, Z. (2026): Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Anisic, Z., Forza, C. (Eds): Proceedings of the 12th International Conference on Customization and Personalization, September 17-18, 2026, Balatonfüred, Hungary, pp. 86-95 · 17. Sep. 2026

Künstliche Intelligenz, die Jagd nach AGI und der Intelligenz-Quotient

AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.

Es ist erstaunlich, wie viele parallelen es zwischen dem Intelligenz-Quotienten (IQ) und den Entwicklungen bei Künstlicher Intelligenz gibt. Die großen Tech-Unternehmen versprechen immer mehr, dass die von ihnen entwickelten Large Language Models (LLMs) generelle Problemlöser sind, oder bald sein werden – ganz im Sinne von „One Size Fits All“.

Mich erinnert die Diskussion um so eine generelle künstliche Intelligenz (AGI: Artificial General Intelligence) an den lange propagierten allgemeinen Faktor (g-faktor) bei der menschlichen Intelligenz. Die Messbarkeit der menschlichen generellen Intelligenz erfolgt dabei mit Hilfe des bekannten Intelligenz-Quotienten, der seit über 100 Jahren in vielen gesellschaftlichen Bereichen genutzt wird. Diese Vorgehensweise passte perfekt zu der aufkommenden Industriegesellschaft, in der alles – wirklich alles – messbar gemacht wurde, auch wenn es möglicherweise gar nicht messbar war. Dann wurde es eben messbar gemacht.

Die folgende Beschreibung von AGI der Stanford University enthält allerdings auch kritische Anmerkungen.

„AGI stands for Artificial General Intelligence, which means an AI system with general, human-level (or beyond) ability to learn, reason, and apply knowledge across a wide range of tasks and domains. AGI systems conceivably could handle novel situations, not just perform well on a single, narrow task. The term is controversial in several ways, including that different people mean different things by „human-level intelligence,“ and there’s no universally accepted test, so claims are hard to verify. There are also safety and ethical concerns debated by AI experts“ (Source: Stanford University).

Der Hinweis auf ein unterschiedliches Verständnis darüber, was unter human-Level intelligence zu verstehen ist, macht deutlich, dass sich das über 100 Jahre alte Verständnis von Intelligenz weiterentwickelt, und den Begriff entgrenzt hat. Hinweise auf eine Emotionale Intelligenz oder auch eine Soziale Intelligenz usw. zeigen, wie vielfältig Intelligenz heute interpretiert wird. Das ist auch erforderlich, da die heutige komplexe Welt mit den Kennzahlen der Industriegesellschaft nicht mehr komplett beschreibbar ist.

Die von Howard Gardner vorgestellte Multiple Intelligenzen Theorie hat demgegenüber als erste diese verschiedenen Dimensionen von Intelligenz zusammengefasst, wobei Howard Gardner von Intelligenz als bio-psychologisches Potential eines Menschen ausgeht. Diese Entgrenzung des Intelligenzbegriffs hat eine bessere Passung mit der heutigen komplexen Wissens- oder Kompetenzgesellschaft.

Der Begriff Künstliche Intelligenz ist danach eher als eine Art Kategorienfehler anzusehen. Es wundert daher nicht, dass manche vorschlagen, eher von Künstlicher Cleverness zu sprechen und zu schreiben. Auch die Konzentration von Intelligenz in einem Wert (IQ oder irgendwann AGI-Faktor) wird der heutigen Sichtweise nicht gerecht. Warum wird es trotzdem propagiert?

Bei den ganzen Begrifflichkeiten wird deutlich, dass es je nach Betrachter darum geht, die Welt auf einem einzigen (Intelligenz-) Souverän zurückzuführen (IQ oder AGI), oder die Welt als multidimensionales Konstrukt zu interpretieren. Ich tendiere eher zum zweiten Ansatz, und stehe den Heilsversprechen der Tech-Konzerne kritisch gegenüber.

eTranslation: Das vertrauenswürdige Online-Übersetzungssystem der Europäischen Union

https://www.cor.europa.eu/en/etranslation

Wir haben uns in den letzten Jahren an die vielen Übersetzungsmöglichkeiten gewohnt, die die proprietären KI-Anbieter (Closed Models) anbieten. Es ist bequem, schnell und oft auch treffend in der jeweiligen Übersetzung.

Dennoch gibt es immer mehr Entwicklungen zu europäischen, nationalen oder sogar regionalen KI-Modellen, die die sprachlichen Besonderheiten und deren kulturellen Kontext besser berücksichtigen.

In einer Open Street Map habe ich viele dieser Modelle in einer Europa-Karte zusammengetragen und mit dem entsprechenden Links versehen.

Dieser Trend ist nicht alleine in Europa, sondern weltweit zu erkennen. Damit Übersetzungen in Europa vertrauenswürdig sind, hat die Europäische Union eTranslate zur Verfügung gestellt. Das System können schon sehr viele Organisationen, und auch Kleine und Mittlere Unternehmen (KMU) nutzen – Privatpersonen leider noch nicht.

„eTranslation is currently available to EU institutions, national public administrations, local and regional authorities, small and medium-sized enterprises, academia, non-governmental organisations, and Digital Europe Programme (DEP) projects, in the European Union and in countries affiliated with DEP. EPSO candidates can also use eTranslation during the recruitment process“ (eTranslation, 07.09.2026).

Ich halte das Angebot für einen wichtigen Schritt zu mehr Digitaler Souveränität in der Europäischen Union. Auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) gehe ich mit zwei Präsentationen auf solche Themen ein.

Digitale Souveränität: Immer mehr junge Menschen interessieren sich für Open Source Anwendungen

Gerade bei jungen Menschen ist es angesagt, die bekannten proprietären Software-Anwendungen zu nutzen. Man zeigt, dass man IN ist, wenn man als junger Mensch beispielsweise die neuen KI-Modelle der großen Tech-Konzerne nutzen kann. Man glaubt, damit auch bessere Chancen auf dem Arbeitsmarkt zu haben.

In der Zwischenzeit gibt es allerdings in der Gesellschaft durchaus auch ein Umdenken in Richtung Open Source Anwendungen. Der Grund ist, die technologische, digitale Abhängigkeit Europas von den USA und China, die zu vielfältigen Problemen führen kann (Kill Switch). Siehe dazu auch Digitale Souveränität: Europa, USA und China im Vergleich.

Europa ist daher seit einiger Zeit auf dem Weg zu einer eigenen Digitalen Souveränität, die natürlich nicht von heute auf morgen erreichbar ist. Dennoch ist dieser Schritt erforderlich und basiert auf Open Source Anwendungen.

Es fehlen allerdings Kompetenzen zu Open Source Software und Open Source Hardware (Skill Shortage), da sich in der Vergangenheit zu wenige Menschen für diese Themen interessiert haben. Für viele überraschend, begeistern sich heute immer mehr junge Menschen für Open Source Lösungen.

„Denn junge, gut ausgebildete IT-Expert:innen haben immer öfter kein Interesse daran, sich auf eine intransparente Blackbox-Anwendung zu spezialisieren. Stattdessen ist ihr Interesse an Open-Source-Lösungen gestiegen, ebenso wie der Anspruch, mit der eigenen Arbeit nicht nur zu wirtschaftlichem Erfolg sondern auch zum Gemeinwohl beizutragen“ OSBA (2026): Open Source ist Schlüsselrolle für Staat und Wirtschaft.

Da immerhin 264 Milliarden Euro von europäischen Organisationen pro Jahr für nicht-europäische Technologien ausgeben werden, entsteht in Zukunft ein großer Markt, wenn wir mehr auf europäische Technologien setzen. Alleine wenn nur 30% von 264 Milliarden Euro in den kommenden Jahren ersetzt werden könnten, wären das auf europäischer Ebene fast 80 Milliarden Euro pro Jahr – mit steigender Tendenz.

EU Score: KI-Modelle und Open Source Anwendungen aus europäischer Sicht bewerten

https://eu-score.tech/

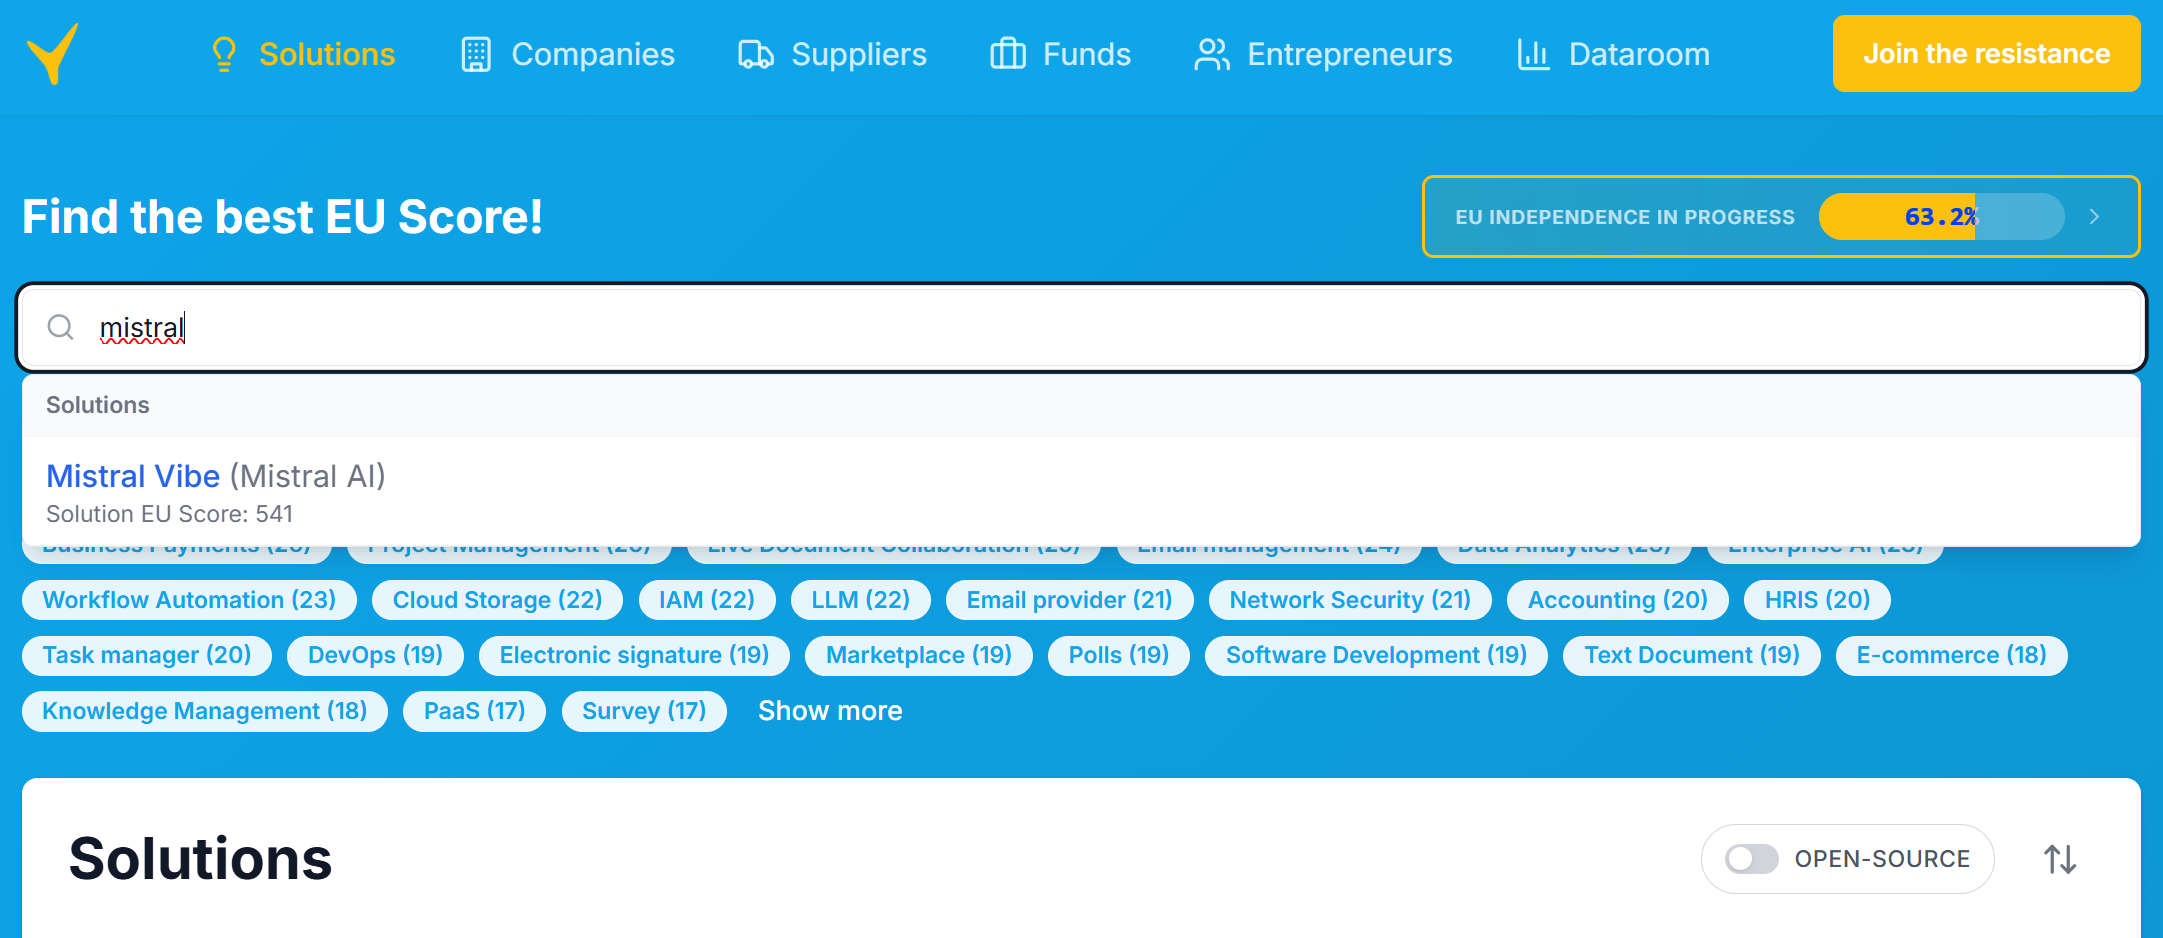
Es ist nicht ganz einfach, sich ein Bild von den ganzen KI-Möglichkeiten zu verschaffen. Es ist erforderlich, eine bestimmte Perspektive einzunehmen, um Bewertungen vorzunehmen. Die Plattform EU Score hat in 2025 damit angefangen, immer mehr Anwendungen aus dem Tech-Umfeld aus der Perspektive der Europäischen Union zu bewerten.

Die Dimensionen sind Population Sovereignty Equity Sovereignty, Supplier Sovereignty, Value Sovereignty und Webserver Sovereignty. Aus den einzelnen Zahlen wird dann ein Gesamtwert für die Souveränität der Europäischen Union ermittelt. In der Abbildung ist oben rechts ein gelb hinterlegter Wert von über 63,2% zu zu sehen.

Wenn ich in das Suchfeld „mistral“ eingebe (Abbildung), erscheint für Mistral Vibe (Mistral AI) der EU Score 541. Wenn ich in das Suchfeld „claude“ von Antropic eingebe, erhalte ich den EU Score 1. Das ist jetzt kein Schreibfehler! Die Unterschiede zwischen den beiden KI-Modellen sind aus europäischer Sicht frappierend. Ähnlich ist es auch bei dem Vergleich von Microsoft Office und Nextcloud usw.

Die Plattform ist eine interessanter Einstieg, um sich die großen Unterschiede zwischen den angebotenen Markt-Alternativen klar zu machen. In der Abbildung ist rechts unten weiterhin zu erkennen, dass man auch nur Open Source Anwendungen betrachten und analysieren kann.

Eine Paper zur Methode habe ich bisher allerdings nicht gefunden. Für Außenstehende wäre eine fundierte wissenschaftliche Begründung und Ableitung der verwendeten Methode klarer und transparenter, was wiederum mehr Vertrauen schaffen würde. It all starts with trust!

Dennoch halte ich die Plattform für ein geeignetes Instrument, für sich selbst, für Organisationen eine Diskussionsgrundlage für die eigene Digitale Souveränität zu schaffen.

Digital Resilience Index für die eigene Organisation ermitteln

https://digitalresilienceinitiative.org/en#piliers

Über Digitale Souveränität habe ich in unserem Blog schon viel geschrieben. Dabei sollte es Ziel sein, die Organisation resilienter gegenüber äußeren Einflüssen zu machen. In der Zwischenzeit stürzen sich die Berater auf das Thema, obwohl sie noch vor kurzer Zeit den Einsatz bekannter, proprietärer Anwendungen „verkauft“ haben – Digital Sovereignty Washing kann man das wohl nennen.

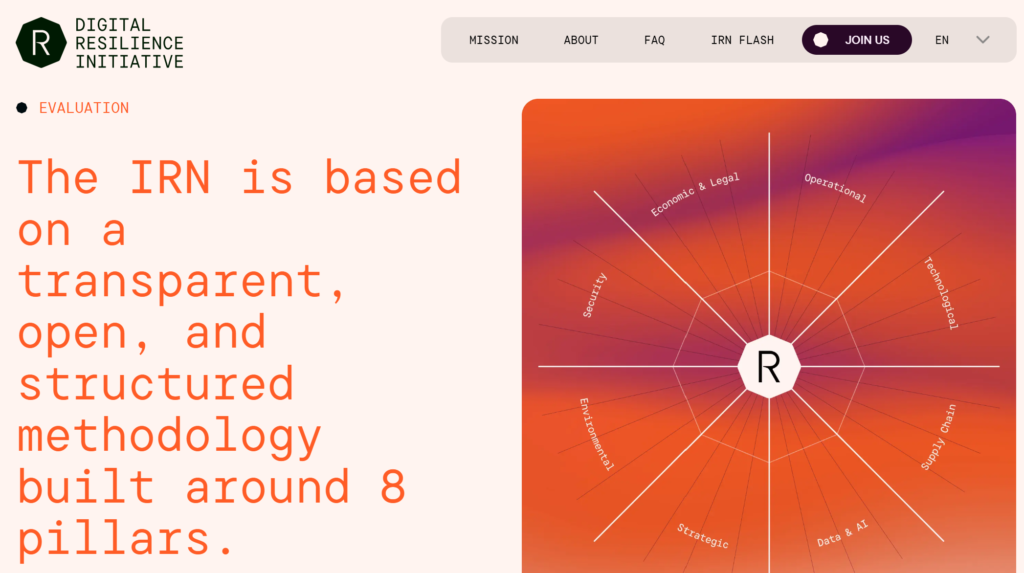
Die Digital Resilience Initiative ist laut eigenen Angaben „eine Non-profit association in the process of registration“ [01.09.2026]. Sie bieten eine offene und strukturierte Methode an, Digitale Resilienz anhand von 8 Dimensionen und 5 Layer zu analysieren. Wie die Abbildung zeigt, werden die Ergebnisse dann anhand von entsprechenden Grafiken angezeigt.

Grundsätzlich finde ich das einen guten Ansatz, doch ist es gerade für Kleine und Mittelständische Unternehmen (KMU) oft unklar, an welchen Stellen begonnen werden sollte. Immerhin ist ja, je nach Perspektive, alles wichtig.

Ich favorisiere an dieser Stelle eher ein Wirkungsnetz für das spezifische KI-System der Organisation, das ähnlich wie bei der Wissensbilanz-Toolbox aufgebaut ist. daraus können dann entsprechende Generatoren abgeleitet werden, die die Ressourcen der KMU schonen und trotzdem auf das Geschäftsergebnis ausgerichtet sind. Siehe dazu KI-System im Mittelstand: Von der Wissensbilanz lernen.

Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Um das 30-fache unterscheiden sich je nach KI-Modell die Tokens – und damit die Kosten

https://longjubai.github.io/agent_token_consumption/

Wenn es um die Wirtschaftlichkeit von KI-Agenten geht, kommt es bei den Token-Kosten oftmals zu regelrechten Abrechnungsschocks. In ihrem Paper

Bai et al (2026): How Do Coding Agents Spend Your Money? Analyzing and Predicting Token Consumptions in Agentic Coding Tasks | https://arxiv.org/abs/2604.22750

haben die Forscher genauer untersucht, wie die Coding Agenten das Geld der Nutzer „ausgeben“. Ich möchte an dieser Stelle nur eine der vielen Erkenntnisse aus dem Paper wiedergeben: Es gibt wohl bei dem gleichen Task Unterschiede bis zum 30-fachen bei der Anzahl der Tokens – und damit der Kosten.

„(…) token usage is highly variable and inherently stochastic: runs on the same task can differ by up to 30× in total tokens, and higher token usage does not translate into higher accuracy; instead, accuracy often peaks at intermediate cost and saturates at higher
costs“ (Bai et al. 2026).

Gerade Kleine und Mittlere Unternehmen (KMU) mit ihren doch eher begrenzten Ressourcen sollten hier aufpassen.

Interessanterweise haben die Forscher zu ihrem ausführlichen Paper auch eine Website mit den wichtigsten Erkenntnissen erstellt. Dort ist wiederum ein kleines Spiel integriert, bei dem man anhand einer Problemstellung die voraussichtlich benötigten Token und die damit verbundenen Kosten schätzen kann – spannend.

Wir empfehlen auch aus diesen Gründen eher Local AI – also lokal ausgeführte Open Source KI-Modelle zu nutzen. Das kann zusammen mit einer Microsoft Alternative wie Nextcloud auf einem eigenen Server geschehen, oder als Edge Computing sogar mit Hilfe geeigneter Apps wie Ollama und Langflow, auf dem eigenen Laptop. In unserem Blog finden Se dazu viele Beiträge.

Solche Ansätze können die Innovationsfähigkeit gerade von KMU unterstützen, indem sie ein unternehmensspezifisches KI-System nutzen, bei dem alle generierten Daten beim Unternehmen bleiben – ganz im Sinne einer Digitalen Souveränität.

Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

264 Milliarden Euro geben europäische Organisationen pro Jahr für nicht-europäische Technologien aus

Image by Willfried Wende from Pixabay

Es ist bekannt, dass alleine der Bund pro Jahr ca. 500 Millionen Euro alleine an Microsoft-Lizenzen bezahlt. Weniger bekannt ist, dass auf der europäischen Ebene die Beträge sehr viel höher sind, wenn wir digitale Technologien insgesamt betrachten. Es sind sage und schreibe 242 Milliarden Euro, die europäische Organisationen pro Jahr für nicht-europäische Technologien ausgeben. Auf der Seite von EuroCommons sind dazu insgesamt 11 kritische Komponenten genannt.

€264bn spent every year by European organisations on non-European digital technologies.

A call to large European public and private organisations and to open source vendors to join collective working groups — coalitions — to plan, prepare, finance and execute concrete migrations away from proprietary software dependencies. Together. In project mode. With peers facing the same problems.

Source: EuroCommons (abgerufen am 26.08.2026)

Es ist natürlich weltfremd, wenn man von heute auf morgen alle technologischen Abhängigkeiten durch europäische Lösungen ersetzen wollte, doch wird seit einiger Zeit mehr umgesetzt, als man es noch vor wenigen Jahren gedacht hat.

Wie wäre es, wenn man auf europäischer Ebene nur 50% der 264 Milliarden Euro, also immerhin 132 Milliarden Euro, in europäische Technologie investieren würde?

Beispielsweise ersetzen immer mehr Open Source Lösungen wie Nextcloud, OnlyOffice usw. die bekannten Microsoft-Produkte und auch auf der Ebene der Künstlichen Intelligenz gibt es sehr viele europäische, ja sogar länderspezifische Open Source KI-Modelle. etc. Siehe dazu auch Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen.

Neben der wirtschaftlichen Komponente ist allerdings auch ein möglicher Kill Switch ein bedeutender Treiber für die Entwicklung zur Digitalen Souveränität.

„In der öffentlichen Diskussion ist der „Kill Switch“, also die Einschränkung oder Abschaltung digitaler Dienste für einzelne Personen, Organisationen oder sogar ganze Staaten, ein viel beachtetes Thema. Eine zentrale Rolle spielt dabei US-Präsident Donald Trump, der öffentlich damit gedroht hat, den Zugang zu US-Digitaldiensten, wie denen der Hyperscaler, einzuschränken oder vollständig zu sperren“ (Lünendonk-Studie 2026).

Durch die Nutzung von Open Source Anwendungen im Rahmen europäischer Werte und Normen können neue, innovative Ansätze entstehen, die sich von den chinesischen und US-amerikanischen Vorgehen unterscheiden. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred (Ungarn) vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework