Wussten Sie, dass die Codebasis von Software zu 97% aus Open Source Software besteht?

Image by Pexels from Pixabay

Es ist erstaunlich, dass es vielen Privatpersonen, Unternehmen und Öffentlichen Verwaltungen immer noch schwer fällt, sich von den kommerziellen Software-Angeboten zu lösen, um Digitale Souveränität zu erreichen Der Grund ist oftmals eine Gewöhnung an die jeweiligen Tools und damit auch eine gewisse Abhängigkeit.

Ein Wechsel zu Open Source Software wäre für viele mit Aufwand verbunden. Solche Switching Cost sind mit der Zeit von den etablierten Software-Unternehmen nach und nach immer weiter erhöht worden. Siehe dazu auch Es ist so bequem, unmündig zu sein.

Darüber hinaus gibt es auch Vorbehalte gegenüber Open Source Software, obwohl die Codebasis von Software sage und schreibe zu 97% Open Source Software enthält – auch kommerzielle Software.

„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).

Wenn also fast alle Software zu einem so großen Anteil aus Open Source Software in ihrer Codebasis bestehen, sollten sich alle einmal überlegen, ob die Vorbehalte gegenüber Open Source Software heute noch angebracht sind.

In der Zwischenzeit erkennen immer mehr Personen, Unternehmen und Öffentliche Verwaltungen, dass der Nutzen von Open Source Software die Kosten deutlich übersteigt.

Auch zeigt die erfolgreiche Open Source KI Geschichte, dass Open Source sogar auf dem Gebiet der Künstlichen Intelligenz wettbewerbsfähig ist.
Auf der internationalen Konferenz  MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in zwei Paper ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

KIMI 3: Open Source AI – sehr leistungsfähig, allerdings mit regulativen chinesischen Einschränkungen

Das bild ist mit Mistral AI generiert

Am 12. November 2025 habe ich in einem Blogbeitrag auf KMI 2 Thinking hingewiesen. Nach DeepSeek R1 war KIMI 2 ein weiteres chinesisches Modell das aufgezeigt hatte, dass es möglich ist ein leistungsfähiges Open Source KI-Modell zu entwickeln, das viel weniger Ressourcen – und damit Kosten – erfordert. Der Schwerpunkt des von KIMI 2 Thinking liegt dabei auf „Coding“.

Nun ist mit KIMI 3 ein weiteres Open Source KI-Modell für den 27.07.2026 angekündigt. Wenn man es genau nimmt, ist es ein Open Weight Modell, da die Trainingsdaten nicht frei verfügbar sind. Der Schwerpunkt liegt bei dem Modell wieder auf Coding, allerdings auch auf Knowledge Work (Wissensarbeit).

„Kimi K3 is the first open-source model to reach 2.8 trillion parameters.“ Source: KIMI Platform, accessed 19.07.2026).

In dem Beitrag Moonshot AI zeigt Kimi K3: Open- Source-KI aus China (IT Business vom 17.07.2026 wird auf die Leistungsfähigkeit des Modells hingewiesen („Vorsprung der USA auf chinesische KI-Labore mittlerweile auf nur noch sechs bis neun Monate geschmolzen“).

Weiterhin musss allerdings auch kritisch angemerkt werden, dass chinesische KI Modell (Open Source AI oder nicht) den Vorgaben der chinesischen (und amerikanischen ) Administration unterliegen. In China sind beispielsweise Beiträge zu Taiwan oder zum Tiananmen-Platz usw. reglementiert. Solche Restriktionen schränken die Qualität der generierten Antworten deutlich ein.

Die Chance von Europa ist, Open Source KI-Modelle zu entwickeln, die auch einen niedrigen Ressourcenbedarf haben, ein ähnliches oder bessres Leistungsniveau wie die chinesischen open source Modelle haben, und letztendlich den europäischen Werten entsprechen.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
SOOFI S: Das erste Modell für industrielle KI in Europa – Open Source

Quelle::.https://www.soofi.info/

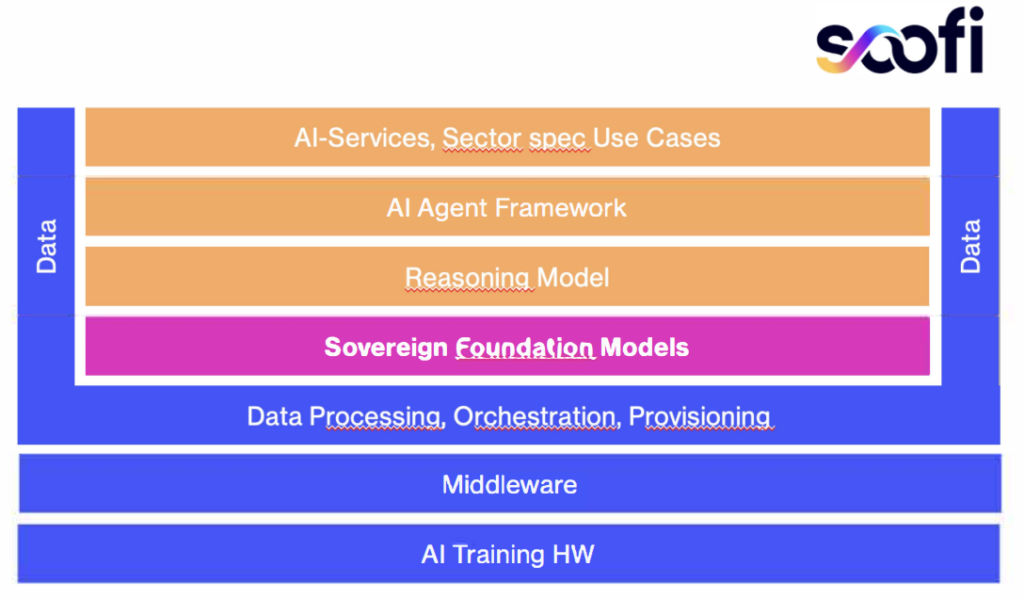
Auf das Projekt SOOFI (Sovereign Open Source Foundation Models) hatte ich schon am 26.11.2025 hingewiesen. Zu der Zeit wurde das Projekt in einer Pressemitteilung erst angekündigt. In der Zwischenzeit ist mit SOOFI S das erste Modell für industrielle KI in Europa veröffentlicht worden.

Das Modell ist auf englische und deutsche Texte ausgelegt und ein 30B Mixture-of-Experts-Modell. Dabei wird für den jeweiligen Input das geeignete Experten-Modell ausgewählt, um einen qualitativ hochwertigen Output zu generieren. Die folgende Abbildung zeigt die Intergration des Souvereign Foundation Models in das Gesamtkonzept.

Quelle: https://www.soofi.info/

Aktuell wird das SOOFI S Modell in industriellen Anwendungen getestet. Die dabei gemachten Erfahrungen fließen in das Modell ein. Eine Veröffentlichung zur allgemeinen Nutzung ist daher noch nicht erfolgt.

SOOFI S ist ein weiteres positives Beispiel für ein europäisches Open Source Foundation Model, das es Unternehmen in der Zukunft ermöglichen wird, ihre Abhängigkeiten von US amerikanischen oder chinesischen Modellen zu reduzieren. Dadurch werden die Organisationen digital souveräner und letztendlich auch resilienter.

Siehe dazu auch Die erfolgreiche Geschichte von Open Source KI zeigt, wie dieser Weg aussehen kann. Digitale Souveränität: Europa, USA und China im Vergleich.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auch auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Künstliche Intelligenz: Der Kill Switch und Digitale Souveränität

Image by Gerd Altmann from Pixabay

Die Abhängigkeiten von US amerikanischen KI-Systemen führt zwangsläufig zu der berechtigten und aktuellen Frage: Was passiert, wenn der Zugang zu wichtigen und modernen KI-Systemen reduziert, oder gar verwehrt wird. Dass dieses Szenario nicht nur theoretisch, sondern praktisch besteht, hat die Anweisung der US Regierung den Zugang zu zu Fable 5 und Mythos 5 auszusetzen gezeigt.

„In der öffentlichen Diskussion ist der „Kill Switch“, also die Einschränkung oder Abschaltung digitaler Dienste für einzelne Personen, Organisationen oder sogar ganze Staaten, ein viel beachtetes Thema. Eine zentrale Rolle spielt dabei US-Präsident Donald Trump, der öffentlich damit gedroht hat, den Zugang zu US-Digitaldiensten, wie denen der Hyperscaler, einzuschränken oder vollständig zu sperren“ (Lünendonk-Studie 2026).

Wenn andere entscheiden, was wir tun dürfen ist das Fremdbestimmung, mit allen Konsequenzen. Wenn wir alles selbst machen könnten, wären wir autark. Zwischen beiden Polen ist die Souveränität (hier: Digitale Souveränität) anzusiedeln:

„Wir sind handlungsfähig und entscheiden selbst, was wir tun“ (ebd.).

Der oben erwähnte Kill Switch, oder auch die Möglichkeit eines Kill Switchs, sollten Treiber für einen selbstbestimmten, an europäischen Werten ausgerichteten offenen Zugang zu digitalen Systemen sein. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

Wie so etwas für innovative Kleine und Mittlere Unternehmen (KMU) in Europa in Bezug auf Künstliche Intelligenz aussehen kann, stelle ich in zwei Paper auf der MCP-Konferenz 2026, vom 16.-19.09.2026 in Balatonfüred, Ungarn, vor:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

FSFE: Free Software Foundation Europe

Quelle: https://fsfe.org/

Auf dem Weg zu mehr Digitaler Unabhängigkeit, oder Digitaler Souveränität, kommt Open Source Software eine besondere Rolle zu. Neben der amerikanischen Free Software Foundation hat sich dazu in 2001 die Free Software Foundation Europe e. V. gegründet (Quelle: Wikipedia). Der europäische Blick auf Open Source Software ist wichtig, da dieser sich von der US amerikanischen und der chinesischen Perspektive unterscheidet. Siehe dazu Digitale Souveränität: Europa, USA und China im Vergleich.

„Software ist in allen Aspekten unseres Lebens tief verankert. Freie Software gibt allen das Recht, Programme für jeden Zweck zu verwenden, zu verstehen, zu verbreiten und zu verbessern. Diese Rechte stärken andere Grundrechte wie die Redefreiheit, die Pressefreiheit und das Recht auf Privatsphäre“ (FSFE-Website).

Interessant ist, dass die FSFE ganz bewusst von Freier Software ausgeht und sich damit von Open Source etwas abgrenzen möchte. Der Grund ist, dass der Begriff Open Source in den letzten Jahren immer wieder missbräuchlich verwendet wurde, und es zu einer Art „Verwässerung“ oder „Open Washing“ kam – wie das Beispiel von OpenAI zeigt.

In unseren Beiträgen geht es oft um Open Source, da dieser Begriff den meisten Lesern besser bekannt ist – auch wenn der Hinweis von der FSFE natürlich berechtigt ist.

Open Source Software bietet nicht nur aus wirtschaftlichen Gründen Möglichkeiten, sondern stärkt auch demokratische Grundrechte in Gesellschaften – was gerade in Zeiten von Künstlicher Intelligenz immer wichtiger wird. Siehe dazu auch Die erfolgreiche Open Source KI Geschichte.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in zwei Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Künstliche Intelligenz lässt die meisten Sprachen und kulturellen Besonderheiten außen vor

Image by Sunrise from Pixabay

Die bekannten proprietäten KI-Modelle funktionieren hauptsächlich in Englisch, oder in einer Handvoll anderer Sprachen. Am Beispiel agglutinierender Sprachen wie Ungarisch, Baskisch, etc. kann aufgezeigt werden, dass die üblichen KI-Modelle nicht ausreichen.

Es wundert daher nicht, dass in den letzten Jahren immer mehr KI-Modelle entwickelt wurden, die in europäischen Sprachen trainiert wurden. Beispiele dazu sind Teuken 7B und Open EuroLLM. Darüber hinaus gibt es in Europa auch schon viele KI-Modelle, die in der jeweiligen Landessprache trainiert wurden. Beispiele dazu sind das Ungarisches Modell, das Schwedisches Modell, das Italienische Modell usw.

Dass es in kritischen Bereichen wie dem Gesundheitswesen wichtig ist, bei KI-Modellen den sprachlichen und kulturellen Kontext zu beachten, wurde in einer Veröffentlichung der United Nations (UN) noch einmal beispielhaft hervorgehoben:

„In Tigrinya, spoken by 7 to 9 million people in Eritrea and northern Ethiopia, machine translation has rendered smallpox as syphilis, gonorrhoea as diabetes and “You have been given intravenous antibiotics” as “You have been given intravenous insecticides”. These mistranslations can be life-threatening. A recent review of natural language processing for African languages in healthcare found that, despite advances in multilingual AI tools, major challenges remain. These include cultural and linguistic bias, poor adaptation to medical contexts, limited explainability and translation errors that can affect diagnosis and treatment decisions. The evidence suggests that AI systems are not ready for use in high-stakes settings unless they have been properly adapted, constrained and tested for the relevant linguistic and cultural contexts“ (UN 2026).

Mit Hilfe von Small Language Models (SLM) und der Berücksichtigung sprachlicher und kultureller Besonderheiten einzelner Regionen in Europa können gerade Kleine und Mittlere Unternehmen (KMU) innovative Produkte und Dienstleistungen entwickeln, die einen Mehrwert für die Nutzer bieten.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in einem Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Mein zweites Paper:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

IW Consult (2026): Digitale Souveränität von KMU (Kurzstudie)

Image by Gerd Altmann from Pixabay

Zu dem Thema Digitale Souveränität gerade bei Kleinen und Mittleren Unternehmen (KMU habe ich schon viele Blogbeiträge geschrieben. In der Zwischenzeit wird vielen klar, dass das Thema wichtig ist, sodass es immer mehr ausführliche oder kleine Studien gibt. Ein weiteres Beispiel dafür ist die nun veröffentlichte Kurzstudie IW Consult (2026): Digitale Souveränität von KMU (PDF), in der 5 zentrale Erkenntnisse zusammengefasst wurden:

(1) Digitale Souveränität ist eine Managemententscheidung.

(2) Tragfähige europäische Alternativen sind verfügbar.

(3) Die Umstellung auf souveräne Lösungen ist machbar, aber voraussetzungsreich.

(4) Anschaffungskosten allein greifen bei der Bewertung der Wirtschaftlichkeit zu kurz..
Eine TCO (Total Cost of Ownership)-Betrachtung, welche die laufenden Kosten, versteckte Bindungseffekte und Migrationsaufwände einbezieht, verändert die wirtschaftliche Bewertung digitaler Lösungen grundlegend.

(5) Die Unterstützungslandschaft hat eine solide Basis, aber auch noch Ausbaupotenziale.

Auf der internationalen Konferenz MCP 2026, die vom 16.-19.09.2026 in Balatonfüred, Ungarn stattfinden wird, gehe ich darauf in einem Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Mein zweites Paper:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

User-Centric Personalization mit dem Human Context Protocol (HCP)

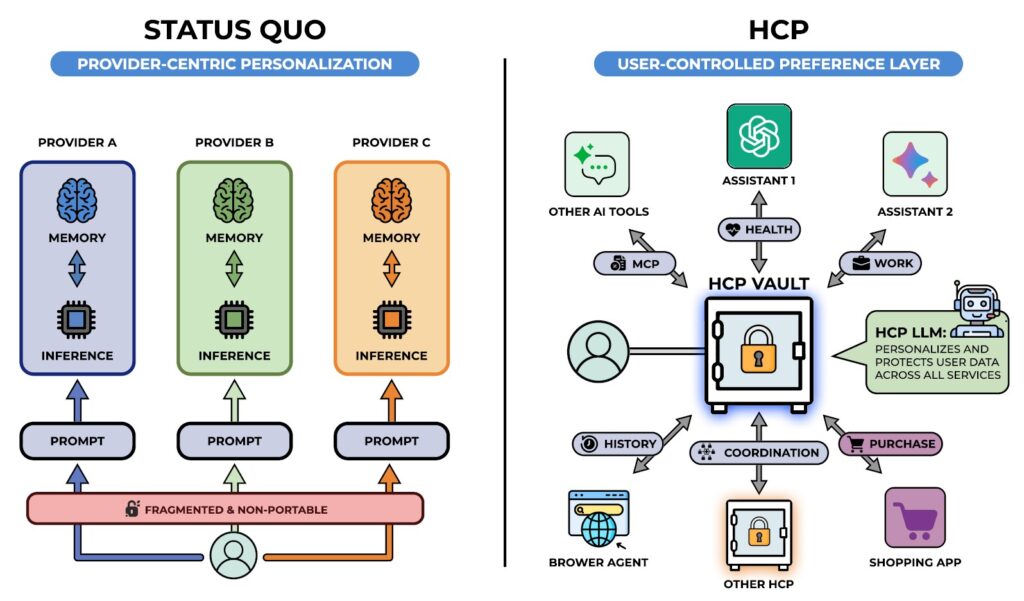
Illustration of two personalization paradigms (Shah et al., 2025)

Es ist schon erstaunlich, wie wir mit unseren Daten umgehen. Viele bestätigen die verschiedenen Richtlinien der Anbieter einfach, da sie (die Nutzer) die ganzen Bestimmungen gar nicht lesen, geschweige denn verstehen können. Das wiederum führt dazu, dass die jeweiligen Anbieter Nutzer-Daten teilweise, oder recht umfangreich, speichern und nutzen. Einerseits geschieht das, um die Nutzung zu vereinfachen – das Nennen die Provider dann Personalization-, wobei Kontext-Informationen des Users gewonnen werden. Darüber hinaus werden alle User-Daten noch für „andere Zwecke“ verwendet, die ein User gar nicht mehr überblicken kann.

In der Abbildung ist auf der linken Seite zu erkennen, was bei unterschiedlichen Anbietern (Providern) mit User-Prompts passiert. Jeder Provider baut seine Personalisierung gegenüber dem User auf (Provider-Centric Personalization), wobei die Daten und Kontext-Informationen beim Provider gespeichert werden. Diese Informationen über die Personalisierung sind nicht einfach auf andere Provider übertragbar, was dem jeweiligen Provider nicht interessiert. In diesem System hat der User kaum alternative Möglichkeiten.

Auf der rechten Seite der Abbildung ist ein ganz anderer Personalisierungs-Ansatz zu erkennen, der den User in den Mittelpunkt stellt (User-Controlled Preference Layer). Die Daten eines Users und der jeweilige Kontext werden in einem HCP Vault (einer Art Daten-Tresor) gespeichert, und können verschiedenen Systemen zur Verfügung gestellt werden. Bei diesem Ansatz müssen natürlich alle anderen Anwendungen über definierte Schnittstellen verbunden werden können – hier kommt das HCP (Human Context Protocol) ins Spiel..

„On the right panel, a shared preference layer is introduced in which user context is stored in a centralized HCP vault and selectively accessed by multiple assistants, tools, and applications through an HCP-mediated interface. User preference data (generated by varied user activity) is moderated by HCP to consumer agents. Each agent obtains only the relevant subset of the user’s complete preference data“ (Shah et al., 2025).

Diese Entwicklung unterstützt den Trend, dass User über ihre eigenen Daten und die damit verbundenen Kontext-Informationen selbst bestimmen können, was gerade in Zeiten von Künstlicher Intelligenz immer wichtiger wird. Siehe dazu auch Was wäre, wenn jeder über seine generierten Daten selbst entscheiden könnte?

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf ein: Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework.

Schutzrechte: Alles fing mit einem Lastkahn für Marmorblöcke an

Image by Gianluca from Pixabay

Wir haben uns daran gewöhnt, dass es verschiedene Schutzrechte gibt, die auf dem Markt durchgesetzt werden können. Schaut man sich beispielsweise die Geschichte des Patents dazu etwas genauer an, so muss man allerdings feststellen, dass es Schutzrechte für Erfindungen erst seit dem 18. Jahrhundert gibt. Augenscheinlich haben die Menschen vor dieser Zeit auch Möglichkeiten gefunden, mit dem Thema umzugehen.

„Das erste überlieferte Patent für eine industrielle Erfindung wurde 1421 an den Architekten und Ingenieur Filippo Brunelleschi vergeben. Es gab ihm für drei Jahre das Monopol, einen Lastkahn mit einer Winde herzustellen, der für den Transport von Marmorblöcken verwendet wurde. Im Laufe der folgenden zwei Jahrhunderte breiteten sich solche Privilegien für Erfinder von Italien über Europa aus. (…) Schutzrecht für eine Erfindung gab es erst im 18. Jahrhundert“ (Grassmuck, 2004).

In der Zwischenzeit sind es nicht nur die klassischen Schutzrechte einer industriell geprägten Gesellschaft (siehe dazu DPMA), sondern auch immer mehr die Urheberrechte, die gerade in Verbindung mit den Trainingsdaten von KI-Modellen kontrovers diskutiert werden. In dieser Übergangsphase entstehen rechtlich Graubereiche, die von dynamischen Geschäftsmodellen rigoros ausgenutzt werden.

Es wird sich zeigen, ob wir eine angemessene Lösung finden, die die Rechte aller Beteiligten beachtet, oder ob wir uns eher in eine Gesellschaft hineinbewegen, in der nicht mehr, sondern eher weniger geschützt wird. Manche Entwicklungen wie die von Open Source, Open Science, Open Data, Open Government, Open Innovation usw. zeigen Wege auf, wie das aussehen könnte. Siehe dazu auch Quack, Sigrid und Leonhard Dobusch (2011): Auf dem Weg zur Wissensallmende? In: Aus Politik und Zeitgeschichte 28-30/2011, S. 41-46.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in einem Paper ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Mein zweites Paper:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs
Unternehmen sind gut darin, Ideen zu zerstören

Diese Aussage im Blogtitel habe ich in einem Interview gefunden, das mit dem finnischen Professor Alf Rehn schon in 2014 geführt wurde. Darin macht er deutlich, dass es genügend Ideen in den Unternehmen gibt, diese es allerdings schaffen, viele davon zu zerstören, und dadurch Innovationen verhindern.

„Viele Leute glauben, das Problem sei die Menge an Ideen oder das Fehlen von Ideen. Ich kenne Hunderte von Unternehmen, die sagen, sie haben nicht genug Ideen. Aber das ist völlig falsch. Ich habe noch nie einen Betrieb kennengelernt, dem es an Ideen mangelte, niemals, nirgends – und ich habe schon mit den langweiligsten Unternehmen des Planeten zusammengearbeitet. Der Punkt ist vielmehr: Sie sind unglaublich gut darin, Ideen zu zerstören. Sie sind so gut darin, dass sie es nicht einmal merken“ (Interview mit dem finnischen Professor Alf Rehn. In: „Unternehmen sind gut darin, Ideen zu zerstören“, Haufe Online vom 13.10.2014).

Heute können Ideen mit Künstlicher Intelligenz in großer Anzahl generiert und ausgewählt werden. Letztendlich wird das Unternehmen allerdings im Abgleich mit den eigenen Ressourcen und den zu erzielenden Gewinnen entscheiden, ob sie eine Idee umsetzt, oder eben nicht. Dadurch entsteht ein begrenzter Innovationsraum.

Anders sieht es bei einzelnen Usern aus, die seit ca. 2007 (nach Mota, 2011) immer besser in der Lage sind, Ideen auch selbst umzusetzen. Solche Open User Innovation (Eric von Hippel) entgrenzen Innovationen von den Unternehmen und stellen eine bedeutende Möglichkeit dar, endlich das herzustellen, was benötigt wird. Siehe dazu auch Innovationen: Das Europäische Paradox.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) stelle ich dazu ein Paper vor:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Mein zweites Paper:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs