KI-Agenten: Agents of Chaos?

https://agentsofchaos.baulab.info/

Nach den großen KI-Sprachmodellen (LLM: Large Language Models), den kleineren Modellen (SLM: Small Language Models), den Mixed of Experts (MoE) Models sind seit einiger Zeit KI-Agenten im Fokus der Anbieter, Anwender und Forscher.

Nach dem ersten Hype um KI-Agenten mit Aussagen wie „KI Agenten ersetzen Mitarbeiter“ oder „KI-Agenten erhöhen die Produktivität“ usw. ist in der Zwischenzeit eine gewissen Ernüchterung eingetreten.

Ein Grund sind die unbestimmbaren Kosten von KI Agenten (Tokens). Siehe dazu Wirtschaftlichkeit von KI-Agenten: Warum kommt es bei den Token-Kosten oft zu regelrechten Abrechnungsschocks?

Ein weiterer Aspekt ist, dass die KI-Agenten eine Eigendynamik entwickeln, die von den Tech-Konzernen nicht mehr kontrolliert werden kann. Dazu haben Sie sicherlich auch in den einschlägigen Medien die Berichte über KI-Agenten gelesen, die „von sich aus“ andere Unternehmen und Organisationen gehackt haben. Beispielhaft sei hier nur die Meldung von der Tagesschau vom 22.07.2026 genannt: KI von OpenAI steuert eigenständig Hackerangriff – und nein, das ist kein Einzelfall.

Dass Unternehmen so sorglos mit dieser Entwicklung umgehen ist bemerkenswert, denn: Wer trägt den angerichteten Schaden? Möglicherweise entsteht der Schaden auch noch viel später und kann gar nicht mehr auf die Ursache zurückgeführt werden. Die in der Softwarebranche übliche Vorgehensweise, unfertige Software auf den Markt zu bringen und durch die Anwendung der Nutzer zu optimieren, ist im Zusammenhang mit KI-Agenten nicht sehr intelligent.

In der Forschungslandschaft haben schon viele Forscher auf die Tücken von KI-Agenten hingewiesen, doch werden solche Erkenntnisse oftmals von den Tech-Konzernen als störend für das Geschäftsmodell empfunden. Es ist allerdings die Aufgabe von Forschern, ohne Rücksicht auf die ohnehin einseitigen wirtschaftlichen Interessen von Unternehmen, auf wichtige Erkenntnisse hinzuweisen.

Beispielhaft möchte ich dazu die folgende Veröffentlichung nennen. Die Ergebnisse zeigen, wie chaotisch und teilweise gefährlich die Zusammenarbeit der KI-Agenten verlief.

„Observed behaviors include unauthorized compliance with non-owners, disclosure of sensitive information, execution of destructive system-level actions, denial-of-service conditions, uncontrolled resource consumption, identity spoofing vulnerabilities, cross-agent propagation of unsafe practices, and partial system takeover“ (Shapira, N. et al. 2026 Agents of Chaos. Available from https://arxiv.org/abs/2602.20021).

Auf Basis guter wissenschaftlicher, transparenter und nachvollziehbarer Arbeit, haben die Forscher auf der dazugehörenden Website (Abbildung) die Vorgehensweise, die verwendeten KI-Agenten und die generierten Daten veröffentlicht. Es kann sich somit jeder ein eigenes Bild von dem Chaos der Agenten machen. Nicht umsonst heißt der Titel der Veröffentlichung und der dazugehörenden Website Agents of Chaos.

Es wäre gut, wenn einzelne Personen, Unternehmen und Öffentliche Verwaltungen nicht blind den Marketingversprechen der Konzerne folgen, sondern auch wissenschaftliche Erkenntnisse in ihre Entscheidungen zu KI einbeziehen würden.
Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf solche Zusammenhänge ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Open Source Software Country Intelligence Report Germany 2026

https://interoperable-europe.ec.europa.eu/sites/default/files/inline-files/germany-2026-osor-country-report.pdf

Deutschland entwickelt sich immer mehr zum Treiber beim Einsatz von Open Source Software in Europa. Der nun veröffentlichte Report der Europäischen Kommission stellt die verschiedenen Aktivitäten übersichtlich und strukturiert dar. Interessant dabei ist, dass gerade Öffentliche Verwaltungen als Vorbilder für den sinnvollen Einsatz von Open Source Software hervorgehoben werden.

„At the local level, states and cities have played a consistent role in advancing open source adoption, often ahead of the federal government. Schleswig-Holstein has been a leading example, developing a clear open source strategy that other states have drawn on. Thüringen and Munich are also significant actors. Munich’s trajectory is particularly notable: the city was an early adopter of open source software, before going back to proprietary software in 2017. Munich has since come back to open source software to reduce dependencies and strengthen its digital autonomy, reflecting a broader shift in political and practical conditions“
Source: European Commission (2026) Open Source Software Country Intelligence Report Germany 2026 | PDF

Die stärkere Nutzung von Open Source Software sollte der erste Schritt sein, sich von den kommerziellen Anwendungen etablierter Tech-Konzerne unabhängiger zu machen. Wie wir wissen, ist das schon für viele eine große Hürde, da sich Personen und Organisationen in eine Pfadabhängigkeit begeben haben. Der Aufwand, sich nun Open Source zuzuwenden, ist nicht wegzudiskutieren, doch übersteigt der Nutzen von Open Source Software die Kosten deutlich.

Weiterhin sollte berücksichtigt werden, dass Open Source Software auch bedeutet, mehr Open Source AI (Open Source Künstliche Intelligenz) einzusetzen. Es macht keinen Sinn, für die Standardabläufe in der Organisation auf Open Source Software zu setzen, und weiterhin proprietäre KI-Modelle zu nutzen. Siehe dazu auch Die erfolgreiche Open Source KI Geschichte.

Es geht somit darum, auf der persönlichen Ebene, auf der Teamebene und auf der organisationalen Ebene ein auf Open Source basierendes Gesamtsystem zu nutzen, um Digitale Souveränität, und damit verbunden eine gewisse Resilienz gegenüber dem turbulenten Umfeld zu erzielen.

Auf der MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
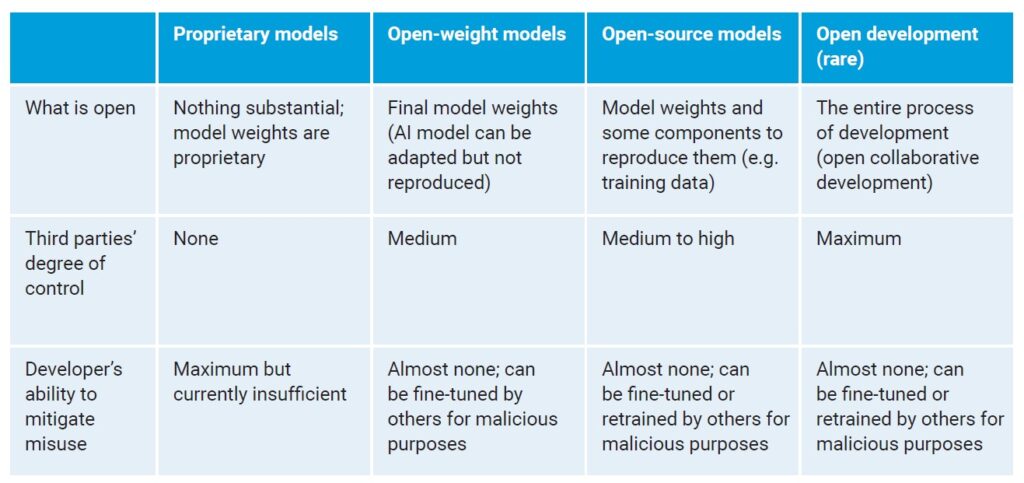
KI-Modelle: Kategorien im Vergleich

UN (2026) Preliminary Report of the Independent International Scientific Panel on AI
https://www.un.org/independent-international-scientific-panel-ai/en/preliminary-report

In dem Beitrag Das Kontinuum zwischen Closed Source AI und Open Source AI hatte ich darauf hingewiesen, dass es zwischen den Polen Closed Source AI (Proprietary Models) und Open Source AI ein Kontinuum gibt. In der Abbildung ist dazu beispielhaft die Kategorie Open Weight AI Models positioniert.

Alleine der Vergleich dieser drei Kategorien zeigt, dass Open Source Models im Vergleich zu den dominierenden Proprietary Models und Open Weight Models erhebliche Vorteile haben. Es wundert daher nicht, dass in den letzten Jahren ein deutlicher Trend zu Open Source AI Models zu erkennen ist. Dominiert wird der Markt allerdings (noch) von den KI-Modellen, die von großen Unternehmen entwickelt wurden.

„Business-led development. The development of frontier, general-purpose AI models is dominated by a small number of private firms with massive computing resources. In 2025, 91% of notable AI models originated from the private sector. Consequently, many decisions about training data, safeguards, deployment thresholds, model access and capability release sit inside private firms“ (UN 2026).

Interessant an der Abbildung oben ist, dass noch eine weitere Spalte zu erkennen ist: Open Development AI Models. Diese Kategorie ist (noch) sehr selten, obwohl gerade dieser Ansatz die größten gesellschaftlichen Vorteile verspricht. In Europa haben wir in dieser Richtung mit EuroLLM, Teuken 7B oder auf SOOFI vielversprechende Entwicklungen. Siehe dazu auch Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen.

Auf der internationalen Konferenz MCP 2026, 16.-19.09.2026, Balatonfüred, Ungarn gehe ich auf diese Zusammenhänge in zwei meiner Paper ein.

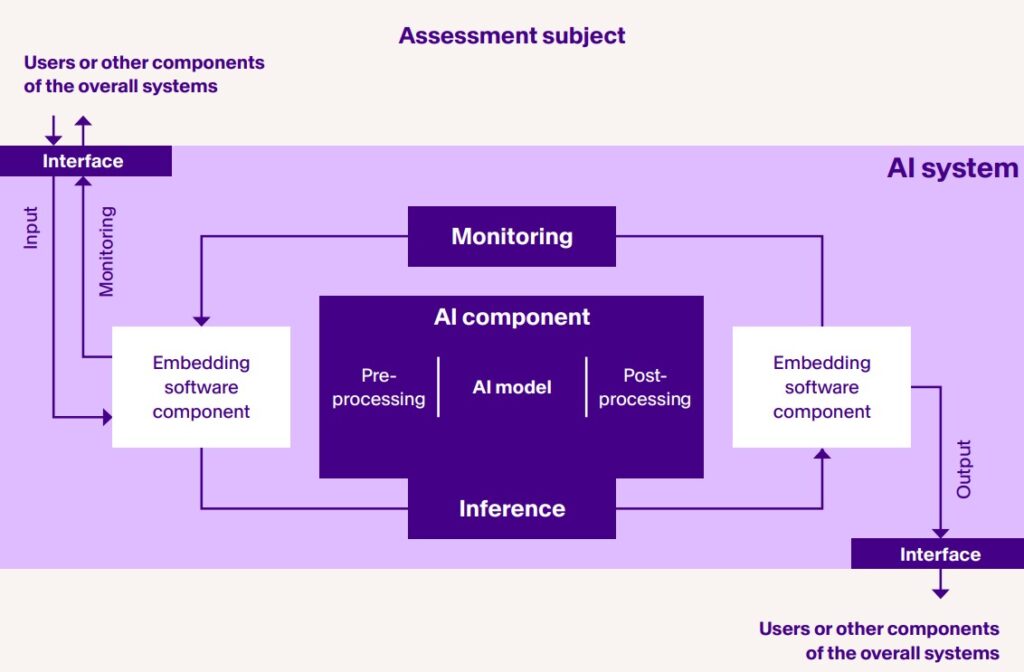
MISSION KI: Wie vertrauenswürdig sind KI-Modelle?

Abstract structure and delineation of an AI system. Source: Fraunhofer IAIS Assessment Catalogue (2021) (MISSION AI 2025)

Es gibt Millionen von KI-Modellen bei denen manchmal nicht klar ist, ob man ihnen als Privatperson, als Unternehmen oder als Öffentliche Verwaltung trauen kann. Denn: It all starts with trust.

Image by Gerd Altmann from Pixabay

Wenn dem so ist, stellt sich natürlich gleich die Frage, wie Vertrauenswürdigkeit bei KI-Modellen eingeschätzt und bewertet werden kann.

Zunächst einmal muss so eine Vorgehensweise von neutralen Stellen und nicht von den Unternehmen selbst durchgeführt werden. Auch die Kriterien sollten natürlich transparent und offen sein.

Solche Initiativen gibt es seit einigen Jahren auf internationaler und nationaler Ebene. International befasst sich die IEEE 8000.1 Working Group mit der Vertrauenswürdigkeit von Künstlicher Intelligenz. In Deutschland ist es seit 2023 die MISSION AI, die ein entsprechendes Rahmenwerk entwickelt.

„It combines established approaches (VDE SPEC 90012, Fraunhofer IAIS Prüfkatalog, Joint Specification for Trustworthy AI Systems) into an integrated assessment framework“ (MISSION KI).

In der Veröffentlichung MISSION KI (2025) Quality Standard for Low-Risk AI (PDF) werden Vorgehensweise, Kriterien usw. auf mehr als 100 Seiten ausführlich erläutert.

Auf der internationalen Konferenz MCP 2026, 16.-19.09.2026, Balatonfüred, Ungarn gehe ich auf diese Zusammenhänge in zwei meiner Paper ein.

Digitale Souveränität in Deutschland: Von der Einstellung zur Umsetzung – eine deutliche Kehrtwende in Zahlen

Es ist schon erstaunlich, wie schnell sich alles ändern kann. Vor mehreren Jahren, als ich auf Konferenzen die Digitale Abhängigkeit von amerikanischen Tech-Konzernen gerade bei der Nutzung von Künstlicher Intelligenz angesprochen hatte, wurde der Hinweis eher belächelt.

In der Zwischenzeit ist in Europa der Gedanke einer Digitalen Souveränität nicht nur als neue Einstellung angekommen, sondern ist in vielen Bereichen schon zu erkennen, dass die Einstellung in Handlungen umgesetzt werden. Das ist nicht eine von mir formulierte Wunschvorstellung, sondern kann in der Zwischenzeit durch aktuelle Zahlen bestätigt werden.

„Digitale Souveränität wandelt sich innerhalb eines Jahres von einer Frage der Einstellung zu einer Frage der Umsetzung. Fast doppelt so viele Unternehmen in Deutschland befinden sich 2026 aktiv in der Einführung europäischer Software-Lösungen: 39,7 Prozent gegenüber 20,4 Prozent im Vorjahr. Der Anteil derer, die einen Wechsel innerhalb der nächsten sechs Monate planen, steigt von 3,9 Prozent auf 20,4 Prozent um über 400 Prozent. Gleichzeitig bricht der Anteil der Entscheider, die keine europäische Software einführen wollen, von 47,7 auf 4,6 Prozent fast komplett ein. Die Zahl der Unentschlossenen sinkt von 17,4 auf 3,9 Prozent. Eine klare Kehrtwende“  MYRA Security GmbH (2026) Unchartered Waters. State of Digital Sovereignty 2026 (PDF).

Siehe dazu auch  Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen und Skill shortage: Es fehlen Kompetenzen zu Open Source Software und Open Source Hardware.

Auf der internationalen Konferenz MCP 2026, 16.-19.09.2026, Balatonfüred, Ungarn gehe ich auf diese Zusammenhänge in zwei meiner Paper ein.

Künstliche Intelligenz und das Internationale Seerecht: Vom Mare Clausum zum Mare Liberum

Image by Christine JAMIN from Pixabay

In der Veröffentlichung MYRA Security GmbH (2026) Unchartered Waters. State of Digital Sovereignty 2026 (PDF) habe ich eine interessante Analogie gefunden, die ich hier in eigenen Worten wiedergeben möchte, obwohl Analogien / Vergleiche immer etwas hinken.

Wenn man sich mit dem Begriff der Souveränität beschäftigt, kann man bis zum 16. Jahrhundert zurückgehen. Dabei ging es zunächst um die Rolle des Souverän als Gewaltmonopol, mit Bodin (1530–1596) als Vordenker. Doch gibt es auch einen Bezug zu Souveränität, wenn wir uns die Entwicklung des Seerechts ansehen.

Durch die globale Vernetzung über die Weltmeere kam es schon im 15. Jahrhundert immer wieder zu Auseinandersetzungen, obwohl sich Spanien und Portugal in dieser Zeit im Vertrag von Tordesillas (1494) die Weltmeere aufgeteilt hatten. Es waren dabei zwei souveräne Meere entstanden, die von dem jeweiligen Land beansprucht wurden. In diesem Sinne kam es also zu jeweils geschlossenen Meeren: Lateinisch: Mare Clausum – Englisch: Closed Sea.

Um die dadurch immer wieder auftretenden Konflikte zu lösen, schlug Hugo Grotius vor, die Meere als offene Meere zu sehen, die allen zur Verfügung stehen sollten. Er veröffentlichte „1609 die Schrift Mare Liberum, die das niederländische Begehren eines freien Handels zur See unterstützt und juristisch begründet“ (Quelle: Wikipedia). Lateinisch: Mare Liberum – Englisch: Open Sea. „Der Teil der Weltmeere, der außerhalb einer Dreimeilenzone lag (Seemeile, 1852 m), galt als internationales Gewässer“ (Internationale Gewässer).

„Damals stand Mare Clausum – das geschlossene Meer – gegen Mare Liberum. Europa will keine Isolation und keinen „Konflikt“ gegen amerikanische oder asiatische Technologie. Es will verhindern, dass kritische digitale Infrastruktur faktisch in fremden Hoheitszonen gefangen bleibt. Die Forderung Europas nach digitaler Souveränität bedeutet in diesem Sinne dasselbe, was Grotius damals forderte: offene Räume, faire Regeln und echte Wahlfreiheit. Freiere digitale Weltmeere für eine neue Generation von Händlern“ (MYRA Security GmbH, 2026).

Ich kann mir hier die Analogie zu Closed Source AI und Open Source AI nicht verkneifen, auch wenn der Vergleich etwas hinkt. Dennoch: Open Source AI ist der zukunfsträchtigere Weg, Künstliche Intelligenz für alle Nationen und ihren Menschen nutzbar zu machen.

Es sollte nicht sein, dass das Machtmonopol nur bei einigen Wenigen liegt, die rein kommerzielle und kaum gesellschaftliche Interessen verfolgen. Das Beispiel des Seerechts zeigt auf, dass es sinnvoll ist, geschlossene Räume zu öffnen. Siehe dazu auch Open Source AI: Besser für einzelne Personen, Organisationen und demokratische Gesellschaften.

Auf der internationalen Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei meiner Paper ein.

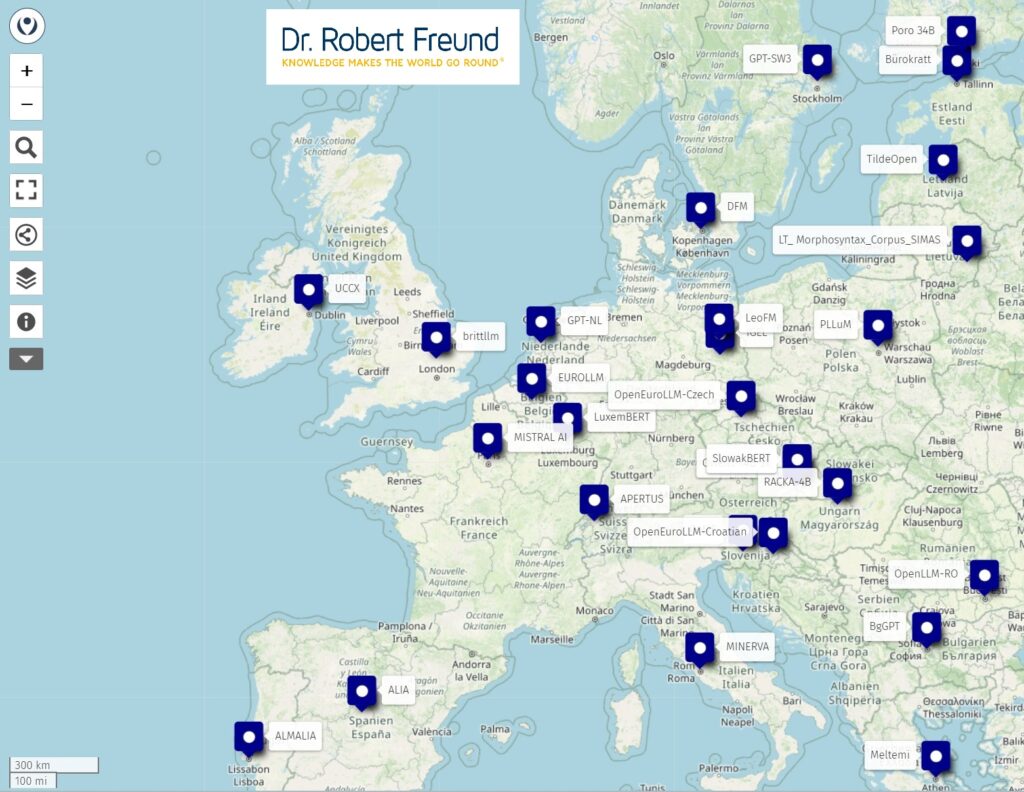
Open Street Map: Europäische Open Source KI Modelle in den jeweiligen Landessprachen

Eigene Open Street Map: https://umap.openstreetmap.de/de/map/open-source-ai-in-europe_148154

In den letzten Monaten habe ich über viele Open Source KI-Modelle in Europa geschrieben, die in der (oder den) spezifischen Landessprachen trainiert wurden. Die Links zu den jeweiligen Modellen habe ich nun zusammen mit dem Hinweis auf meinen dazugehörenden Blogbeitrag in Open Street Map (bewusst nicht in Google Maps) in einer eigenen Karte eingetragen (Abbildung).

Den Marker für ein Modell ist der Landeshauptstadt zugeordnet. Modelle, die alle europäischen Sprachen berücksichtigen, sind mit einem Marker auf Brüssel versehen.

Klicken Sie auf das Bild und Sie kommen direkt zu meiner angelegten Open Street Map.

Die erste Übersicht zeigt deutlich, wie vielfältig die Landschaft für Open Source KI-Modelle in Europa geworden ist. Ich bin sicher, die Modelle werden in Zukunft immer mehr von Privatpersonen, Kleinen und Mittleren Unternehmen (KMU), oder Öffentlichen Verwaltungen genutzt, da Transparenz (Offene Modelle), kulturelle Bezug (Landestypische Sprache) und die geringen Kosten (frei verfügbar) starke Argumente sind.

Wenn bei der Auswahl der KI-Modelle noch hinzukommt, dass Digitale Souveränität und Resilienz immer wichtiger werden, geht kein Weg an europäischen Open source KI-Modellen vorbei.

Auf der internationalen Konferenz MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich auf diese Zusammenhänge in zwei Paper ein:

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Wussten Sie, dass die Codebasis von Software zu 97% aus Open Source Software besteht?

Image by Pexels from Pixabay

Es ist erstaunlich, dass es vielen Privatpersonen, Unternehmen und Öffentlichen Verwaltungen immer noch schwer fällt, sich von den kommerziellen Software-Angeboten zu lösen, um Digitale Souveränität zu erreichen Der Grund ist oftmals eine Gewöhnung an die jeweiligen Tools und damit auch eine gewisse Abhängigkeit.

Ein Wechsel zu Open Source Software wäre für viele mit Aufwand verbunden. Solche Switching Cost sind mit der Zeit von den etablierten Software-Unternehmen nach und nach immer weiter erhöht worden. Siehe dazu auch Es ist so bequem, unmündig zu sein.

Darüber hinaus gibt es auch Vorbehalte gegenüber Open Source Software, obwohl die Codebasis von Software sage und schreibe zu 97% Open Source Software enthält – auch kommerzielle Software.

„According to the 2025 Black Duck Open Source Security and Analysis Report, 97% of codebases scanned contained open source software“ (Carlber, A. N (2026) Open Source in Europe Amid Geopolitical Tensions, in Eclipse Foundation).

Wenn also fast alle Software zu einem so großen Anteil aus Open Source Software in ihrer Codebasis bestehen, sollten sich alle einmal überlegen, ob die Vorbehalte gegenüber Open Source Software heute noch angebracht sind.

In der Zwischenzeit erkennen immer mehr Personen, Unternehmen und Öffentliche Verwaltungen, dass der Nutzen von Open Source Software die Kosten deutlich übersteigt.

Auch zeigt die erfolgreiche Open Source KI Geschichte, dass Open Source sogar auf dem Gebiet der Künstlichen Intelligenz wettbewerbsfähig ist.

Auf der internationalen Konferenz  MCP 2026 (16.-19.09.2026, Balatonfüred, Ungarn) gehe ich darauf in zwei Paper ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

KIMI 3: Open Source AI – sehr leistungsfähig, allerdings mit regulativen chinesischen Einschränkungen

Das bild ist mit Mistral AI generiert

Am 12. November 2025 habe ich in einem Blogbeitrag auf KMI 2 Thinking hingewiesen. Nach DeepSeek R1 war KIMI 2 ein weiteres chinesisches Modell das aufgezeigt hatte, dass es möglich ist ein leistungsfähiges Open Source KI-Modell zu entwickeln, das viel weniger Ressourcen – und damit Kosten – erfordert. Der Schwerpunkt des von KIMI 2 Thinking liegt dabei auf „Coding“.

Nun ist mit KIMI 3 ein weiteres Open Source KI-Modell für den 27.07.2026 angekündigt. Wenn man es genau nimmt, ist es ein Open Weight Modell, da die Trainingsdaten nicht frei verfügbar sind. Der Schwerpunkt liegt bei dem Modell wieder auf Coding, allerdings auch auf Knowledge Work (Wissensarbeit).

„Kimi K3 is the first open-source model to reach 2.8 trillion parameters.“ Source: KIMI Platform, accessed 19.07.2026).

In dem Beitrag Moonshot AI zeigt Kimi K3: Open- Source-KI aus China (IT Business vom 17.07.2026 wird auf die Leistungsfähigkeit des Modells hingewiesen („Vorsprung der USA auf chinesische KI-Labore mittlerweile auf nur noch sechs bis neun Monate geschmolzen“).

Weiterhin musss allerdings auch kritisch angemerkt werden, dass chinesische KI Modell (Open Source AI oder nicht) den Vorgaben der chinesischen (und amerikanischen ) Administration unterliegen. In China sind beispielsweise Beiträge zu Taiwan oder zum Tiananmen-Platz usw. reglementiert. Solche Restriktionen schränken die Qualität der generierten Antworten deutlich ein.

Die Chance von Europa ist, Open Source KI-Modelle zu entwickeln, die auch einen niedrigen Ressourcenbedarf haben, ein ähnliches oder bessres Leistungsniveau wie die chinesischen open source Modelle haben, und letztendlich den europäischen Werten entsprechen.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework

Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs

SOOFI S: Das erste Modell für industrielle KI in Europa – Open Source

Quelle::.https://www.soofi.info/

Auf das Projekt SOOFI (Sovereign Open Source Foundation Models) hatte ich schon am 26.11.2025 hingewiesen. Zu der Zeit wurde das Projekt in einer Pressemitteilung erst angekündigt. In der Zwischenzeit ist mit SOOFI S das erste Modell für industrielle KI in Europa veröffentlicht worden.

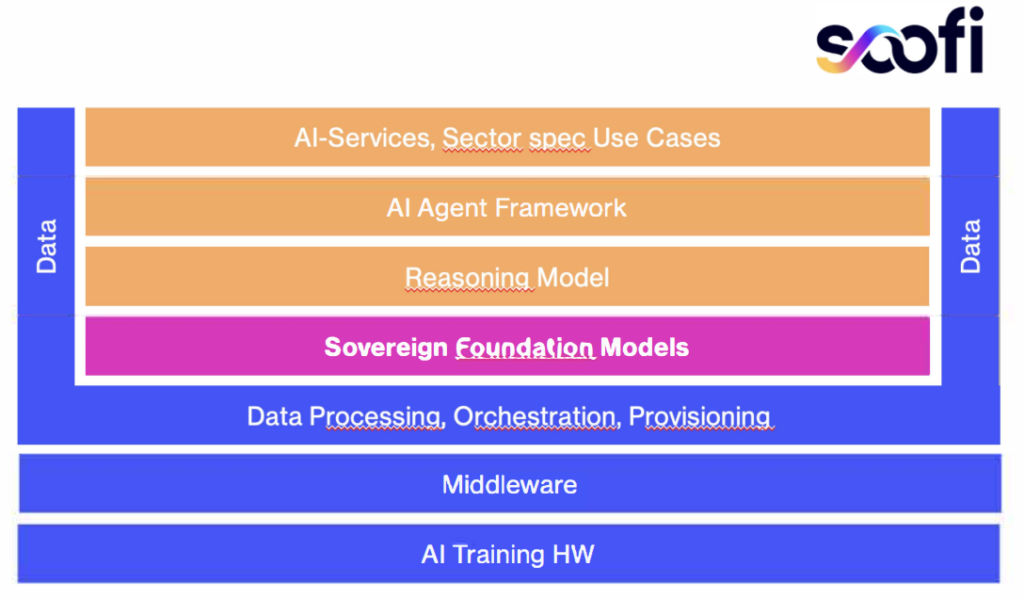
Das Modell ist auf englische und deutsche Texte ausgelegt und ein 30B Mixture-of-Experts-Modell. Dabei wird für den jeweiligen Input das geeignete Experten-Modell ausgewählt, um einen qualitativ hochwertigen Output zu generieren. Die folgende Abbildung zeigt die Intergration des Souvereign Foundation Models in das Gesamtkonzept.

Quelle: https://www.soofi.info/

Aktuell wird das SOOFI S Modell in industriellen Anwendungen getestet. Die dabei gemachten Erfahrungen fließen in das Modell ein. Eine Veröffentlichung zur allgemeinen Nutzung ist daher noch nicht erfolgt.

SOOFI S ist ein weiteres positives Beispiel für ein europäisches Open Source Foundation Model, das es Unternehmen in der Zukunft ermöglichen wird, ihre Abhängigkeiten von US amerikanischen oder chinesischen Modellen zu reduzieren. Dadurch werden die Organisationen digital souveräner und letztendlich auch resilienter.

Siehe dazu auch Die erfolgreiche Geschichte von Open Source KI zeigt, wie dieser Weg aussehen kann. Digitale Souveränität: Europa, USA und China im Vergleich.

Auf der MCP-Konferenz 2026, 16.-19.09.2026 in Balatonfüred, Ungarn, gehe ich auch auf solche Entwicklungen ein:

Open-Source AI for Open User Innovation: Designing a Personal Fabrication Framework
Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs