In den letzten Jahren wird immer deutlicher, dass Künstliche Intelligenz unser wirtschaftliches und gesellschaftliches Leben stark durchdringen wird. Dabei scheint es so zu sein, dass die Künstliche Intelligenz der Menschlichen Intelligenz weit überlegen ist. Beispielsweise kann Künstliche Intelligenz (GenAI) äußerst kreativ sein, was in vielfältiger Weise in erstellten Bildern oder Videos zum Ausdruck kommt. In so einem Zusammenhang behandeln wir Künstliche Intelligenz (AI: Artificial Intelligence) wie Kreative und im Gegensatz dazu Menschen eher wie Roboter. Dazu habe ich folgenden Text gefunden:
„We are treating humans as robots and ai as creatives. it is time to flip the equation“ (David de Cremer in Bornet et al. 2025).
David de Cremer ist der Meinung, dass wir die erwähnte „Gleichung“ umstellen sollten. Dem kann ich nur zustimmen, denn das aktuell von den Tech-Giganten vertretene Primat der Technik über einzelne Personen und sogar ganzen Gesellschaften sollte wieder auf ein für alle Beteiligten gesundes Maß reduziert werden. Damit meine ich, dass die neuen technologischen Möglichkeiten einer Künstlichen Intelligenz mit den Zielen von Menschen/Gesellschaften und den möglichen organisatorischen und sozialen Auswirkungen ausbalanciert sein sollten.
Dennoch ist deutlich zu erkennen, dass es immer mehr Anbieter in allen möglichen Segmenten von Künstlicher Intelligenz – auch bei den Language Models – gibt. Wenn man sich alleine die Vielzahl der Modelle bei Hugging Face ansieht: Heute, am17.09.2025, stehen dort 2,092,823 Modelle zur Auswahl, und es werden jede Minute mehr. Das erinnert mich an die Diskussionen auf den verschiedenen (Welt-) Konferenzen zu Mass Customization and Personalization. Warum?
Large Language Models (LLM):One Size Fits All Wenn es um die bei der Anwendung von Künstlicher Intelligenz (GenAI) verwendeten Trainingsmodellen geht, stellt sich oft die Frage, ob ein großes Modell (LLM: Large Language Model) für alles geeignet ist – ganz im Sinne von “One size fits all”. Diese Einschätzung wird natürlich von den Tech-Unternehmen vertreten, die aktuell mit ihren Closed Source Models das große Geschäft machen, und auch für die Zukunft wittern. Die Argumentation ist, dass es nur eine Frage der Zeit ist, bis das jeweilige Large Language Model die noch fehlenden Features bereitstellt – bis hin zur großen Vision AGI: Artificial General Intelligence. Storytelling eben…
Small Language Models (SLM): Variantenvielfalt In der Zwischenzeit wird immer klarer, dass kleine Modelle (SLM) viel ressourcenschonender, in speziellen Bereichen genauer, und auch wirtschaftlicher sein können. Siehe dazu Künstliche Intelligenz: Vorteile von Small Language Models (SLMs) und Muddu Sudhakar (2024): Small Language Models (SLMs): The Next Frontier for the Enterprise, Forbes, LINK.
Komplexitätsfalle Es wird deutlich, dass es nicht darum geht, noch mehr Möglichkeiten zu schaffen, sondern ein KI-System für eine Organisation passgenau zu etablieren und weiterzuentwickeln. Dabei sind erste Schritte schon zu erkennen: Beispielsweise werden AI-Router vorgeschlagen, die verschiedene Modelle kombinieren – ganz im Sinne eines sehr einfachen Konfigurators. Siehe dazu Künstliche Intelligenz: Mit einem AI Router verschiedene Modelle kombinieren.
Mit Hilfe eines KI-Konfigurators könnte man sich der Komplexitätsfalle entziehen. Ein Konfigurator in einem definierten Lösungsraum (Fixed Solution Space) ist eben das zentrale Element von Mass Customization and Personalization.
Die Lösung könnte also sein, massenhaft individualisierte KI-Modelle und KI-Agents dezentralisiert für die Allgemeinheit zu schaffen. Am besten natürlich alles auf Open Source Basis – Open Source AI – und für alle in Repositories frei verfügbar. Auch dazu gibt es schon erste Ansätze, die sehr interessant sind. Siehe dazu beispielsweise (Mass) Personalized AI Agents für dezentralisierte KI-Modelle.
Genau diese Überlegungen erinnern – wie oben schon angedeutet – an die Hybride Wettbewerbsstrategie Mass Customization and Personalization. Die Entgrenzung des definierten Lösungsraum (Fixed Solution Space) hat dann weiter zu Open Innovation (Chesbrough und Eric von Hippel) geführt.
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
Es wird von Tag zu Tag deutlicher: Mit der zunehmenden Verbreitung von Künstlicher Intelligenz (AI: Artificial Intelligence) kommen die zentralen, großen KI-Modelle (Large Language Models) mit ihrem Mangel an Transparenz und ihrem „laxen“ Umgang mit dem Urheberrecht oder auch mit dem Datenschutz, an Grenzen.
Einzelne Personen, Organisationen und auch Öffentliche Verwaltungen halten ihre Daten entsprechend zurück, wodurch Kooperation, Kollaboration und letztendlich auch Innovation behindert wird. Der Trend von den LLM (Large Language Models), zu Small Language Models (SLM), zu KI-Agenten, zusammen mit dem Wunsch vieler auch die eigenen Daten – und damit die eigene Expertise – für KI-Anwendungen zu nutzen, führt zu immer individuelleren, customized, personalized Modellen und letztendlich zu Personalized AI-Agents.
„Personal agents: Recent progress in foundation models is enabling personalized AI agents (assistants, co-pilots, etc.). These agents require secure access to private user data, and a comprehensive understanding of preferences. Scaling such a system to population levels requires orchestrating billions of agents. A decentralized framework is needed to achieve this without creating a surveillance state“ (Singh et al. 2024).
Forscher am Massachusetts Institute of Technology (MIT) haben diese Entwicklungen systematisch analysiert und sind zu dem Schluss gekommen, dass es erforderlich ist, Künstliche Intelligenz zu dezentralisieren: Decentralized AI.
Mein Wunsch wäre es in dem Zusammenhang, dass alle Anwendungen (Apps, Tools etc.) einzelnen Personen und Organisationen als Open Source zur Verfügung stehen, ganz im Sinne von Mass Personalization – nur dass Mass Personalization für KI-Agenten nicht von Unternehmen ausgeht und auf den Konsumenten ausgerichtet ist! Das hätte eine sehr starke Dynamik von Innovationen zur Folge, die Bottom Up erfolgen und die Bedürfnisse der Menschen stärker berücksichtigen.
Im Zusammenhang mit Künstlicher Intelligenz könnte man natürlich auch über eine Art Künstliche Dummheit nachdenken. Wie schon länger bekannt, stellen beispielsweise Halluzinationen und falsche Antworten ein nicht zu vernachlässigendes Phänomen dar. Darüber hinaus gibt es allerdings auch noch eine Art Bullshit-Faktor. Es geht dabei um die Missachtung der Wahrheit in großen Sprachmodellen. Genau diesen Aspekt haben sich verschiedene Forscher der Princeton University einmal genauer angesehen und ein interessantes Paper dazu veröffentlicht:
Liang et al. (2025): Machine Bullshit: Characterizing the Emergent Disregard for Truth in Large Language Models | PDF
Es stellt sich hier natürlich die Frage, wie sich Halluzination und der genannte Bullshit-Faktor unterscheiden. Dazu habe ich folgendes gefunden:
„Daher gebe es auch einen entscheidenden Unterschied zwischen Halluzinationen und dem, was er als „Bullshit“ bezeichnet – und der liegt in der internen Überzeugung des Systems. Wenn ein Sprachmodell halluziniert, ist es nicht mehr in der Lage, korrekte Antworten zu erzeugen. „Beim Bullshit hingegen ist das Problem nicht Verwirrung über die Wahrheit, sondern eine fehlende Verpflichtung, die Wahrheit zu berichten“ (t3n vom 21.08.2025).
Interessant finde ich, dass die Forscher wohl auch eine erste Möglichkeit gefunden haben, um diesen Bullshit-Faktor zu überprüfen. Gut wäre es natürlich, wenn die Ergebnisse dann allen zur Verfügung stehen würden. Gespannt bin ich besonders darauf, wie Open Source AI Modelle abschneiden.
Conceptual technology illustration of artificial intelligence. Abstract futuristic background
KI-Anwendungen basieren oft auf Trainingsdaten, sogenannter Large Language Models (LLM). Um die Leistungsfähigkeit und die Qualität der Antworten von solchen Systemen zu verbessern, wurde inzwischen ein „Denkprozess“ (Reasoning) vor der Ausgabe der Antwort vorgeschaltet. Siehe dazu ausführlicher What are Large Reasoning Models (LRMs)?
Die Frage stellt sich natürlich: Liefern LRMs wirklich bessere Ergebnisse als LLMs?
In einem von Apple-Mitarbeitern veröffentlichten, viel beachteten Paper wurde nun die Leistungsfähigkeit nicht aufgrund logisch-mathematischer Zusammenhänge alleine untersucht, sondern anhand von drei Komplexitätskategorien – mit überraschenden Ergebnissen:
„Recent generations of language models have introduced Large Reasoning Models (LRMs) that generate detailed thinking processes before providing answers.. (…) By comparing LRMs with their standard LLM counterparts under same inference compute, we identify three performance regimes: (1) low-complexity tasks where standard models outperform LRMs, (2) medium-complexity tasks where LRMs demonstrates advantage, and (3) high-complexity tasks where both models face complete collapse“
Source: Shojaee et al. (2025): The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity.
In Zukunft werden immer mehr hoch-komplexe Problemlösungen in den Mittelpunkt von Arbeit rücken. Gerade in diesem Bereich scheinen LLMs und sogar LRMs allerdings ihre Schwierigkeiten zu haben. Ehrlich gesagt, wundert mich das jetzt nicht so sehr. Mich wundert eher, dass das genannte Paper die KI-Welt so aufgewühlt hat 🙂 Siehe dazu auch Was sind eigentlich Multi-Kontext-Probleme?
Sicher werden die Tech-Unternehmen der KI-Branche jetzt argumentieren, dass die nächsten KI-Modelle auch diese Schwierigkeiten meistern werden. Das erinnert mich an unseren Mercedes-Händler, der ähnlich argumentierte, sobald wir ihn auf die Schwachstellen des eingebauten Navigationssystems hingewiesen hatten: Im nächsten Modell ist alles besser.
Technologiegetriebene Unternehmen – insbesondere KI-Unternehmen – müssen wohl so argumentieren, und die Lösungen in die Zukunft projizieren – Storytelling eben, es geht immerhin um sehr viel Geld. Man muss also daran glauben….. oder auch nicht.
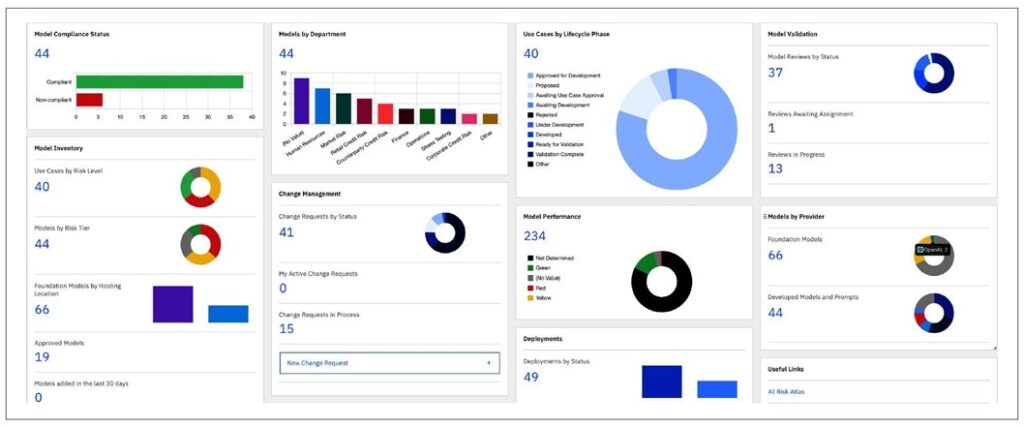
Using watsonx.governance to build a dashboard and track a multimodel deployment environment (Thomas et al. 2025)
In verschiedenen Beiträgen hatte ich beschrieben, was eine Organisation machen kann, um KI-Modelle sinnvoll einzusetzen. An dieser Stelle möchte ich nur einige wenige Punkte beispielhaft dazu aufzählen.
Das sind nur einige Beispiele dafür, dass eine Organisation aufpassen muss, dass die vielen Aktivitäten sinnvoll und wirtschaftlich bleiben. Doch: Wie können Sie das ganze KI-System verfolgen und verbessern? In der Abbildung sehen Sie ein Dashboard, dass den Stand eines KI-Frameworks abbildet. Die Autoren haben dafür IBM watsonx Governance genutzt.
„Our dashboard gives us a quick view of our environment. There are LLMs from OpenAI, IBM, Meta, and other models that are in a review state. In our example, we have five noncompliant models that need our attention. Other widgets define use cases, risk tiers, hosting locations (on premises or at a hyper scaler), departmental use (great idea for chargebacks), position in the approval lifecycle, and more“ (Thomas et al. 2025).
Die Entwicklungen im Bereich der Künstlichen Intelligenz sind vielversprechend und in ihrer Dynamik teilweise auch etwas unübersichtlich. Das geeignete KI-Framework zu finden, es zu entwickeln, zu tracken und zu verbessern wird in Zukunft eine wichtige Aufgabe sein.
AI (Artificial intelligence) AI management and support technology in the Business plan marketing success customer. AI management concept.
Wenn es um die bei der Anwendung von Künstlicher Intelligenz (GenAI) verwendeten Trainingsmodellen geht, stellt sich oft die Frage, ob ein großes Modell (LLM: Large Language Model) für alles geeignet ist – ganz im Sinne von „One size fits all“. Eine andere Herangehensweise ist, mehrere spezialisierte kleinere Trainingsmodelle (SLM: Small Language Models) zu verwenden, die verschiedene Vorteile bieten.
„In January of 2025, the MoE architecture got broad attention when DeepSeek released its 671 billion MoE model. But DeepSeek wasn’t the first to release an MoE model. The French AI Lab, Mistral AI, made headlines with the release of one of the first high-performing MoE models: Mixtral 8x7B (we think the name is great, Mistral + mixture) all the way back in December of 2023″ (Thomas et al. 2025).
Doch es gibt einen Unterschied: Bei dem Konzept eines AI-Routers, sind es verschiedene Modelle (LLM, SLM), die für den jeweiligen Input ausgewählt werden. Bei einer Mixture of Experts (MoE) Architektur ist das prinzipielle Vorgehen zwar ähnlich, doch es sind hier speziell trainierte Modelle mit Expertenstatus, die dann zur Auswahl stehen.
Es zeigt sich in solchen Beiträgen immer mehr, dass ein Unternehmen ein dynamisches, eigenes KI-System konfigurieren sollte, damit die Möglichkeiten der Künstlichen Intelligenz genau zu den Anforderungen und dem Kontext passt.
Trainingsmodelle sind für die Qualität der Ergebnisse von KI-Abfragen bedeutend. Dabei kann es sich im einfachsten Fall um ein Large Language Model (LLM) handeln – ganz im Sinne von „One Size Fits All, oder auch um verschiedene, spezialisierte Small Language Models (SLMs). Alles kann dann auch mit Hilfe eines AI-Routers sinnvoll kombiniert werden. Darüber hinaus ist es auch möglich, bestehende Modelle über InstructLab mit eigenen Daten zu kombinieren und zu trainieren.
Noch weiter geht jetzt Ai2, eine Not for Profit Organisation, über die ich schon einmal geschrieben hatte (Blogbeitrag). Mit FlexOlmo steht nun über Ai2 ein Trainingsmodell zur Verfügung, bei dem die Daten flexibel von einer Community weiterentwickelt / trainiert werden können:
„The core idea is to allow each data owner to locally branch from a shared public model, add an expert trained on their data locally, and contribute this expert module back to the shared model. FlexOlmo opens the door to a new paradigm of collaborative AI development. Data owners who want to contribute to the open, shared language model ecosystem but are hesitant to share raw data or commit permanently can now participate on their own terms“ (Ai2 2025).
Die Idee ist wirklich spannend, da sie auf einem offenen Trainingsmodell basiert – ganz im Sinne von Open Source AI – und die Eigentümer der Daten darüber entscheiden, ob ihre Daten von dem gemeinsamen Modell genutzt werden können, oder eben nicht. Wer noch tiefer in diese Idee einsteigen möchte, kann das mit folgendem Paper gerne machen:
Shi et al (2025): FLEXOLMO: Open Language Models for Flexible Data Use | PDF
Manchmal könnte man der Meinung sein, dass es kaum noch Möglichkeiten gibt, etwas Neues auf den Markt zu bringen, doch das ist natürlich ein Trugschluss. Beispielhaft möchte ich dazu folgendes Zitat erwähnen:
„Es gibt nichts Neues mehr. Alles, was man erfinden kann, ist schon erfunden worden. „ Charles H. Duell, US-Patentamt 1899
Da stellt sich natürlich gleich die Frage: Wo sind die neuen Produkte, neuen Dienstleistungen, neuen Märkte, und wie finde ich diese?
Dass das nicht so einfach ist, haben Innovationstheorien und -modelle schon ausführlich dargestellt. Dabei hat sich der Begriff der „blinden Flecke“ etabliert. Gerade große Organisationen sehen einfach nicht mehr das Offensichtliche. Diese Wahrnehmungshemmung kann mit der Theorie der Pfadabhängigkeit erklärt werden.
Diese Gemengelage führt zwangsläufig zur nächsten Frage: Wie kann ein Unternehmen (oder auch eine einzelne Person) Bereiche finden, die noch nicht besetzt sind?
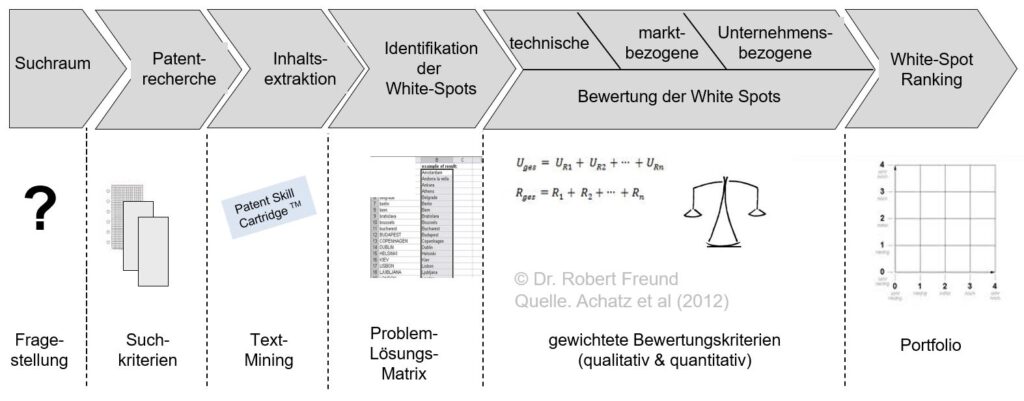
Solche weiße Flecken – White Spots – können relativ systematisch mit einem entsprechenden Prozess abgebildet und untersucht werden (Abbildung). Mit den heute vorhandenen Möglichkeiten der Künstlichen Intelligenz (GenAI) können Sie
In vielen Blogbeiträgen habe ich darauf hingewiesen, dass es kritisch ist, Closed Sourced Modelle für KI-Anwendungen (GenAI) zu nutzen. Die hinterlegten Trainingsdaten können kritisch sein und auch das Hochladen eigener Daten sollte bei diesen Modellen möglichst nicht erfolgen. Siehe dazu Open Source AI: Besser für einzelne Personen, Organisationen und demokratische Gesellschaften.
In der Zwischenzeit ist es mit Hilfe vonInstructLab möglich, vorhandene LLMs mit eigenen Daten zu trainieren. Dabei handelt sich um eine Initiative von Redhat und IBM – weiterführende Informationen dazu finden Sie bei Hugging Fcae.
Wie funktioniert InstructLab? Das Prinzip ist relativ einfach: Ein bestehendes Modell (LLM) wird mit Hilfe von InstructLab und eigenen Daten erweitert, spezifiziert und trainiert – alles unter eigener Kontrolle und Open Source.
„InstructLab can augment models though skill recipes used to generate synthetik data for tuning. Experiments can be run locally on quantized version of these models“ (InstructLab-Website).
In einem ausführlichen, deutschsprachigen artikel erklärt Redhat noch einmal die Zusammenhänge: „Unternehmen können die InstructLab-Tools zum Modellabgleich auch nutzen, um ihre eigenen privaten LLMs mit ihren Kompetenzen und ihrem Fachwissen zu trainieren“ (Redhat vom 10.03.2025).
Es ist für mich entscheidend, dass diese Initiative Open Source basiert, nicht auf bestimmte Modelle beschränkt, und lokal angewendet werden kann.
Diese Website benutzt Cookies. Wenn du die Website weiter nutzt, gehen wir von deinem Einverständnis aus.