Wenn wir mit Künstlicher Intelligenz arbeiten, interagieren wir mit Large Language Models (LLMs), die mit Daten trainiert und weiterentwickelt wurden. Die Antworten erscheinen uns menschlich zu sein, da sie meistens zu dem passen, was wir uns in unserer Kultur vorstellen.
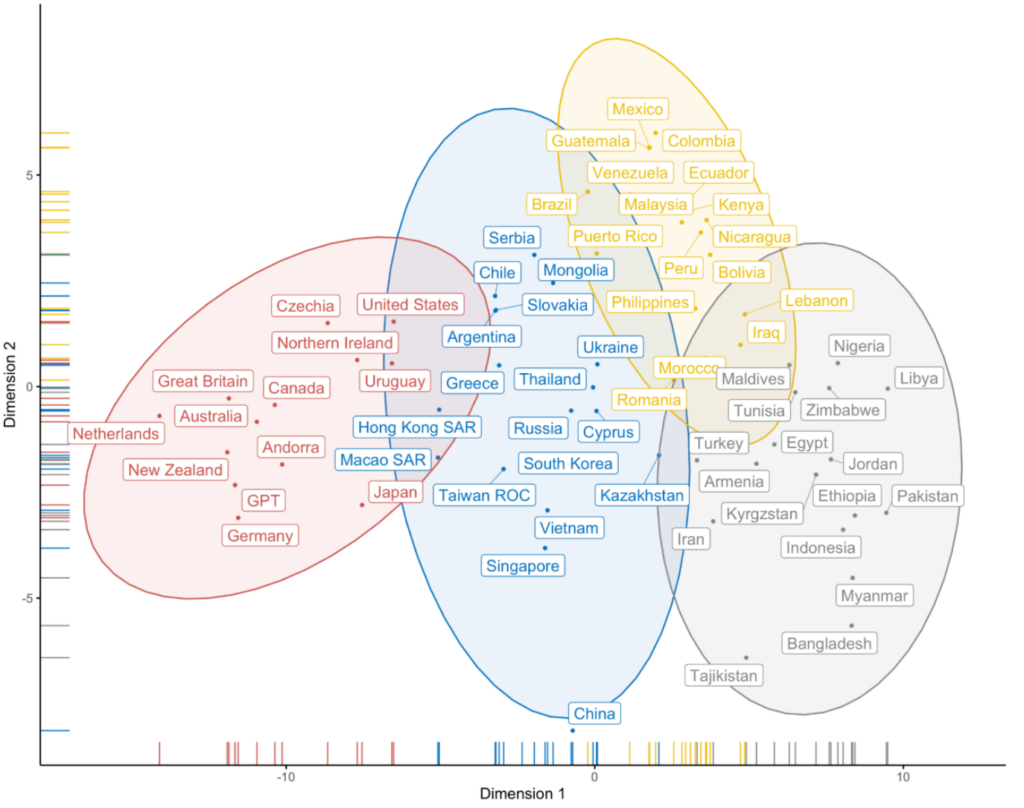
In dem Paper Atari et al. (2023): Which Human? gehen die Forscher der Frage nach, um welchen Menschen – um welches Menschenbild – es sich hierbei handelt. Dabei haben sie festgestellt, dass die bekannten KI-Modelle eine WIRED-Perspektive einnehmen. WEIRD populations (Western, Educated, Industrialized, Rich, and Democratic).
Wie in der Abbildung zu erkennen, haben allerdings viele Kulturkreise, Regionen, Länder ein anderes Menschenbild, das sich von dem genannten WEIRD erheblich unterscheidet. Das wiederum führt zu der Frage, ob die anderen Regionen dieser Welt die von westlichen Big Tech entwickelten LLMs übernehmen werden, oder sie ihre eigenen LLMs benötigen, die ihre eigene Sprache, ihre kulturellen und regionalen Besonderheiten berücksichtigen.
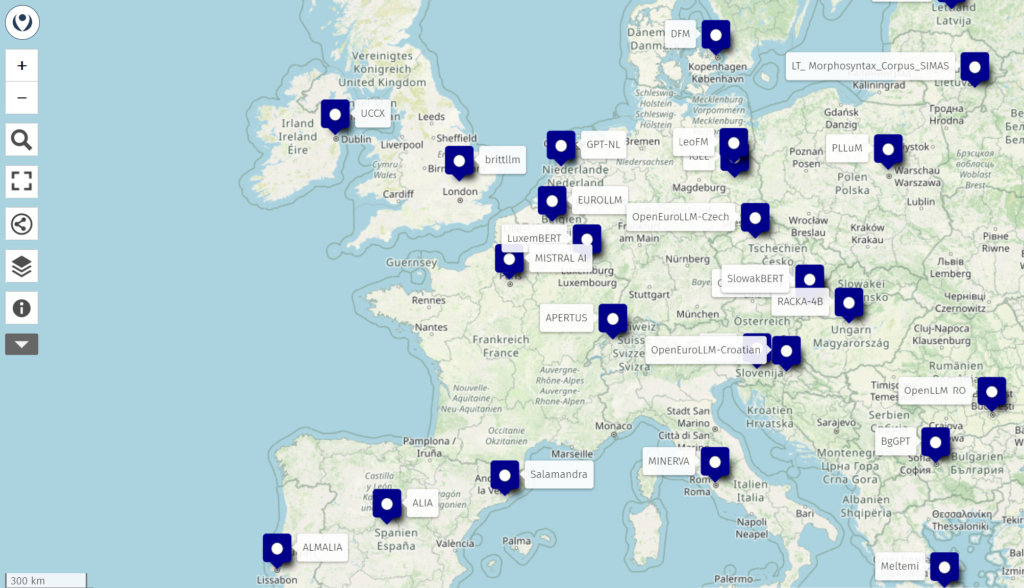
Nach dem AI Report 2026 (Stanford University) gibt es in der Zwischenzeit einen deutlichen Trend in Richtung regionaler/nationaler LLMs, die gerade das ermöglichen. Wie ich in der von mir erstellten Open Street Map zu EU-Modellen zeigen konnte, gibt es sogar in Europa schon sehr viele solcher Modelle auf Open Source oder Open Weight Basis.
Solche Zusammenhänge habe ich auch in meinem Paper Digital Sovereignty and Open-Source AI: The European Way for Innovative SMEs auf der MCP 2026 in Balatonfüred, Ungarn aufgezeigt.

Copyright © 2026. All Rights Reserved.